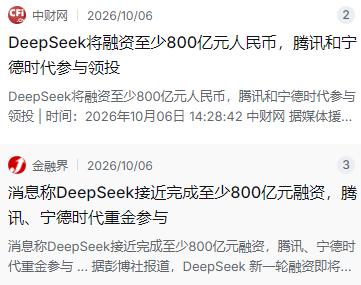
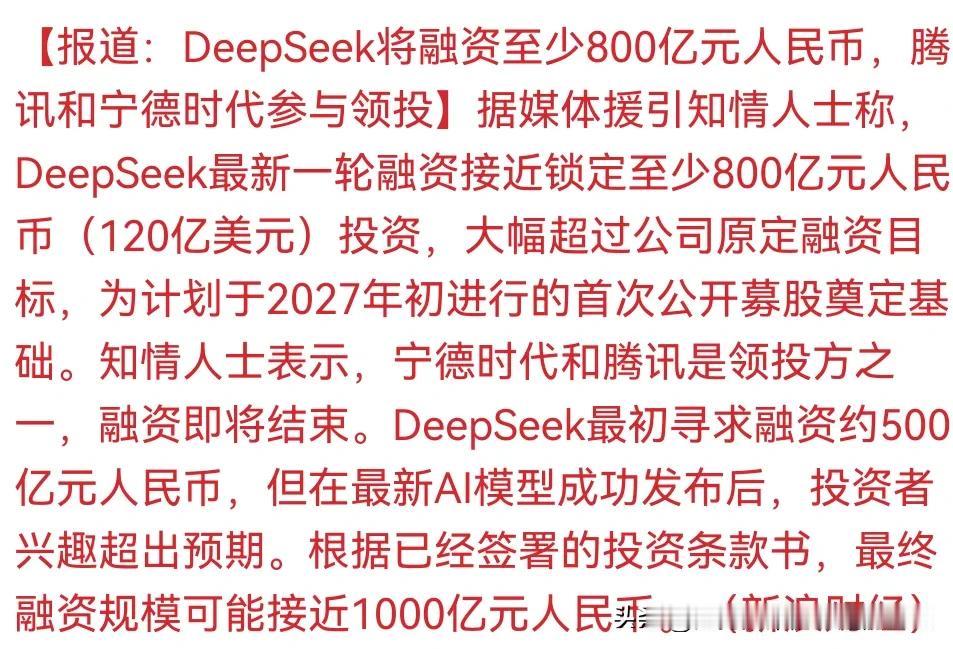
DeepSeek这轮融资,已经不太像普通融资。原本计划500亿元,结果被排队送钱的机构挤爆门槛。最新一轮至少冲到800亿元,约120亿美元;按已经签下的条款清单看,最终规模摸到1000亿元也不意外。领投名单是腾讯和宁德时代,一个握流量入口,一个握能源储能。
放在一起看,味道就出来了:这不是简单财务投资,而是中国AI基础设施里两个关键环节同时下注。
腾讯上一轮已经出资100亿元,这一轮继续加码。原因不复杂。腾讯元宝日活超5000万、月活1.14亿,产品线对底层模型依赖越来越重。
把顶级模型能力接进自家生态,等于给全线业务买一张底座票。微信、游戏、广告、云、办公,哪一块都离不开模型能力,腾讯不可能只做应用层,它需要把底座抓在手里。
宁德时代出现,戏剧性更强。硅谷总说AI尽头是电力,甚至去研究核电站。中国市场直接把电池巨头和算力玩家放到一张桌上。
宁德时代有能源和储能底牌,DeepSeek有极致算力效率。电力大约占数据中心运营总成本五六成,宁德时代能通过储能峰谷套利降电费,做绿电直供和备用电源,还能帮DeepSeek在各地拿能耗指标、谈电价。
这些是电池厂独有的政府关系和能源网络资源。再往深看,宁德时代今年在AI能源基础设施上连续落子:入股中恒电气,掌握高压直流供电设备;入股世纪互联,锁定IDC机房运营资源;现在投DeepSeek,锁定大客户。
三笔连起来,就是“绿电—储能—配电—算力”的闭环。放到全球科技界,这笔融资也很扎眼。硅谷大佬一年烧掉数百亿美元,打的是大力出奇迹的富豪牌。
DeepSeek靠开源和极致性价比,硬生生砸开一条高效率新路。资本看懂的逻辑是:能把算力成本打成“自来水价格”的人,才是未来最值钱的基建地主。所以它不再被当成低价平替,而是在被重新定价为中国AI基础设施资产。
资本为什么敢给DeepSeek开5000亿元目标估值?因为它做的事,早超出模型公司范围。最新V4 Flash采用混合专家架构,总参数2840亿,激活参数仅130亿,支持100万token上下文,多项评测成绩突出。但让资本兴奋的不是跑分,而是国产算力闭环。
DeepSeek计划在内蒙古乌兰察布建大型数据中心,部署至少16万颗华为昇腾950DT芯片。如果落地,这会是目前已知规模最大的华为AI芯片集群之一。
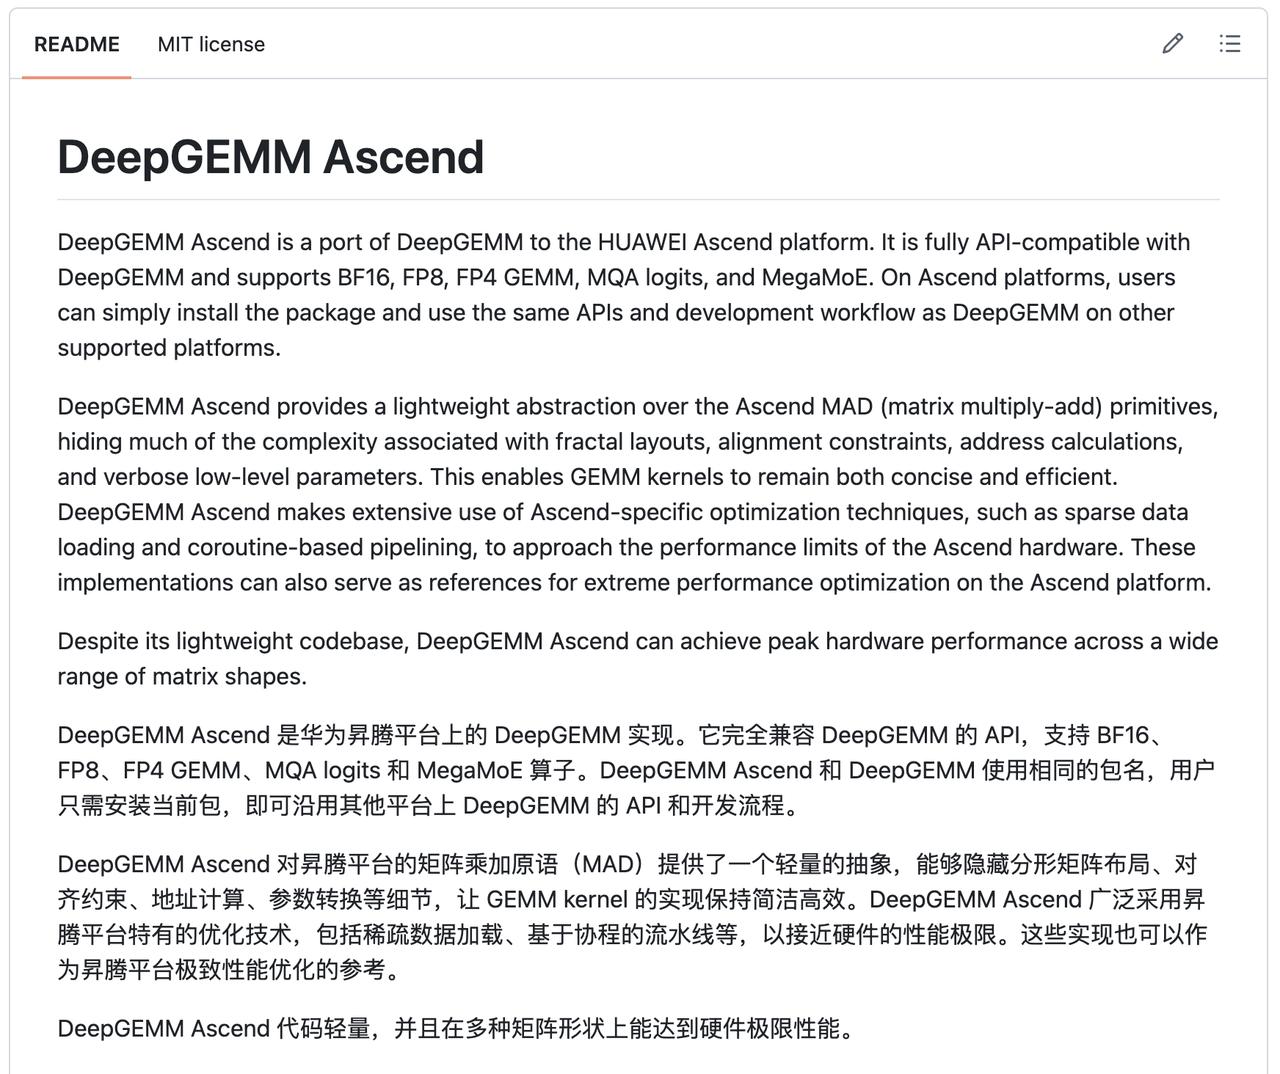
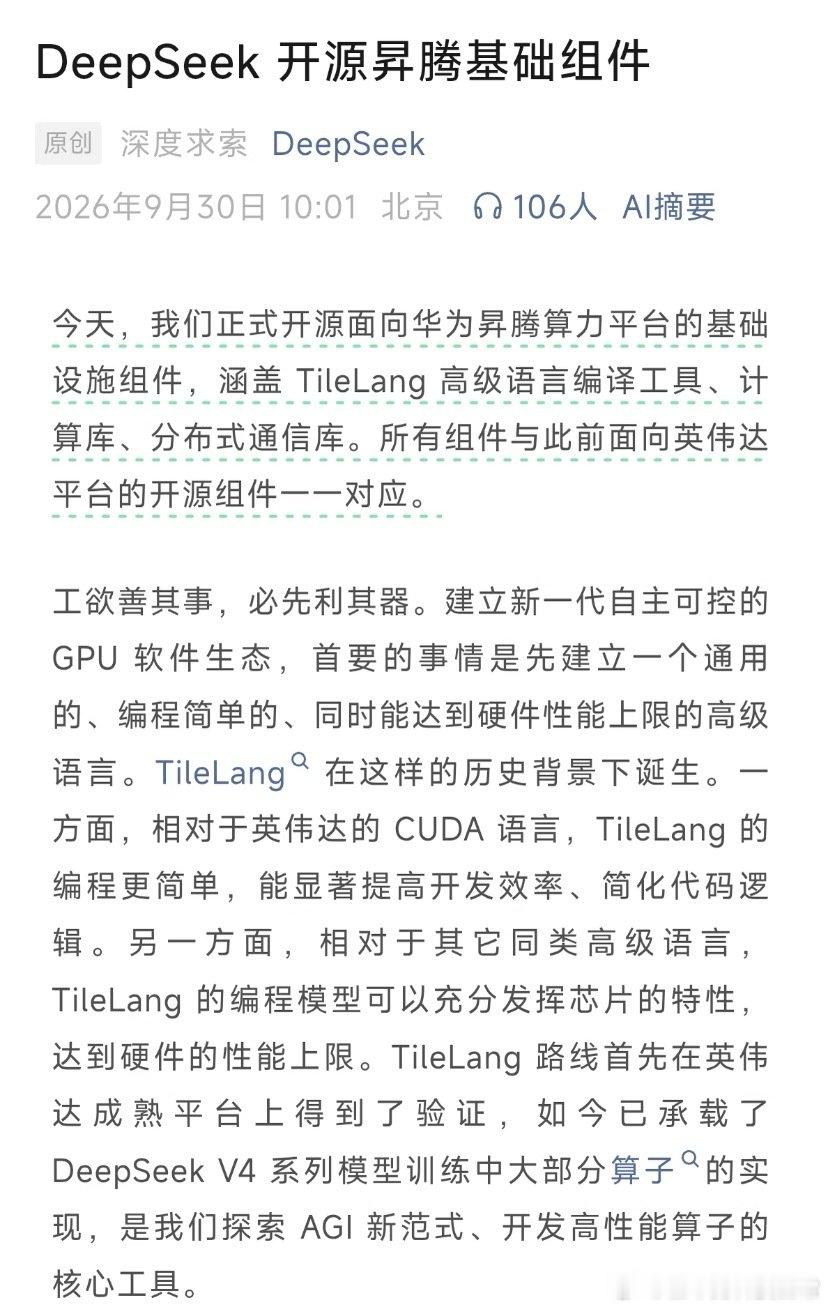
同时,DeepSeek已开源面向华为昇腾算力平台的全套基础设施组件,包括编译工具、计算库和分布式通信库,与面向英伟达平台的开源组件一一对应。它正从依赖美国半导体,转向国产AI芯片全栈部署。这件事的战略意义,比融资规模更大。
因为芯片供应一旦被卡,模型能力再强也要落空;而昇腾生态如果被DeepSeek这种头部玩家带动,开发者迁移成本会迅速下降。
横向看,智谱三个月内完成700亿港元配售与可转债组合融资,已经刷新中国AI累计融资纪录。DeepSeek这轮完成后,势必再超智谱,成为中国融资规模最大的人工智能大模型企业。
9月末,前高瓴创投合伙人严文韬加入DeepSeek出任CFO,IPO筹备加速。知情人士称,DeepSeek计划2027年初首次公开募股,本轮融资就是为上市铺路。
宏观背景也在推着资本往前走。字节、阿里、腾讯、百度四家资本开支,从2024年350亿美元升到2025年超过500亿美元,2026年预计达到1000亿美元。
2008年4万亿元投的是高铁、高速公路、机场;2026年7万亿元投的是算力网。在这个背景下,DeepSeek被重新定价,反映的不是一家公司的估值故事,而是中国资本市场开始给AI基础设施层定价。
腾讯代表流量和产品生态入口,宁德时代代表能源和储能底座,华为代表芯片和算力自主化。三者围绕DeepSeek形成的组合,是一张完整的中国AI基础设施图谱。
硅谷还在讨论谁的模型跑分更高,中国资本已经在用真金白银回答更根本的问题:未来AI竞争,拼的不是单个模型能力,而是从芯片到算力、能源到应用的全链条效率。
所以,DeepSeek被资本抢着送钱,真正原因不是它便宜,而是它便宜背后的全栈能力,刚好踩在中国AI产业最需要的位置上。融资数字只是表面,真正被定价的,是中国AI从模型、算力到能源的一整套底层能力。