中国有句老话说得好:真正的生意人,都是懂得“细水长流”这个道理的。
DeepSeek又融钱了。至少800亿,腾讯、宁德时代领投。原计划500亿,结果抢的人太多,可能要冲到1000亿。
此前梁文锋说了一句话,比融资更值得琢磨:不急着赚钱,最强模型大概率还会开源。
一边是资本争着进场,一边是创始人不急着把技术锁起来收费。这两件事放到一起,恰恰能看出DeepSeek的生意经:先把技术做强,让更多人用起来,再靠效率和服务获得收入。
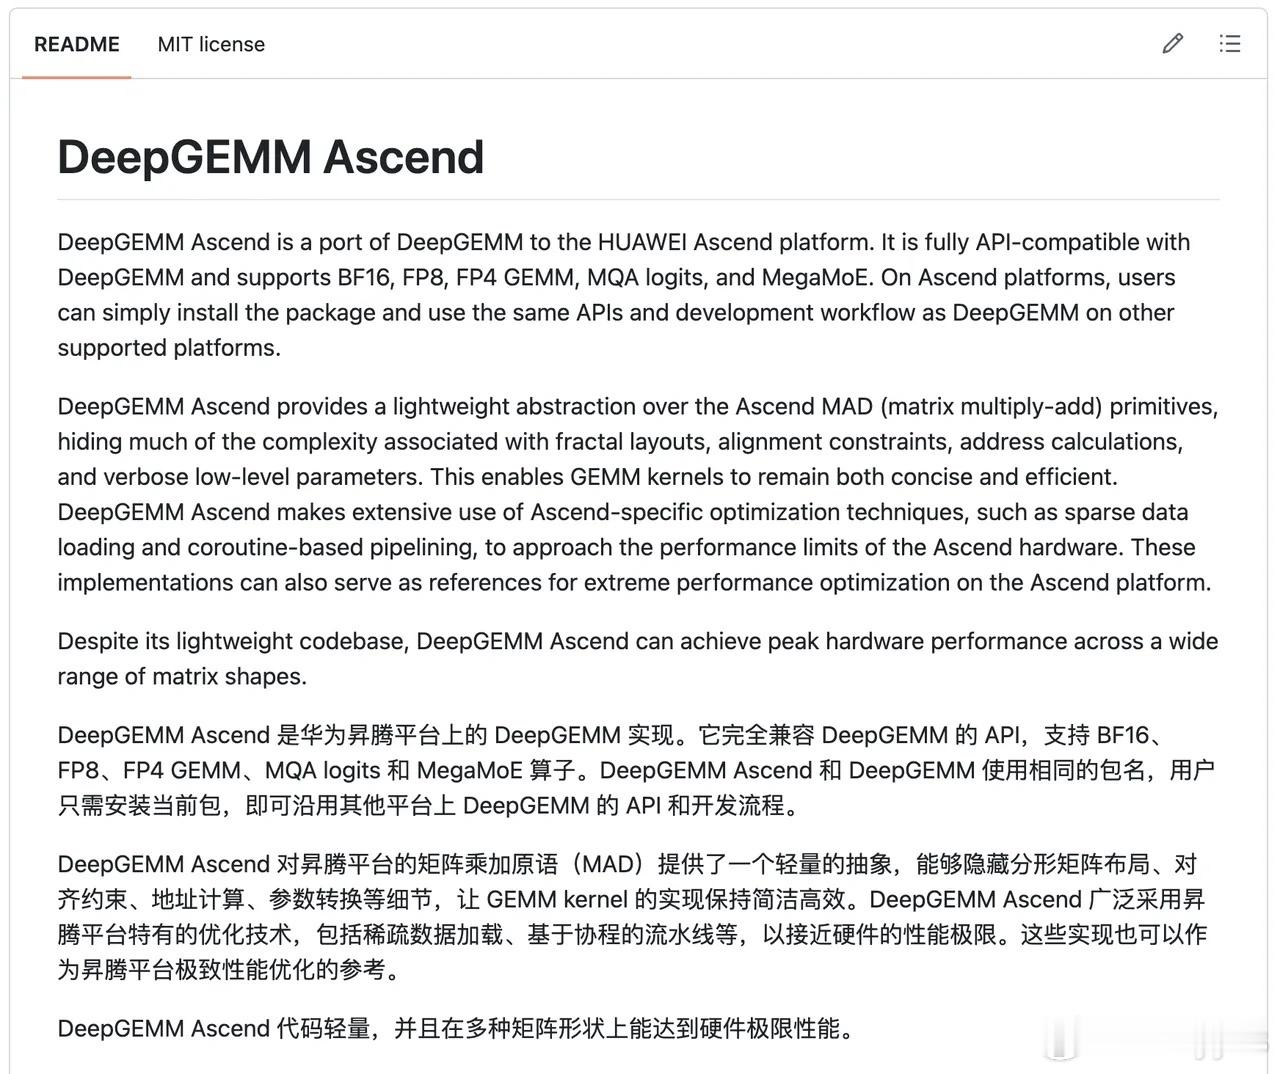
把时间拨回2025年1月20日,DeepSeek发布R1,同时开放模型权重。它还做了一件很实在的事:采用宽松的MIT许可证,不限制商用,无需专门申请。
对普通读者来说,这意味着什么?就像有人做出一台好用的机器,允许别人把它搬回去,按自己的需要改造,还能拿它做生意。企业可以在自己的服务器上运行模型,也可以围绕它开发产品。
DeepSeek当时还放出了六个经过“蒸馏”的小模型。所谓蒸馏,就是让小模型学习大模型的回答和能力,尽量用更少的资源完成任务。小团队不必人人都去承担最大模型的运行成本,也能找到适合自己的技术起点。
这一步,打开的是一扇门。过去想做人工智能应用,光是开发基础模型,就可能把一家小公司的钱耗光。现在可以借助现成的模型,把精力放在具体问题上:客服怎样答得准,合同怎样查得快,办公流程怎样少走几道手续。
变化很快进入了真实业务。江苏银行把DeepSeek用于合同质检和自动化估值对账;汇添富基金把它引入投资研究、风险控制。人工智能的价值,由此落到了查资料、核数据、处理文件这些日常工作里。
这也是开源最容易被误解的地方。很多人觉得,把技术交出去,别人都能用,自己的饭碗岂不是被端走了?
可模型能够下载,和模型能够稳定、便宜地运行,中间还隔着设备、用电、维护和技术人员。就像菜谱可以公开,饭店仍然能挣钱,因为顾客买的是方便、口味和稳定的服务。
企业也是如此。有实力、有特殊需求的,可以自己部署;希望省事的,可以付费调用DeepSeek的服务。这里的API,理解成软件之间的服务接口就行:自己的程序提出请求,模型处理完,再把答案送回来。
这样一来,开源和收费就能并行。前者让更多人获得技术,后者让需要现成服务的人按使用量付钱。真正要比拼的,是同样完成一项任务,谁的成本更低、速度更快、结果更可靠。
梁文锋在今年5月的投资者交流中,谈过一个定价思路:买一批设备回来,大约十个月收回设备成本。他追求的是自己认可的合理回报,并不把每一次涨价机会都用足。
这里有个关键细节:收回设备成本,是他的定价参照。研发、人员、其他运营支出,仍然需要承担。愿意让利的前提,是公司有能力控制成本,并且持续做出有人愿意用的产品。
于是,大笔融资的意义也变得清楚了。技术公司做长久生意,需要足够的资金支持试验。有些研究今天看不到收入,却可能决定下一代模型的能力;一次训练失败了,资金和时间照样已经花出去。
模型效率提高,也不等于从此不需要投入。服务的用户多了,使用频率高了,设备、网络和供电的需求都会增加。单次任务省钱,与整体业务需要更多资金,完全可以同时发生。
腾讯和宁德时代受到关注,也因为它们分别连接着互联网服务和制造业。对这类企业而言,人工智能的潜在价值,可以落在云服务、研发、生产和管理等多个环节。这是理解产业资本兴趣的一个角度,具体合作仍要看实际落地。
开源则让合作的门槛降低。模型企业提供基础能力,应用企业理解客户需求,硬件企业改善运行条件。各家把自己擅长的那一段做好,才有机会让人工智能从聊天工具变成日常工作里的帮手。
这条路,也与国内正在推进的开源建设相呼应。今年6月,工信部提出支持优秀开源产品落地应用,探索开源商业模式创新,推动社区代码转化为商业产品。技术分享与商业回报,可以在同一条路上实现。
当然,钱多了,考验也会跟着来。研发需要耐心,投资者期待回报;模型要不断进步,服务也要经得住大量用户使用。怎样在这些要求之间安排资源,比融资数字本身更能决定一家公司的未来。
对于普通人,最值得关心的,是人工智能能否越来越好用、越来越用得起。一个小商家能少花时间整理订单,一个创业团队能少花钱开发产品,这些具体变化,才是技术普及的分量。
“细水长流”放在DeepSeek身上,就是把合理收入、持续研发和广泛使用连起来。让更多人愿意使用,让合作伙伴有空间挣钱,再把收入投入下一轮改进,生意才能越做越长。
融资带来的是继续往前走的条件,开源带来的是更多人一起参与的机会。DeepSeek接下来能走多远,要看它能否持续拿出好模型,并把这种开放的选择做成可持续的生意。