Token要爆了,算力真正要拼的可能不是“堆机器”
中科曙光最近在研究“怎么少算一点”。市场现在面对的问题,已经不是有没有算力,而是这么多Token涌进来以后,怎么算得更划算。
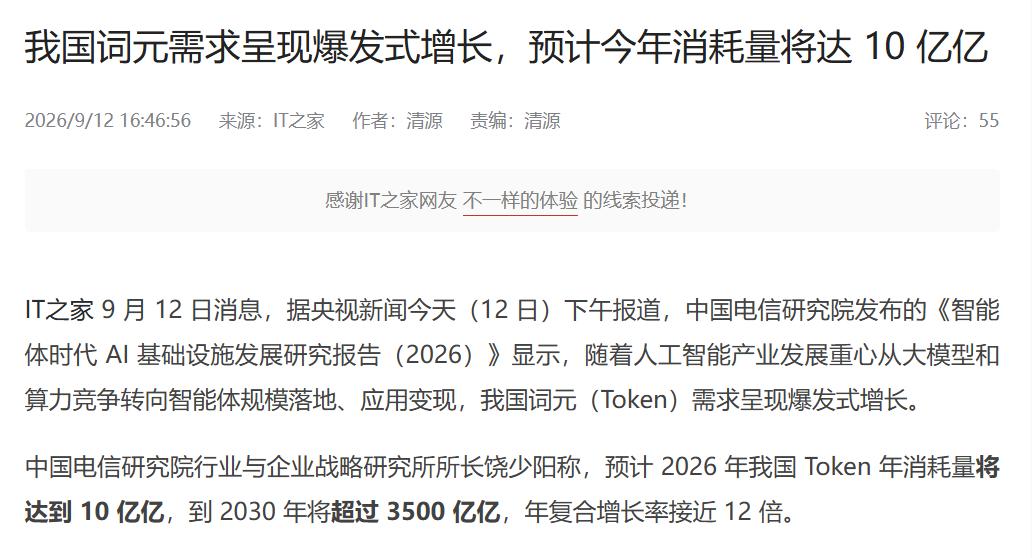
中国电信研究院预计,今年国内Token消耗量将达到10亿亿,到2029年推理算力市场占比可能达到80%。这意味着AI下一阶段最大的压力,很可能不是训练一个更大的模型,而是每天几亿人、几千万个智能体不停调用模型。
所以再看曙光前段时间发布的ParaCache,思路其实挺朴素:长文本、多轮对话里很多内容明明已经算过,就把结果存下来,下次直接复用,别让机器重复干活。约12万Token输入下,首Token等待时间最高能降98.5%。
以前大家谈AI基础设施,习惯比谁的集群更大。以后可能还要多问一句:同样一批机器,到底能吐出多少有效Token。
从这个角度看,中科曙光现在开始抓“算力效率”,我觉得比单纯继续堆参数更值得关注。
中科曙光 ParaCache Token 人工智能 AI推理