标签: 编程
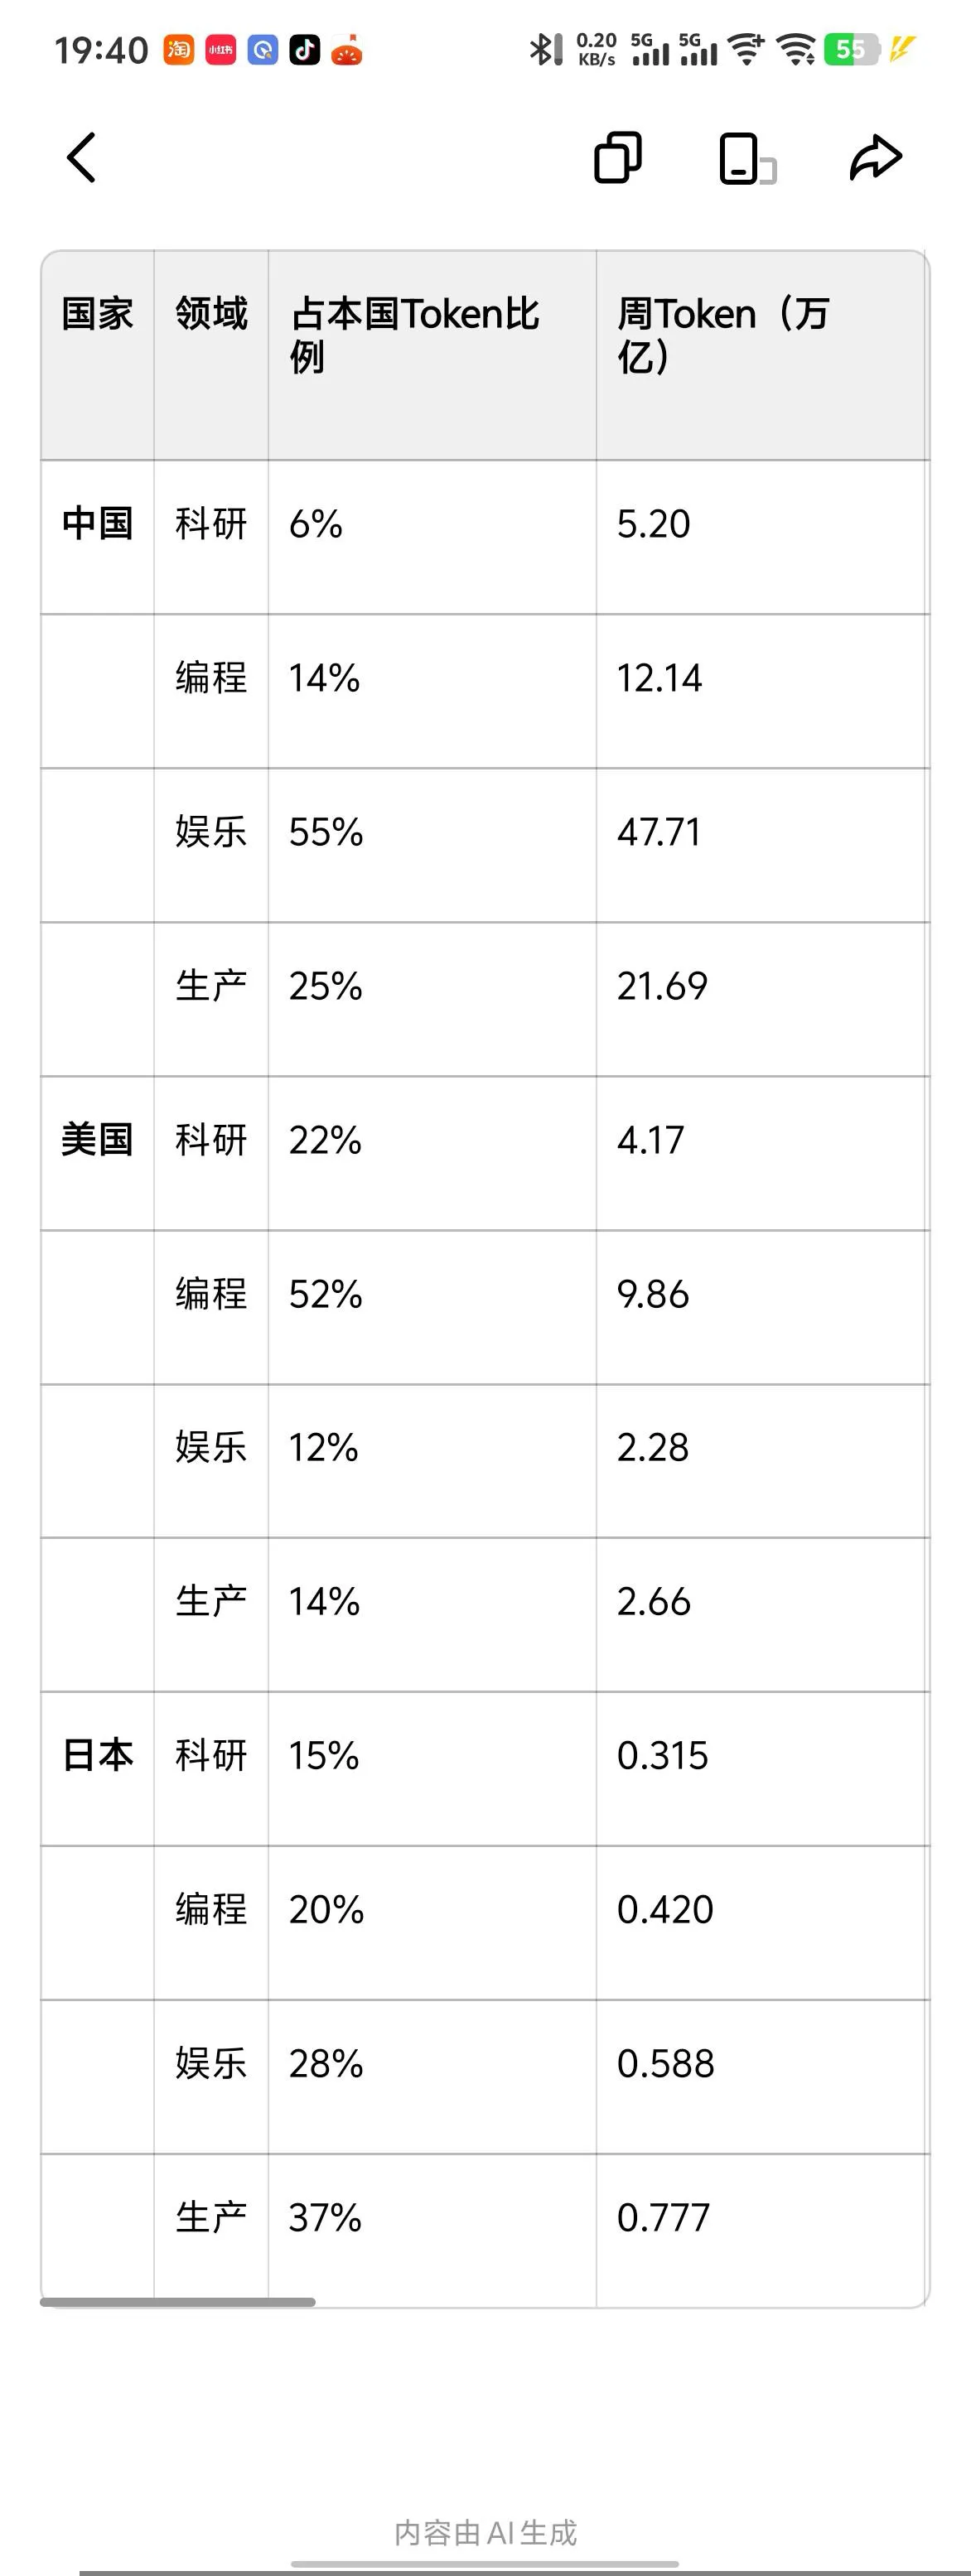
这复图是中美AI词元使用情况的对比图,本子就自动忽略了吧,看本子的没有意义它太少了。大家要知道今年以
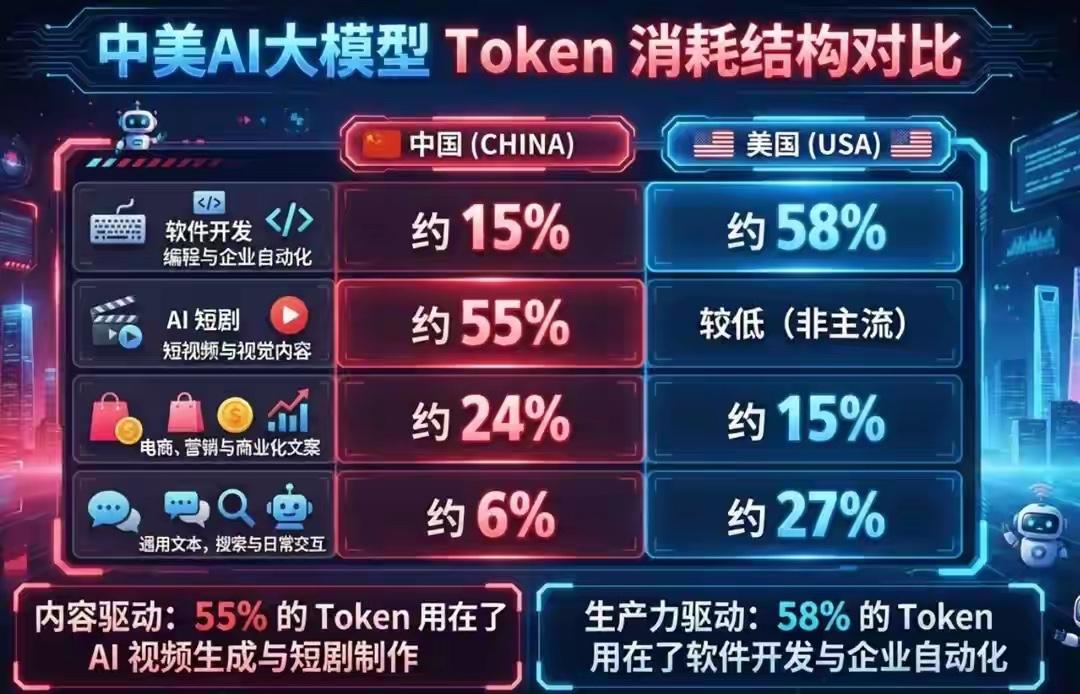
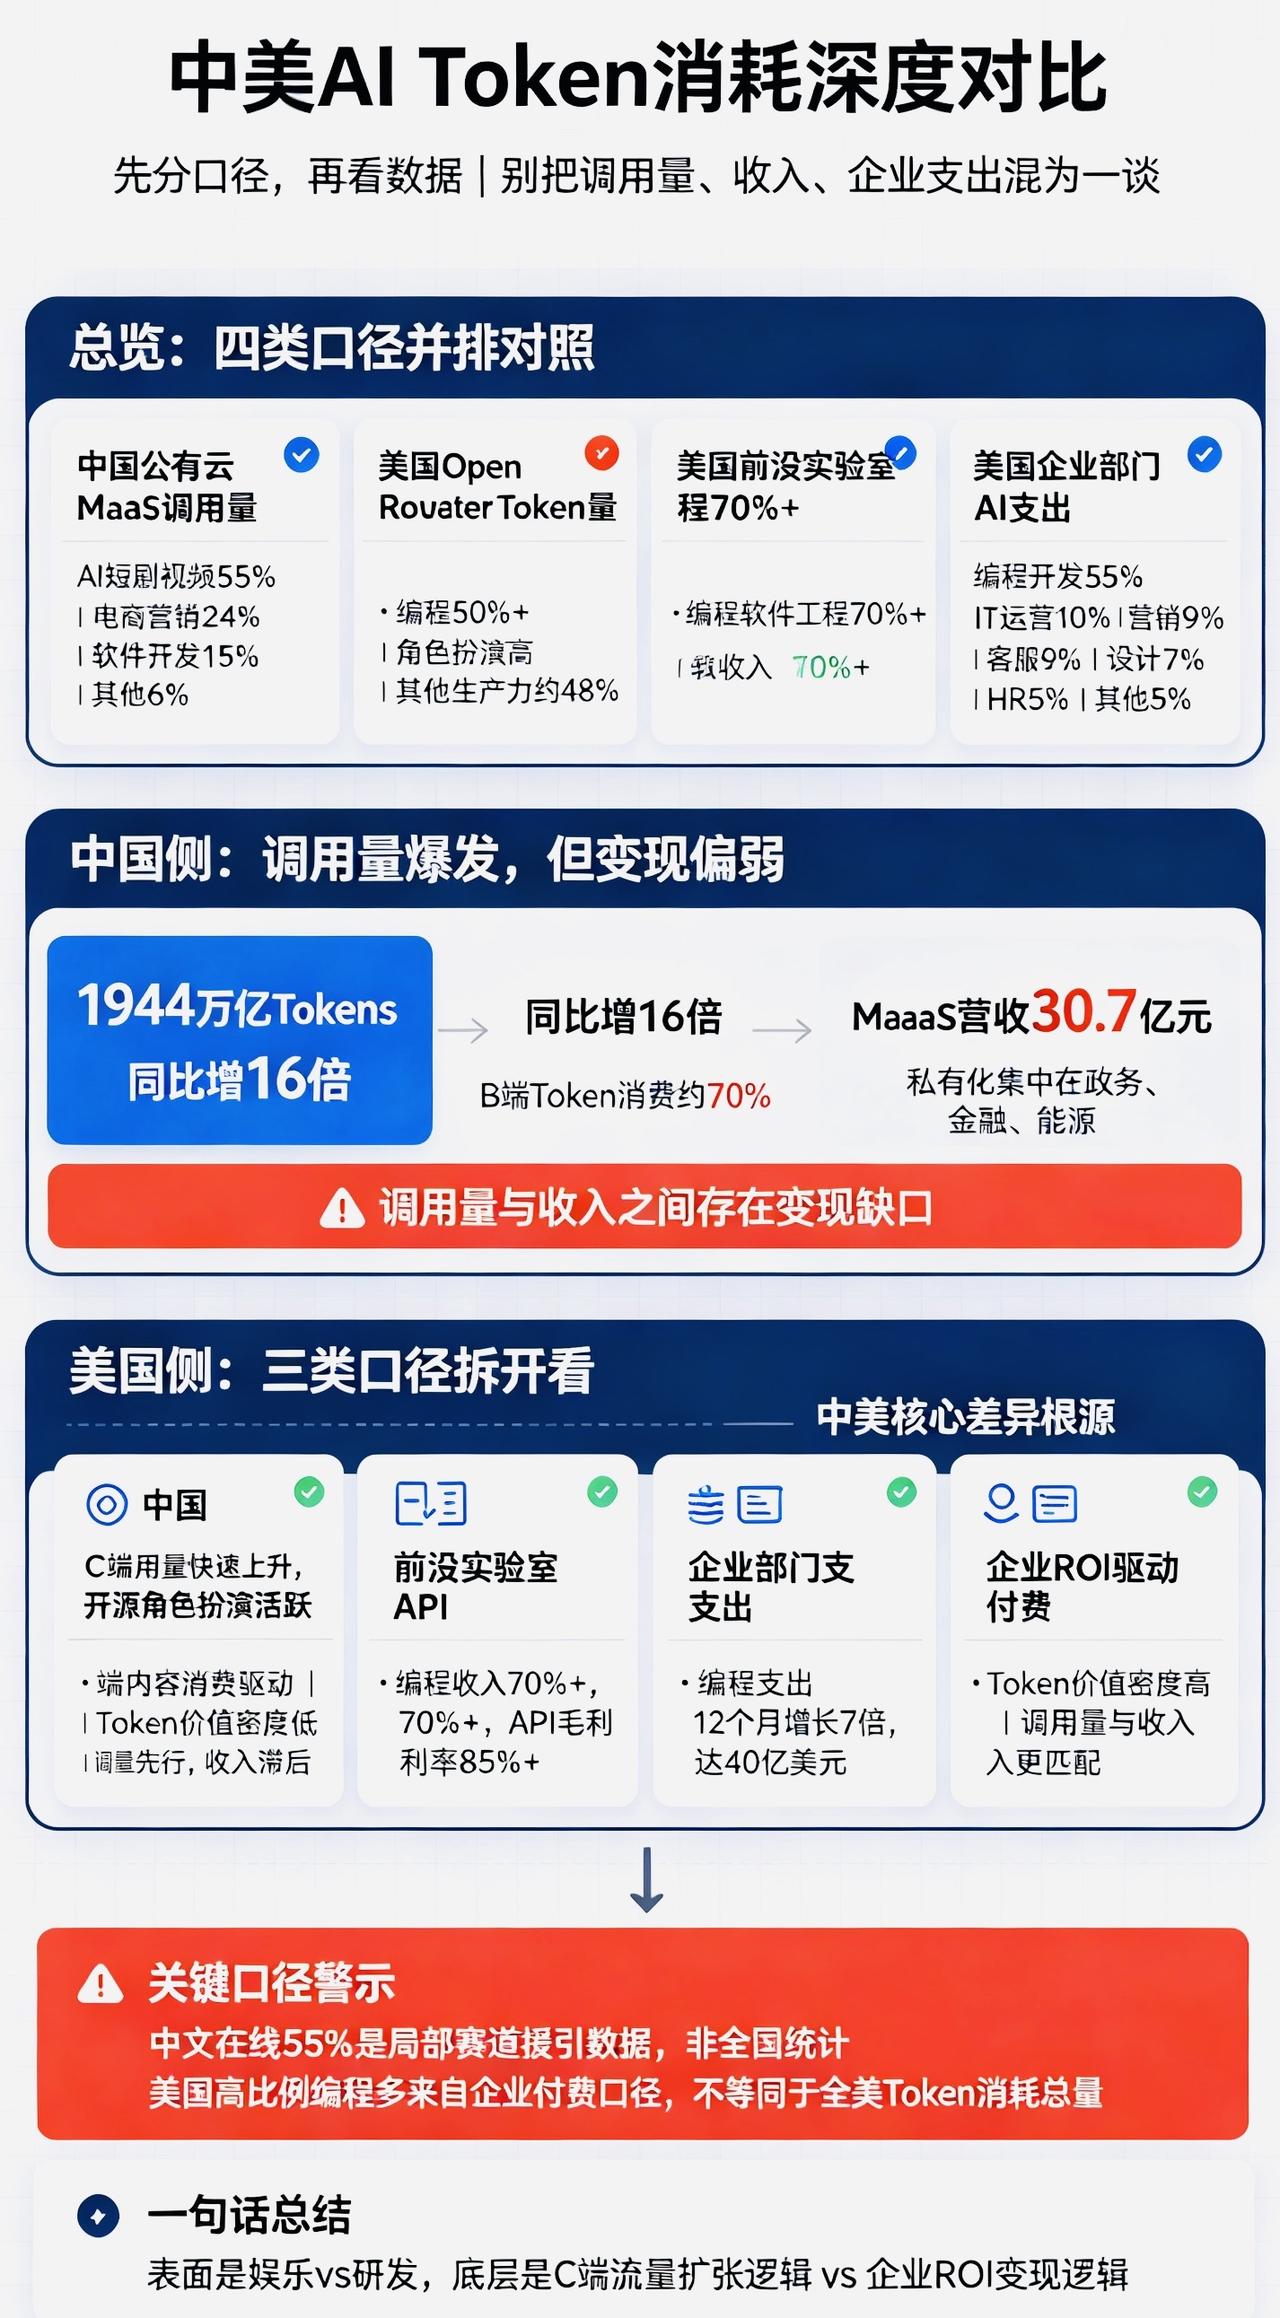
这复图是中美AI词元使用情况的对比图,本子就自动忽略了吧,看本子的没有意义它太少了。大家要知道今年以来,词元的用量大幅度提高,所以这里是一个周用量对照,因为按月都跟不上节奏了。这里除了科研和编程用量中美咬的很紧外,在娱乐和生产领域中已经大幅度领先于美了。即使是咬的很紧的科研和编程中国也是多于美国的。当然这也是网络上多诟病中国的原因,我们把大量的算力浪费在了娱乐方向,具体就是AI短剧。我两年前曾写过一篇文章,讲过当时大火的sora,后来这个文生视频模型在年初关了。当时我就曾提出观点这种模型的各类问题,当然是基于当时词元价格过高提出的,以及现在依旧存在的画面物理逻辑方面的出错问题。现实中我们看短剧其实大家只要稍微注意就能看到大量的不合理画面,只是因为故事的出色被我们人为的过滤并默认接纳了这种问题。可是,随着短剧发行量的巨量暴涨,未来竞争加剧是一定的,到那时观众还会继续理解这种视频错误的问题就是另说了。同样,我们在短剧上消耗词元量过大,其实还有一个很现成的原因,sora关闭后,国外的短剧也是用我们的模型来跑,所以这里的用量有一部分是出口的,这一点也是需要理解的。我曾经在deepseek上提问,为什么openAI要放弃视频,deepseek给出的回答是词元和词元其实是不一样的,编程词元和视频词元是两回事儿也是两种价格,美方追求更高的收入和利润战略性放弃视频是很明智的一种选择。而中方这面做视频大模型的其实是那几个互联网大厂,他们在真正AI较量的主战场编程已经落后了是那种丧失追赶能力的落后,但是又有不少算力中心,此时对于他们而言在市场里变现其实就是顺理成章了。AI这盘棋,经过我的盘点,看官您是不是已经有了初步的了解。其实,在主战场双方目前半斤对八两,而短剧其实只是个填头根本无足轻重。我们默认大量词元用于短剧可能只有一个原因,我们的电真的很多。
中国消耗的TOKEN有55%都用在的短剧上,美国则用在到了编程上!我看很多经济学
中国消耗的TOKEN有55%都用在的短剧上,美国则用在到了编程上!我看很多经济学家批评中国的人工智能用错了方向,都是生产一些奶头乐,没有改善生产力。而这些经济学家不知道,中国消耗的TOKEN是美国的4倍,编程占比是第二位的,总和也比美国多得多。现在人工智能最重要的就是找到盈利的商业模式,中国除开编程好歹还有短剧,而美国就只靠编程了,明显中国人工智能的发展更为健康,而美国就是一个史诗级的大泡沫。
ai真相:中国Token消耗第一是做短剧,美国Token消耗第一是编程?评几句:美国的B端软件付费习
ai真相:中国Token消耗第一是做短剧,美国Token消耗第一是编程?评几句:美国的B端软件付费习惯极度成熟,AI编程有巨大的商业价值,而中国的互联网是极度发达的C端流量经济,AI生成短剧和短视频,是商业变现效率最高的路径。两个国家在AI赛道上的应用方向,本来就是不同土壤里长出的不同果实,非要放在一个天平上比个高低,这不是很滑稽吗?整天不是赢了就是输了,有什么好赢的有什么好输的?不过看到是外网发的评论就不奇怪了,直接就暗戳戳的贬一捧一呗,觉得群众就认为编程自动化就比什么短视频生成高级呗,明明这俩就是不同的方向。
有野心的大学生请死磕这个软件宝藏APP计算机专业计算机程序员编程没想
有野心的大学生请死磕这个软件宝藏APP计算机专业计算机程序员编程没想到你是这样的程序员人类高质量科研工具学习软件宝藏软件
Rust不再是AI编程代理的默认最佳语言。它的编译时间太长了,我总是发现自己的瓶
Rust不再是AI编程代理的默认最佳语言。它的编译时间太长了,我总是发现自己的瓶颈在于时间而不是智能;与此同时,如今的AI代理已经越来越擅长进行手动内存管理。
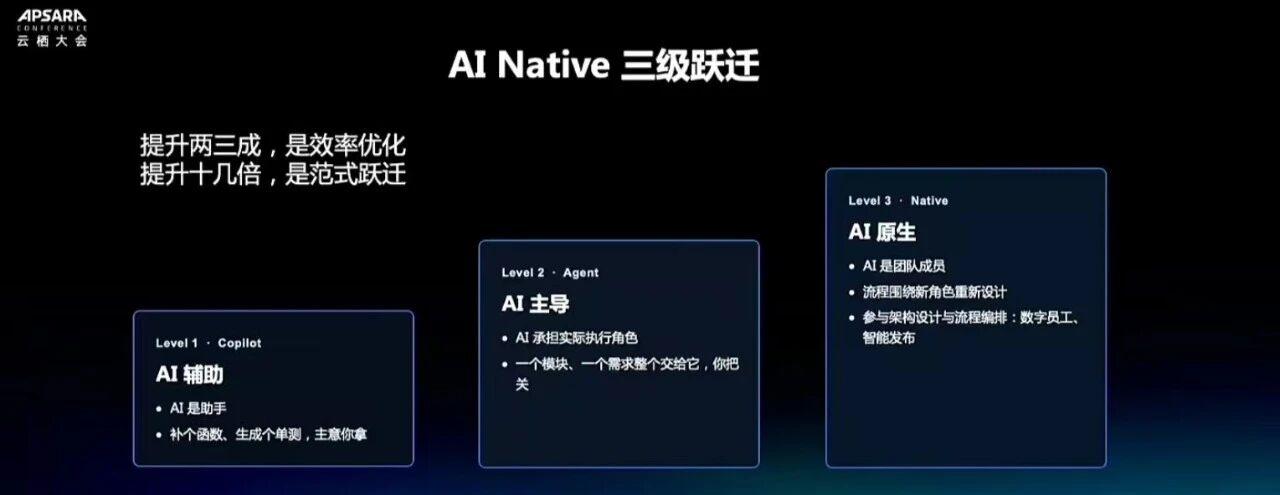
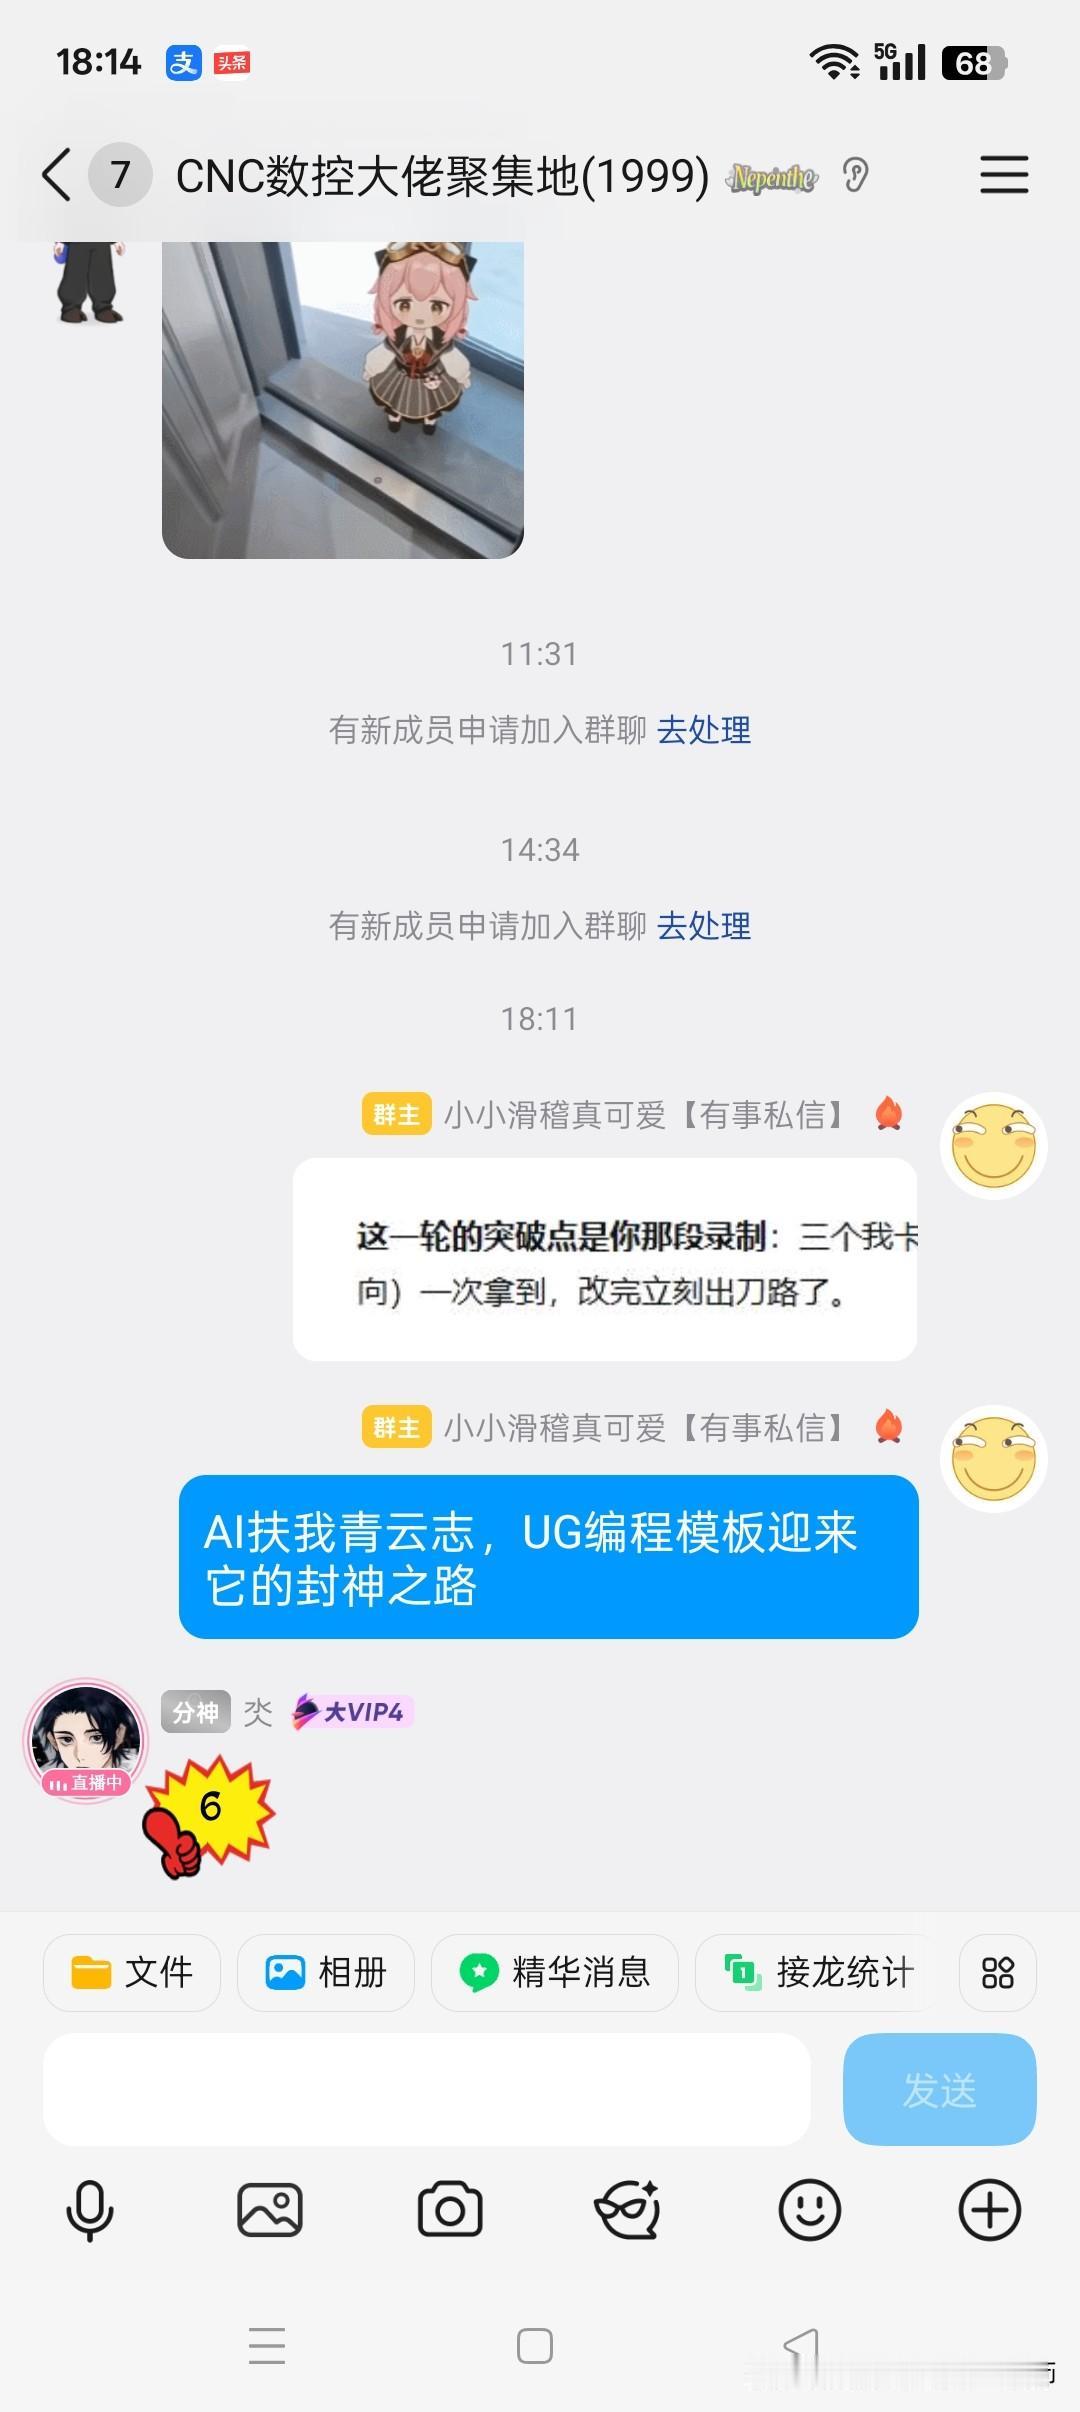
UG编程模板迎来了封神之路,AI扶我青云志。
UG编程模板迎来了封神之路,AI扶我青云志。
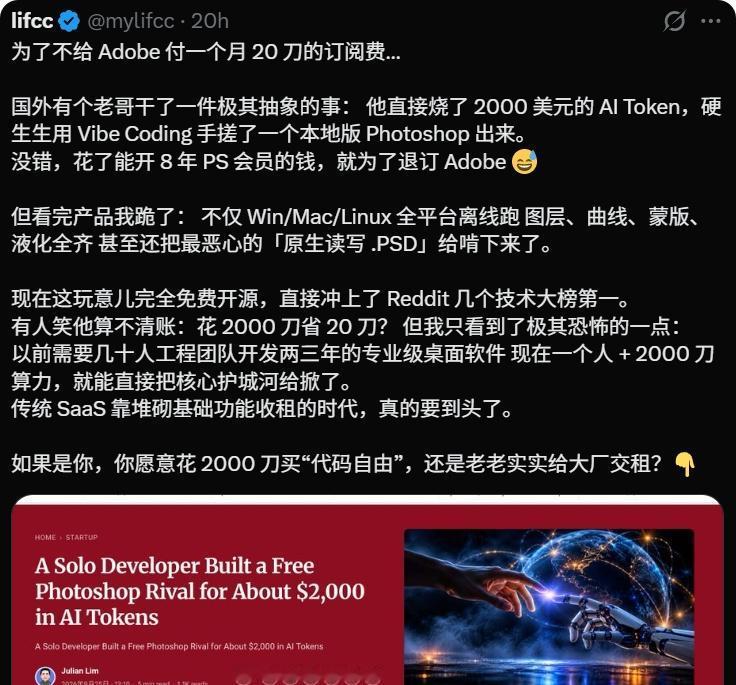
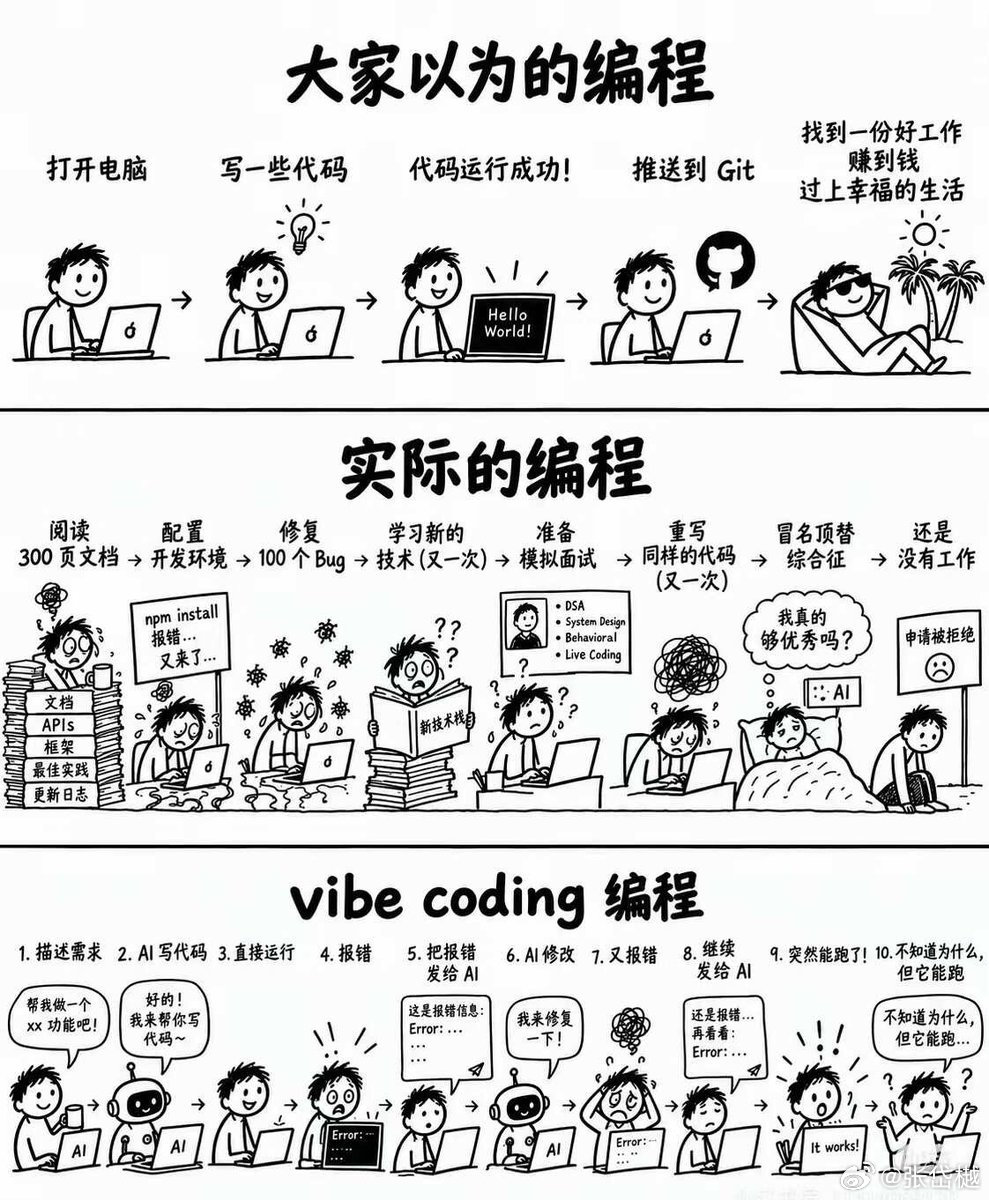
AI降低了编程和工程实现的门槛,很多老派程序员失业了,这其实是挺大的一个破坏。
AI降低了编程和工程实现的门槛,很多老派程序员失业了,这其实是挺大的一个破坏。但AI降低工程实现上的门槛,同时也可能带来巨大的机遇:就是创业的门槛同样降低了!以前需要招很多人成立大的公司的事情,可能只需要一小部分人,甚至一个人,就可以做出一个完整的成果了,这对有见解有全套经验的人,组建小团体进行创业,提供了很大的机遇。被裁的员工,如果是有能力的员工,可能基于自身的专业和经验积累(这部分是真门槛,不是谁都可以达到,但是也有不少这样的人以前只能打工,现在可以创业了),低成本和低门槛的进行创业。这样又可以把失业的人重新组织起来,现在是AI的快速发展,很可能可以帮助有经验的人做到这一点,说不定AI到了一定程度,就会有小的创业公司遍地开花,不是现在,是可能的未来会发生的事。
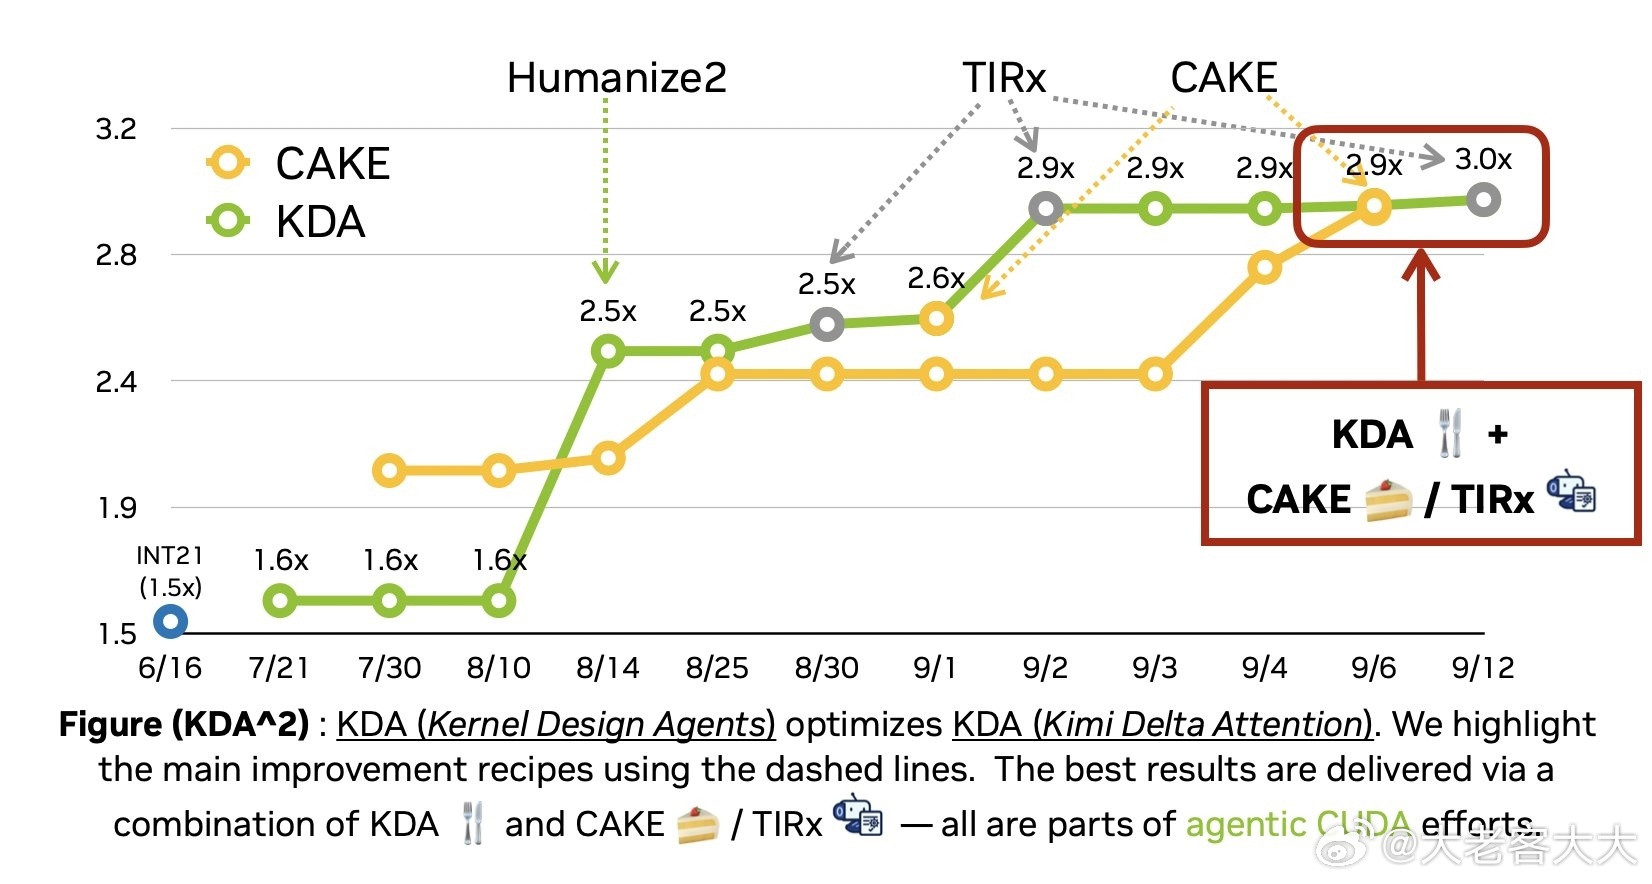
一篇技术观点文章提出,随着人工智能编程从简单的“提示即生成”发展为拥有验证框架、
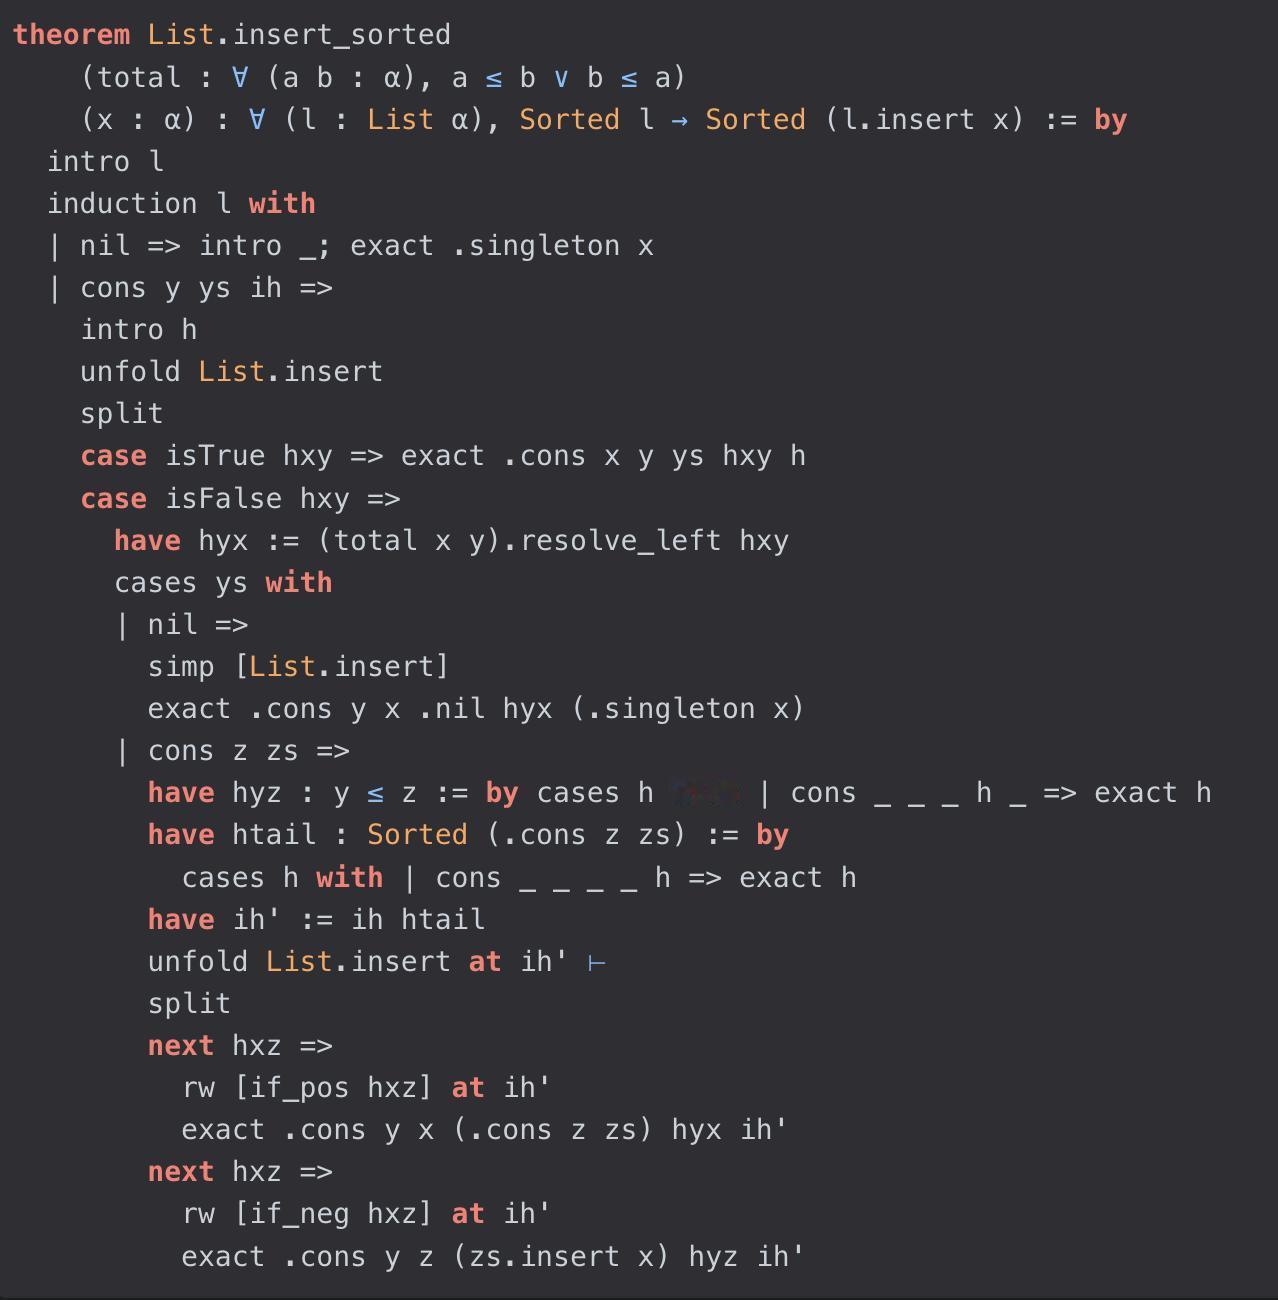
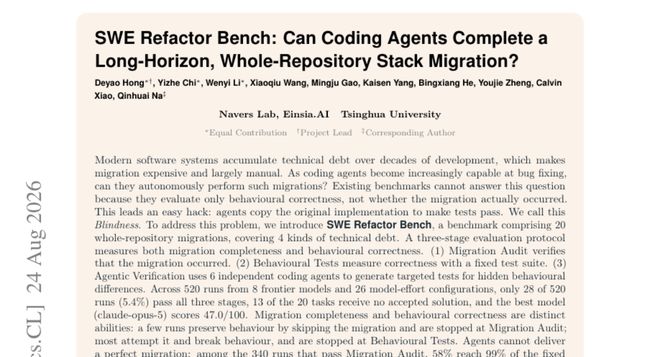
一篇技术观点文章提出,随着人工智能编程从简单的“提示即生成”发展为拥有验证框架、规则文件、测试套件和自主执行流程的工程实践,软件工程的重点正在改变。作者认为,当人类越来越少逐行阅读AI生成的代码时,编程语言的核心价值就不再只是便于人类阅读实现细节,而是要更精确地表达“程序应该做什么”。因此,未来语言的竞争力可能会从实现便利性转向规格表达能力。文章以Lean4为例,主张用类型系统直接充当规格说明。其理论基础是Curry-Howard对应关系:类型即命题,程序即证明。依赖类型让开发者不仅声明某个函数返回列表,还可以要求它返回一个附带机器可验证排序证明的有序列表。这样,编译器不再只检查代码能否运行,而是检查实现是否满足逻辑承诺。只要规格可以写成类型,AI就可以自由选择算法,但若没有有效证明,结果会被编译器拒绝。作者认为,这标志着类型驱动开发可能迎来新阶段:人类更擅长定义意图和约束,AI更擅长生成实现和补全证明,依赖类型成为两者之间的桥梁。文章通过排序算法的Lean4示例说明,无论是插入排序还是其他AI生成的实现,类型本身都能强制输出满足正确性,而不依赖传统测试作为主要保障。这一观点的核心是,在AI高速生产代码的时代,工程信任的关键应从“看起来能用”转向“可被机器证明”。
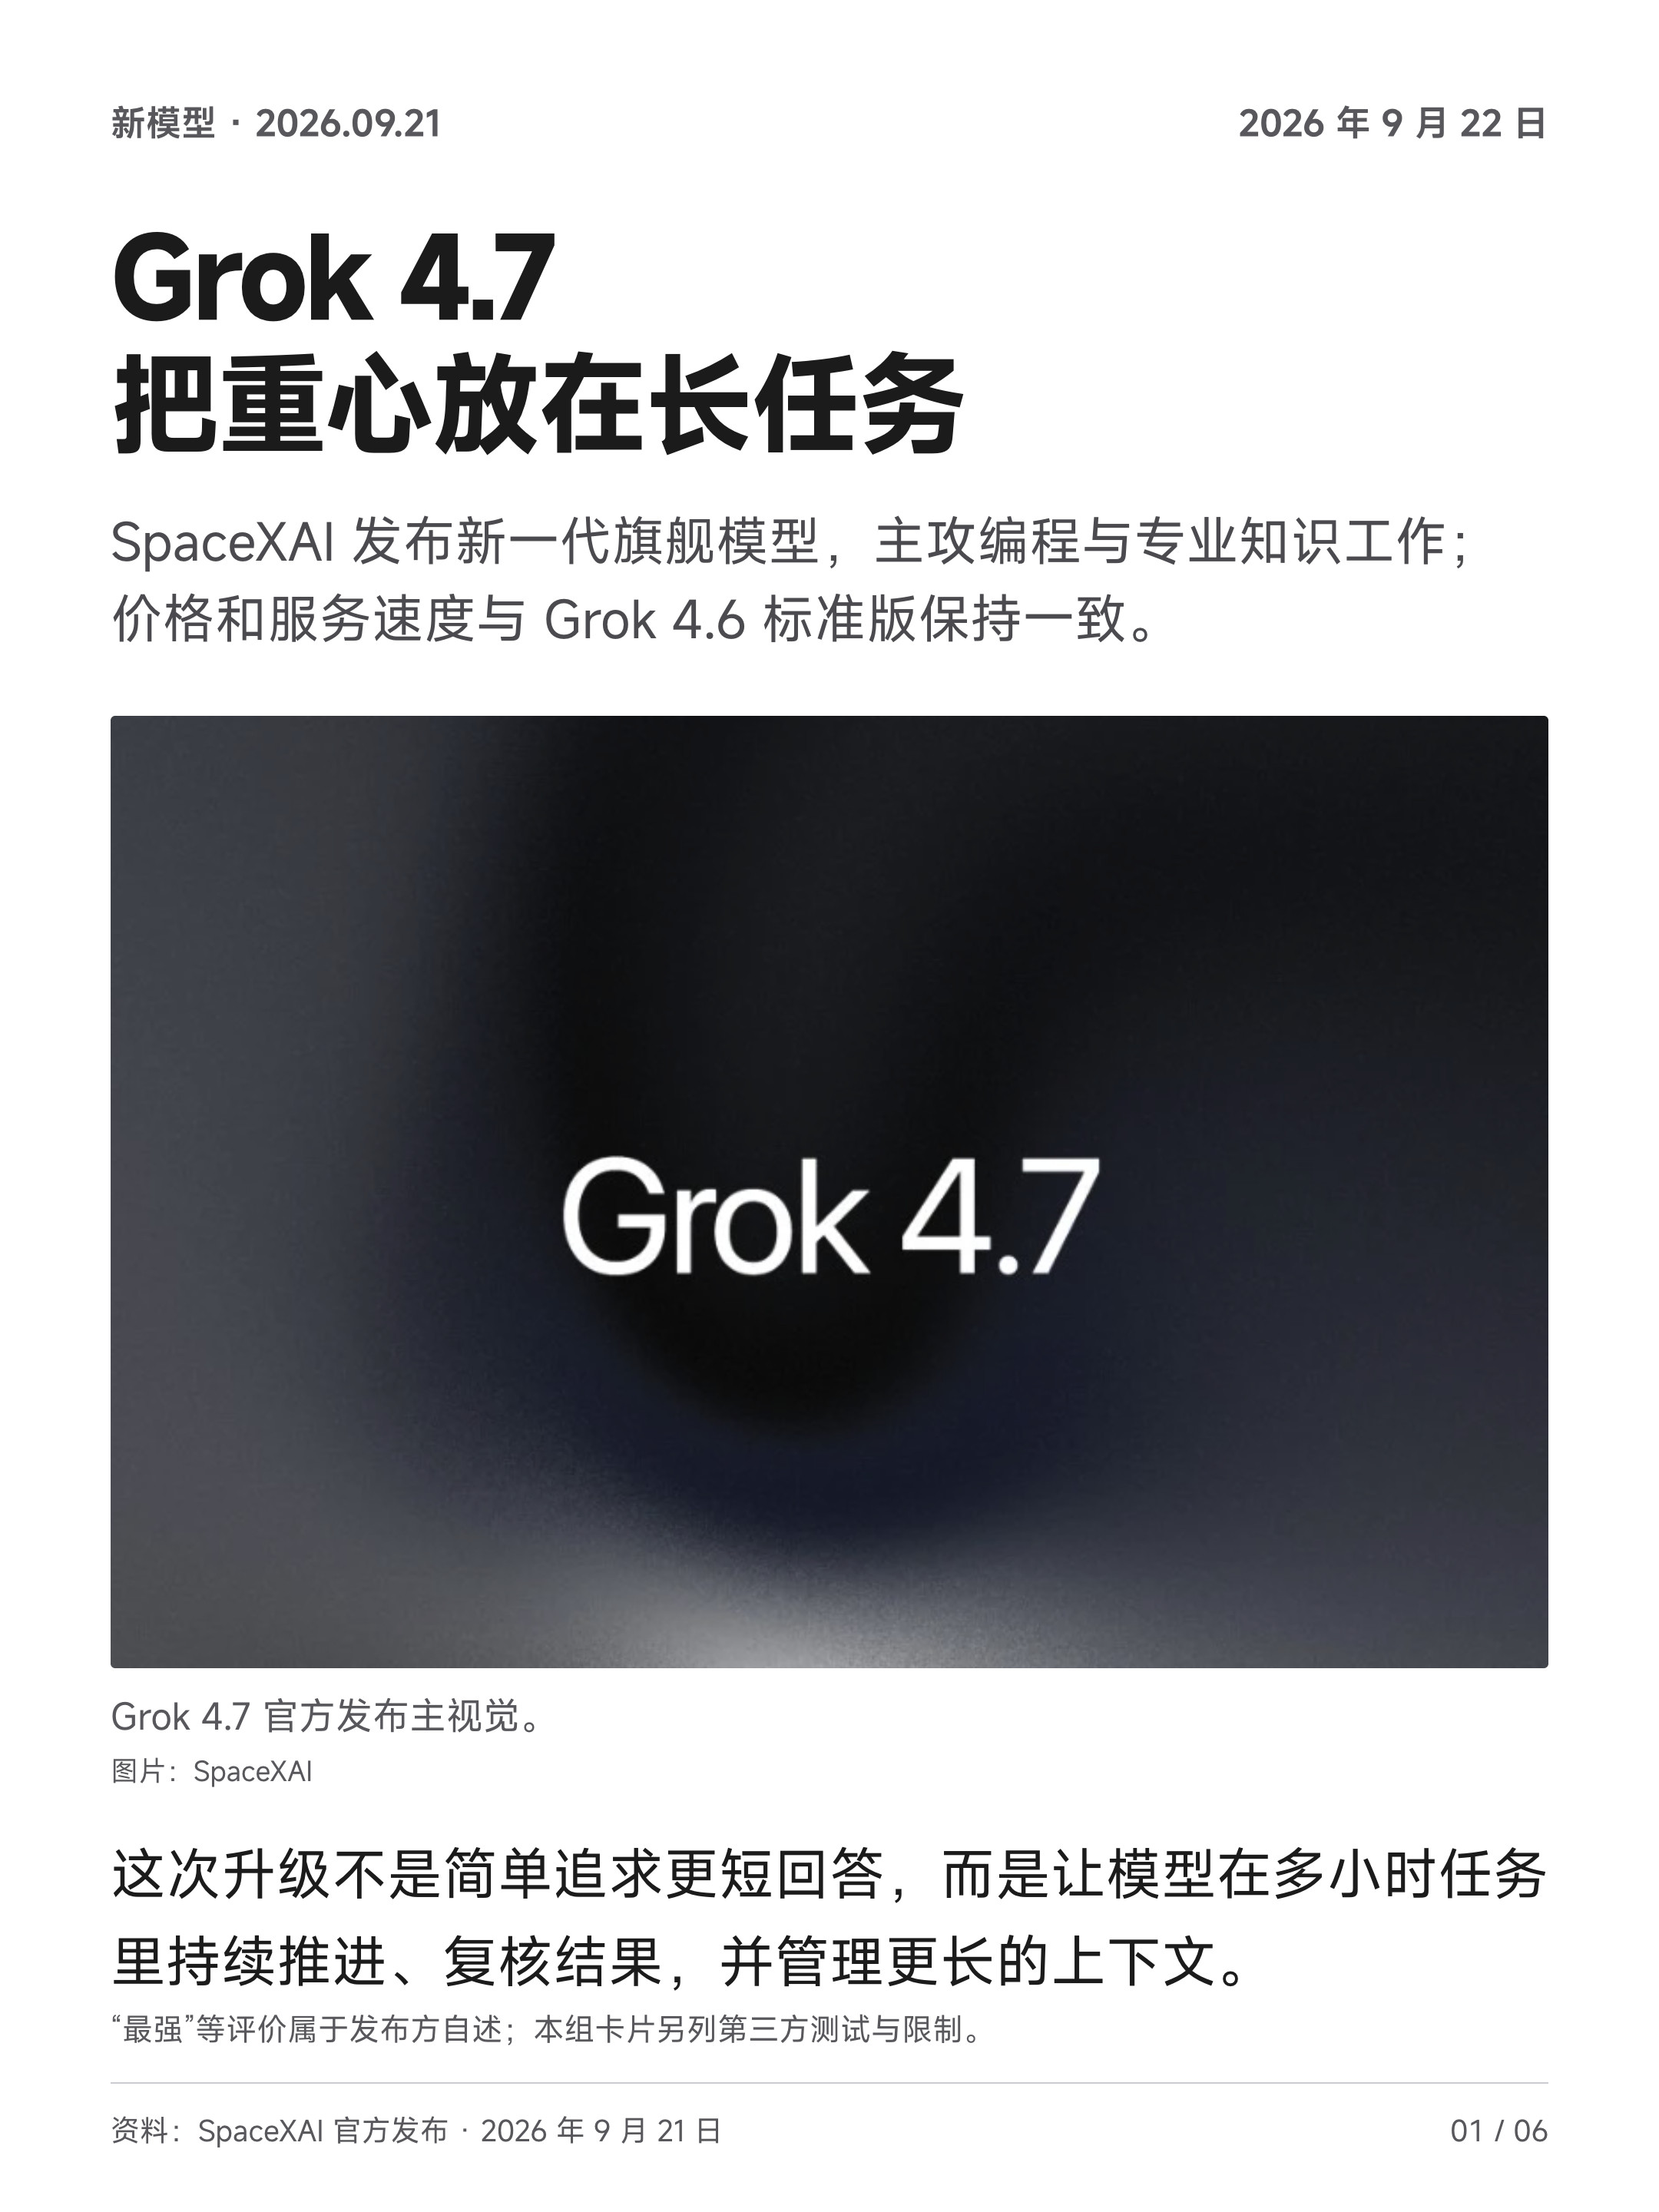
Grok4.7来了,主要升级编程能力、长任务和专业知识工作。#SpaceXAI发布Grok4.7模型
Grok4.7来了,主要升级编程能力、长任务和专业知识工作。#SpaceXAI发布Grok4.7模型#Grok4.7xHigh在CursorBench4.0上拿到46.3%,上一代Grok4.6High是40.4%;Terminal-Bench4.0从20.3%提升到38.0%;DeepSWEv1.1得分71.0%ArtificialAnalysis给Grok4.7的IntelligenceIndeGrok4.7来了,主要升级编程能力、长任务和专业知识工作。SpaceXAI发布Grok4.7模型Grok4.7xHigh在CursorBench4.0上拿到46.3%,上一代Grok4.6High是40.4%;Terminal-Bench4.0从20.3%提升到38.0%;DeepSWEv1.1得分71.0%ArtificialAnalysis给Grok4.7的IntelligenceIndex综合评分是46,搭配GrokBuild后,CodingAgentIndex得分56,在原生编程智能体组合中排第4。它在长时间知识工作上的提升尤其明显:AA-Briefcase得到1657Elo,比Grok4.6高了111;GDPval-AA得到1695Elo,提高了90。价格方面,标准版每百万token输入2美元、缓存输入0.50美元、输出6美元。Fast版本速度约为2倍,价格也翻倍,也就是输入4美元、缓存输入1美元、输出12美元。Grok4.7在Cursor中提供low、medium、high和xHigh四档推理强度,标准上下文为256k,长上下文最高支持500k。