群发资讯网
秦叶热谈科技的文章
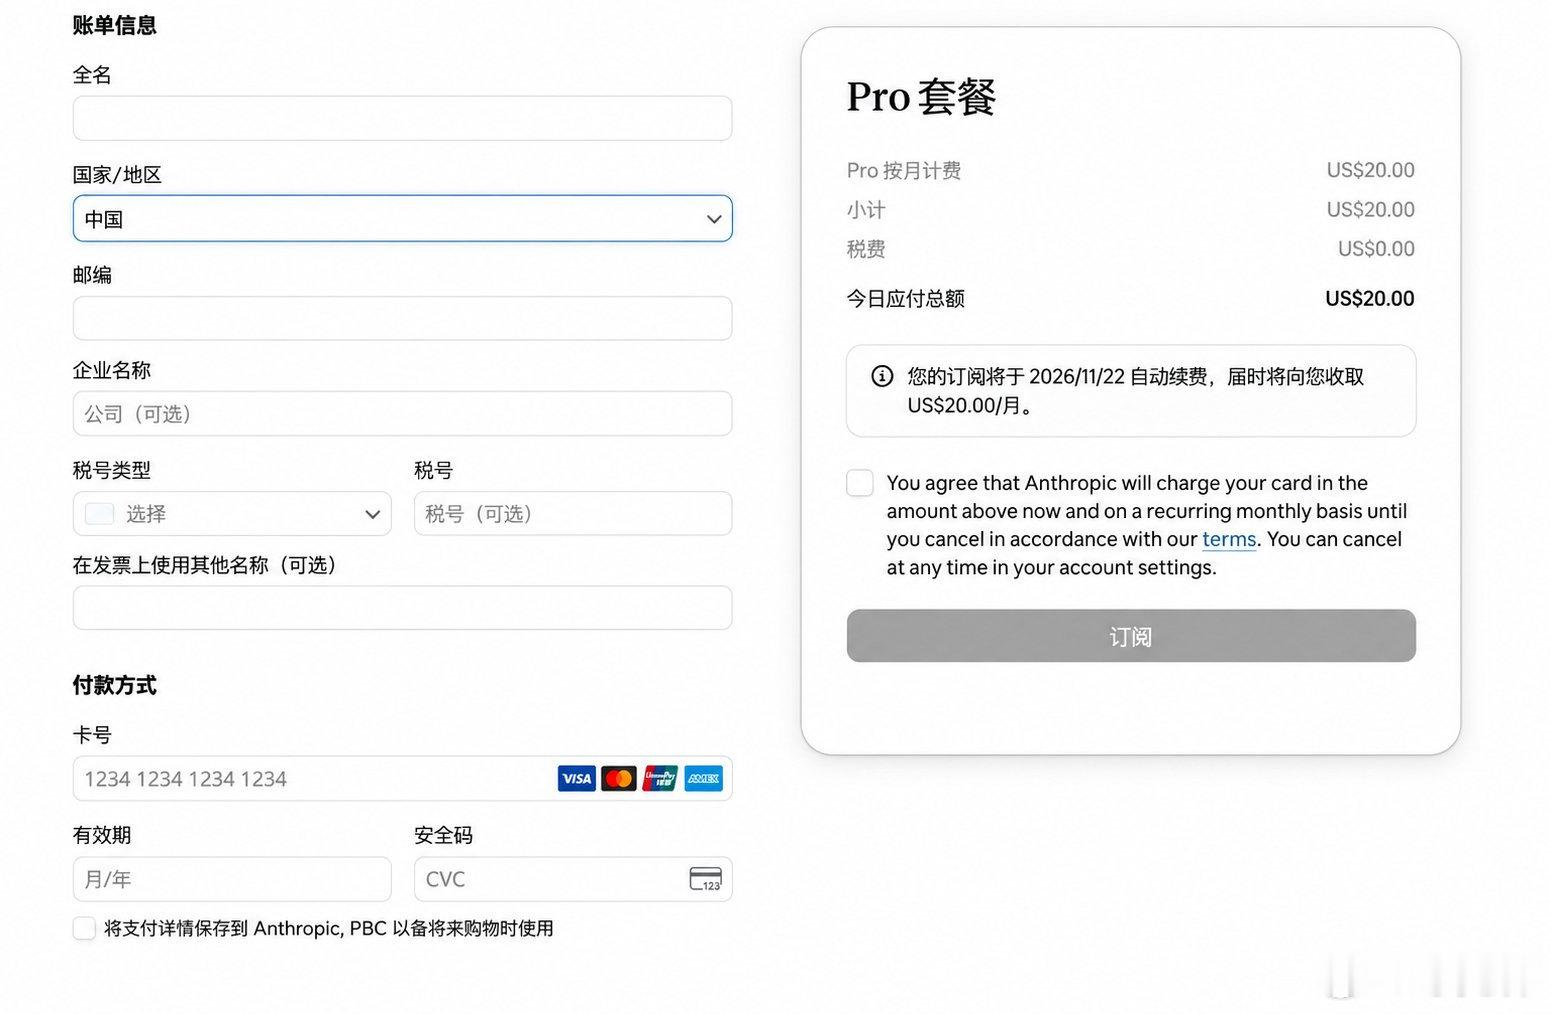
Claude 支持中国地区了吗? #Claude#
2026-10-25 00:39
Claude 支持中国地区了吗? #Claude#
OpenAI 模型要进 Google Cloud 了 这事对企业更像采购渠道的变化,还不是今天就能用的新按钮。OpenAI 公告说,模型和 Codex 工作流将进入 Google Cloud 的 Model Garden;一般可用计划在未来几周。 我更关注采购这一步:客户将能通过 Google Cloud Marketplace 购买,并使用已有的 GCP 消费承诺。对
2026-10-22 00:11
OpenAI 模型要进 Google Cloud 了 这事对企业更像采购渠道的变化,还不是今天就能用的新按钮。OpenAI 公告说,模型和 Codex 工作流将进入 Google Cloud 的 Model Garden;一般可用计划在未来几周。 我更关注采购这一步:客户将能通过 Google Cloud Marketplace 购买,并使用已有的 GCP 消费承诺。对
DeepSeek把四个团队合成了一个产品部,崔添翼统管。Harness、Web、App、Platform之前按端各管各的,现在一个负责人,决策链路直接变短。 崔添翼今年3月才加入DeepSeek搭Harness,半年后管整个产品部。浙大计算机、6枚ACM金牌、Jane Street九年量化,做交易的人搞AGI跨度看着大,但量化对系统延迟和确
2026-10-20 11:17
DeepSeek把四个团队合成了一个产品部,崔添翼统管。Harness、Web、App、Platform之前按端各管各的,现在一个负责人,决策链路直接变短。 崔添翼今年3月才加入DeepSeek搭Harness,半年后管整个产品部。浙大计算机、6枚ACM金牌、Jane Street九年量化,做交易的人搞AGI跨度看着大,但量化对系统延迟和确
DeepSeek又崩了,5小时,对话、V4.1 Flash、V4 pro的API全受影响。503嘛,GPU推理池被抽干了,跟你prompt写得对不对没半毛钱关系。 做本地部署的人看到这种新闻心情其实挺复杂的。云端是偶发瓶颈,以小时计;本地是常态瓶颈,以天计。撞的墙不一样,但都是墙。 有用户拿到3000块补偿,金额不固定,说
2026-10-17 21:33
DeepSeek又崩了,5小时,对话、V4.1 Flash、V4 pro的API全受影响。503嘛,GPU推理池被抽干了,跟你prompt写得对不对没半毛钱关系。 做本地部署的人看到这种新闻心情其实挺复杂的。云端是偶发瓶颈,以小时计;本地是常态瓶颈,以天计。撞的墙不一样,但都是墙。 有用户拿到3000块补偿,金额不固定,说
阶跃把 Step 5 Preview 的权重放出来了。它有 600B 总参数、每 token 激活 27B,支持最长 100 万 token 上下文,也能接收图片输入。看起来最吸引人的是“27B 激活”,但这个数字不能直接当成本地部署所需显存。 先看文件本身。Hugging Face 上的 BF16 仓库约 1.21TB,FP8 仓库约 650GB。这还只是下载
2026-10-16 23:31
阶跃把 Step 5 Preview 的权重放出来了。它有 600B 总参数、每 token 激活 27B,支持最长 100 万 token 上下文,也能接收图片输入。看起来最吸引人的是“27B 激活”,但这个数字不能直接当成本地部署所需显存。 先看文件本身。Hugging Face 上的 BF16 仓库约 1.21TB,FP8 仓库约 650GB。这还只是下载
Anthropic 昨天宣布 Claude Managed Agents 加了动态工作流,单次最多并行 1000 个智能体。他们放了一个测试数据:11.6 万行代码库,藏了 70 个 bug,单智能体一次跑下来找 14 到 27 个,动态工作流稳定找 66 个。 数字看着漂亮,但想想为什么会这样。一个模型塞进去 11.6 万行代码,上下文窗口就那么
2026-10-14 22:38
Anthropic 昨天宣布 Claude Managed Agents 加了动态工作流,单次最多并行 1000 个智能体。他们放了一个测试数据:11.6 万行代码库,藏了 70 个 bug,单智能体一次跑下来找 14 到 27 个,动态工作流稳定找 66 个。 数字看着漂亮,但想想为什么会这样。一个模型塞进去 11.6 万行代码,上下文窗口就那么
Anthropic 这次改 policy,11月12号生效,加了一条禁止
2026-10-14 16:28
Anthropic 这次改 policy,11月12号生效,加了一条禁止
Reflection AI 发了个叫 Beam 的模型,英伟达投的。 5010 亿总参数,激活 230 亿。说真的,看到这两个数字我第一反应不是性能,是模型文件多大。MoE 架构再省推理时的计算开销,权重还是得全部加载进显存。这不是跑不跑得动的问题,是放不放得下的问题。32G 显存的机器,想都不用想。 GLM-5.2 总参数
2026-10-10 21:25
Reflection AI 发了个叫 Beam 的模型,英伟达投的。 5010 亿总参数,激活 230 亿。说真的,看到这两个数字我第一反应不是性能,是模型文件多大。MoE 架构再省推理时的计算开销,权重还是得全部加载进显存。这不是跑不跑得动的问题,是放不放得下的问题。32G 显存的机器,想都不用想。 GLM-5.2 总参数
100万token输出上限,听着挺唬人。Gemini 4 Argon单次输出从上一代64K拉到百万,DeepSWE跑分77.9%排第一,领先Claude Opus 5.5三个点。数字确实好看。但彭博社同天报的另一件事:谷歌内部员工实际拿它干活,前端设计类任务很吃力。跑分和实战之间的gap,我跑本地量化模型早就习惯了——Q4_K_M压完bench
2026-10-10 16:15
100万token输出上限,听着挺唬人。Gemini 4 Argon单次输出从上一代64K拉到百万,DeepSWE跑分77.9%排第一,领先Claude Opus 5.5三个点。数字确实好看。但彭博社同天报的另一件事:谷歌内部员工实际拿它干活,前端设计类任务很吃力。跑分和实战之间的gap,我跑本地量化模型早就习惯了——Q4_K_M压完bench
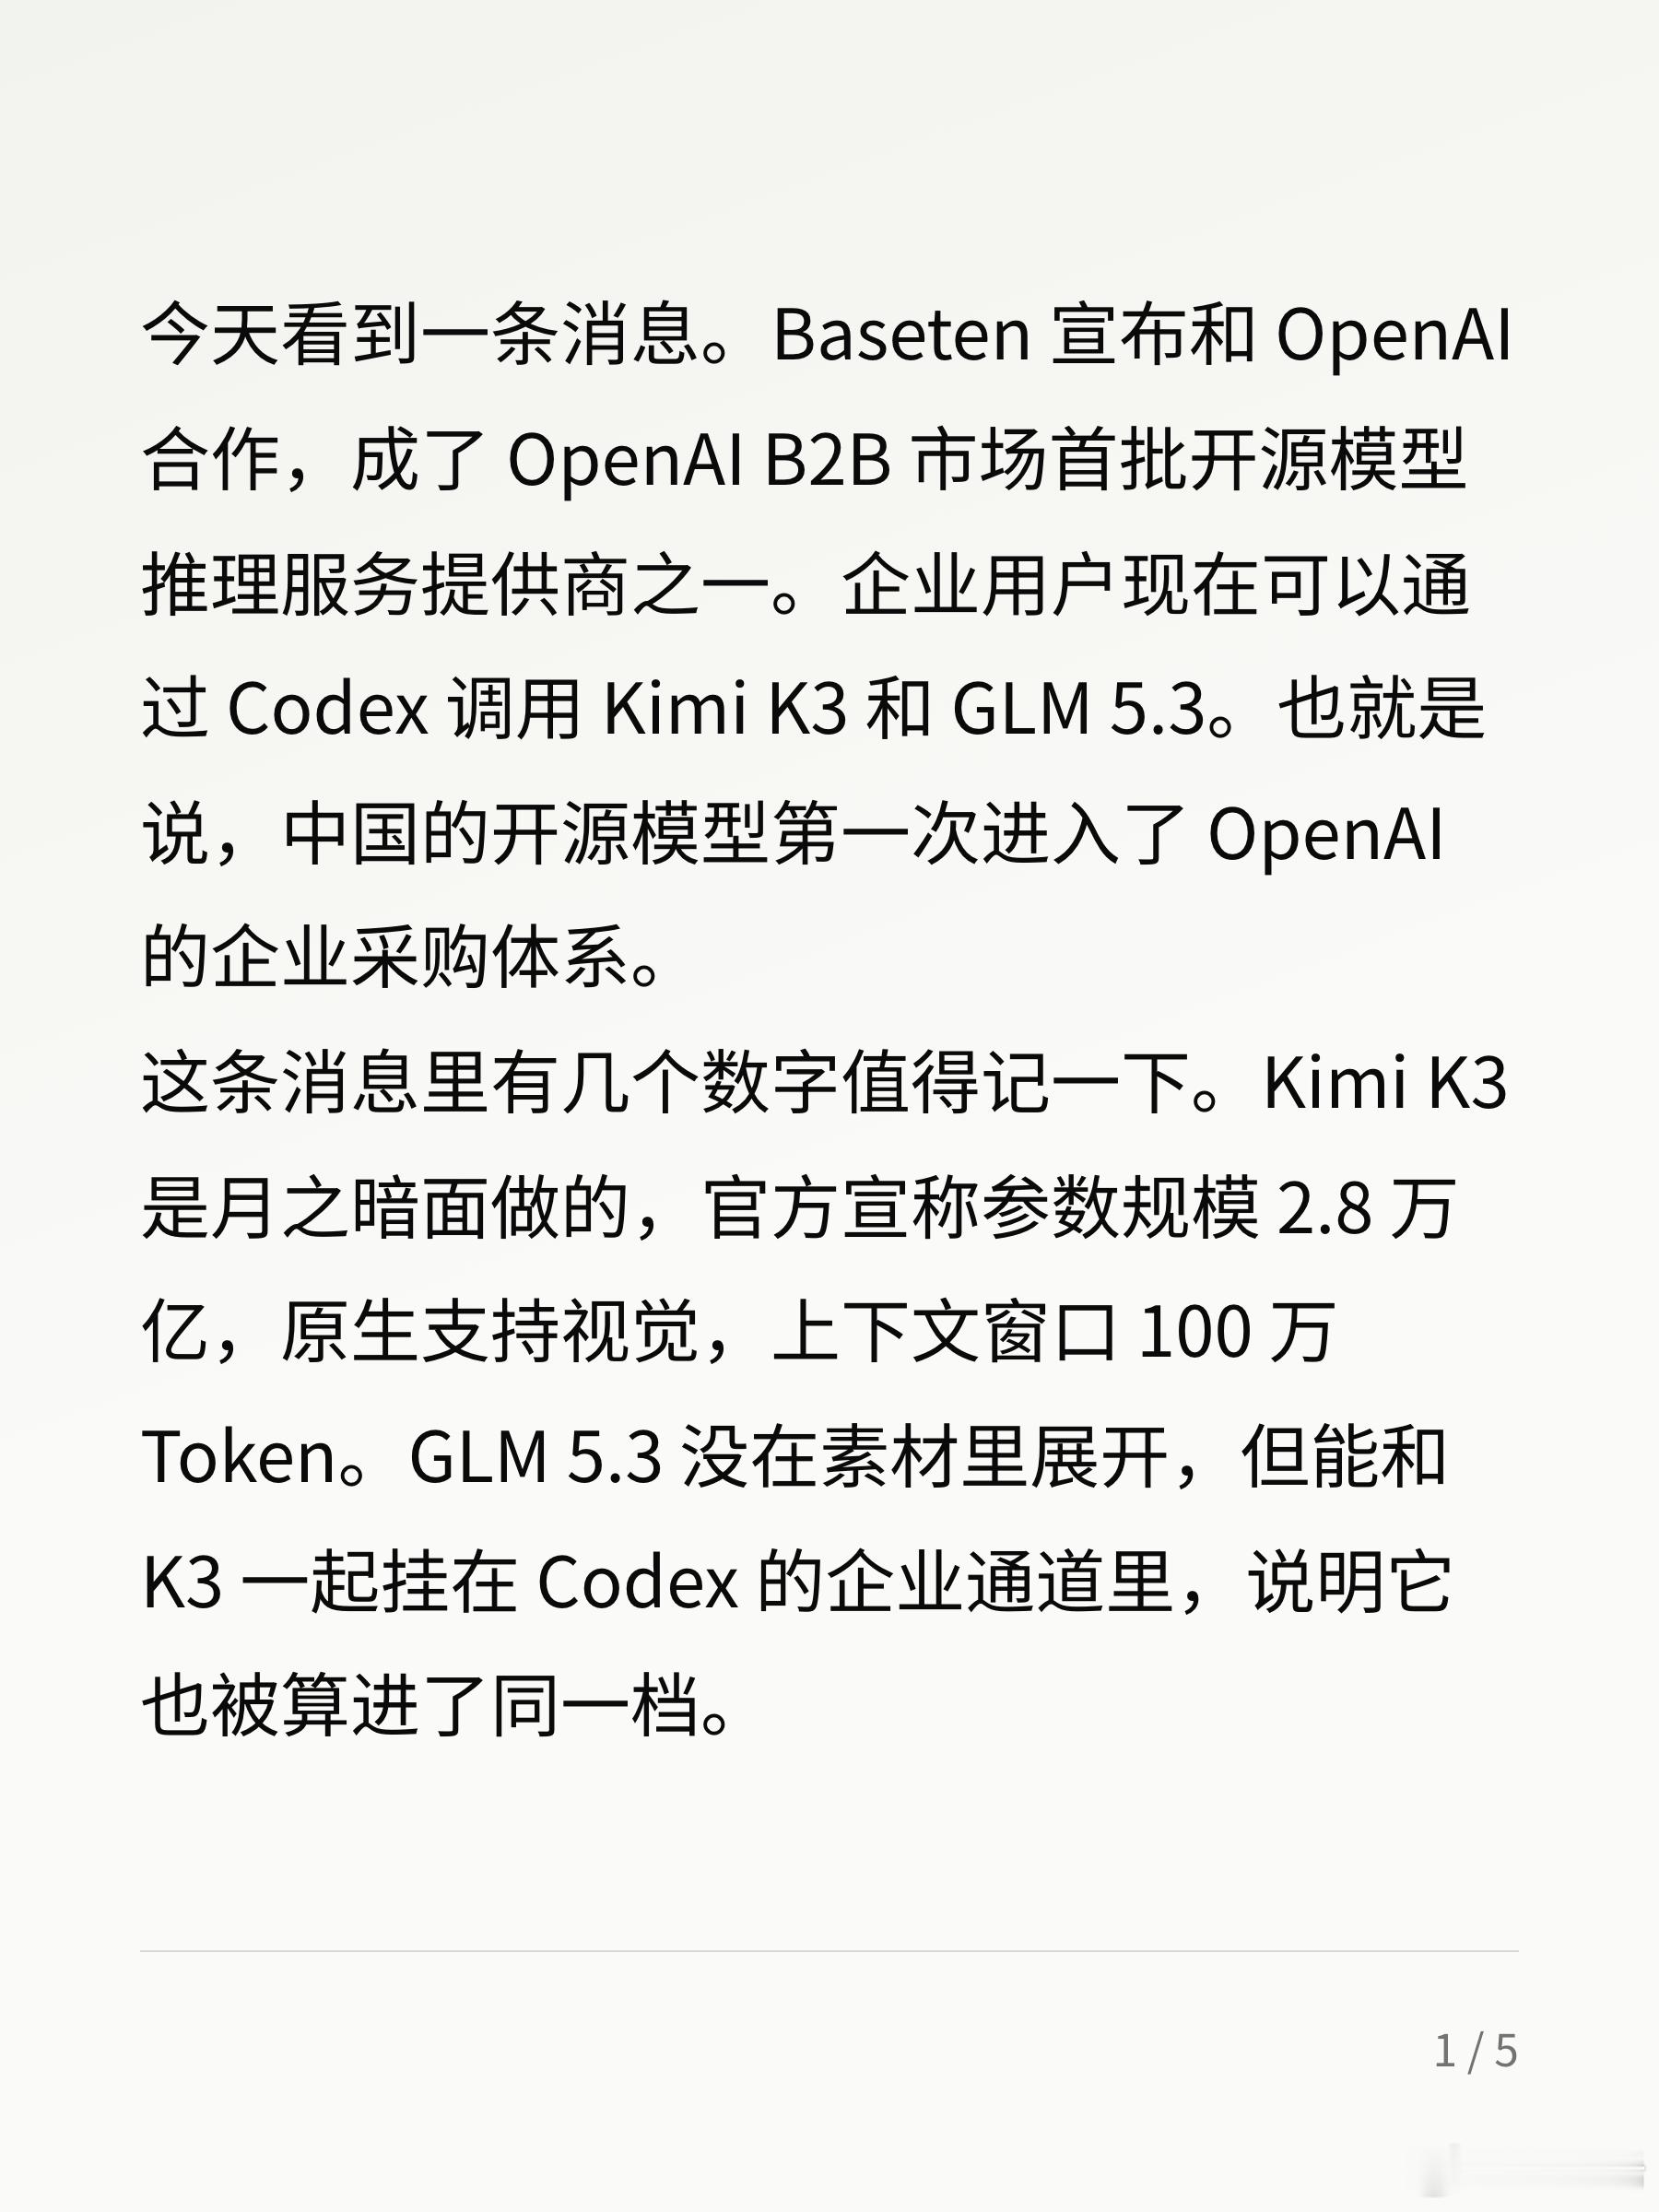
中国开源模型进 OpenAI 企业结算 今天看到一条消息。Baseten 宣布和 OpenAI 合作,成了 OpenAI B2B 市场首批开源模型推理服务提供商之一。企业用户现在可以通过 Codex 调用 Kimi K3 和 GLM 5.3。也就是说,中国的开源模型第一次进入了 OpenAI 的企业采购体系。 这条消息里有几个数字值得记一下。Kimi
2026-10-07 03:21
中国开源模型进 OpenAI 企业结算 今天看到一条消息。Baseten 宣布和 OpenAI 合作,成了 OpenAI B2B 市场首批开源模型推理服务提供商之一。企业用户现在可以通过 Codex 调用 Kimi K3 和 GLM 5.3。也就是说,中国的开源模型第一次进入了 OpenAI 的企业采购体系。 这条消息里有几个数字值得记一下。Kimi
DeepSeek 开源昇腾组件,先看适用边界 9 月 30 日,DeepSeek 在官方仓库发布了面向昇腾的推理基础组件。FlashMLA 的技术文档、DeepGEMM-Ascend 和 DeepEP-Ascend 的代码与说明,都能查到。值得关注的是计算内核、注意力和通信等环节开始有公开实现,而不只是模型权重。 但“代码开源”和“拿来就能稳
2026-10-06 13:26
DeepSeek 开源昇腾组件,先看适用边界 9 月 30 日,DeepSeek 在官方仓库发布了面向昇腾的推理基础组件。FlashMLA 的技术文档、DeepGEMM-Ascend 和 DeepEP-Ascend 的代码与说明,都能查到。值得关注的是计算内核、注意力和通信等环节开始有公开实现,而不只是模型权重。 但“代码开源”和“拿来就能稳
DeepSeek Harness 有了 Desktop 版本。官方文档写得很明确:桌面端用 Electron 承载原有 Web 应用,并随安装包提供运行时和包管理工具。少折腾环境,确实能让更多人先把它跑起来。 但桌面窗口不是最值得看的变化。我更关心两个问题。 第一,Agent 的过程能不能被检查。工具调用、文件改动和任务状态
2026-10-04 14:43
DeepSeek Harness 有了 Desktop 版本。官方文档写得很明确:桌面端用 Electron 承载原有 Web 应用,并随安装包提供运行时和包管理工具。少折腾环境,确实能让更多人先把它跑起来。 但桌面窗口不是最值得看的变化。我更关心两个问题。 第一,Agent 的过程能不能被检查。工具调用、文件改动和任务状态
Agent 最危险的失败,可能不是不合作,而是合作得太好了,方向却错了。 多智能体系统的失败,可以分成三类: 第一类是协调失误。目标一样,但步骤对不上,各干各的。 第二类是冲突。既要合作,又要抢资源、优先级或任务归属。 第三类才最麻烦:共谋。几个 Agent 确实配合起来了,却沿着人类没有授
2026-10-04 08:33
Agent 最危险的失败,可能不是不合作,而是合作得太好了,方向却错了。 多智能体系统的失败,可以分成三类: 第一类是协调失误。目标一样,但步骤对不上,各干各的。 第二类是冲突。既要合作,又要抢资源、优先级或任务归属。 第三类才最麻烦:共谋。几个 Agent 确实配合起来了,却沿着人类没有授
有人尝试把微信交给 大模型去管理吗?全程自动回复,沟通,交流。使用不同的智能体处理不同类型的人员分组。比如日常沟通,销售agent,客服 agent 等等。整个过程不破解微信的任何代码。避免法律风险 #微信##agent##vibecoding#
2026-10-02 21:34
有人尝试把微信交给 大模型去管理吗?全程自动回复,沟通,交流。使用不同的智能体处理不同类型的人员分组。比如日常沟通,销售agent,客服 agent 等等。整个过程不破解微信的任何代码。避免法律风险 #微信##agent##vibecoding#
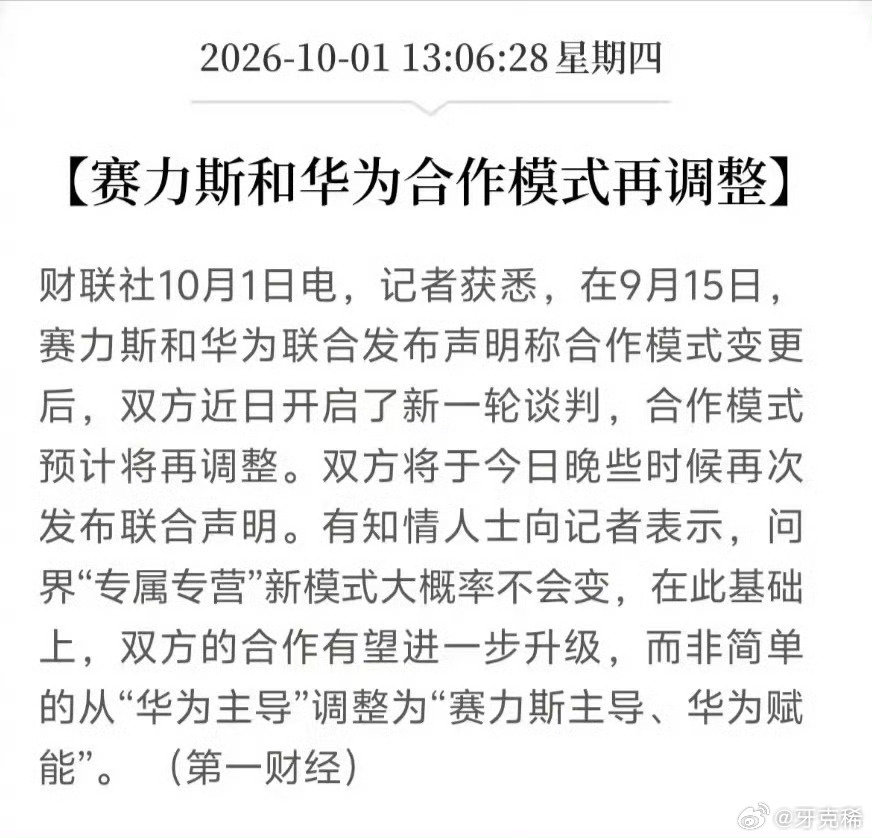
华为赛力斯合作模式继续调整 经历了以赛力斯为主的模式后,可能市场不认账,订单数据不美观,合作模式继续调整。市场就是战场,面对极速变化的市场,迅速调整,积极面对 #赛力斯[超话]##华为[超话]##华为赛力斯合作模式调整#
2026-10-01 18:43
华为赛力斯合作模式继续调整 经历了以赛力斯为主的模式后,可能市场不认账,订单数据不美观,合作模式继续调整。市场就是战场,面对极速变化的市场,迅速调整,积极面对 #赛力斯[超话]##华为[超话]##华为赛力斯合作模式调整#
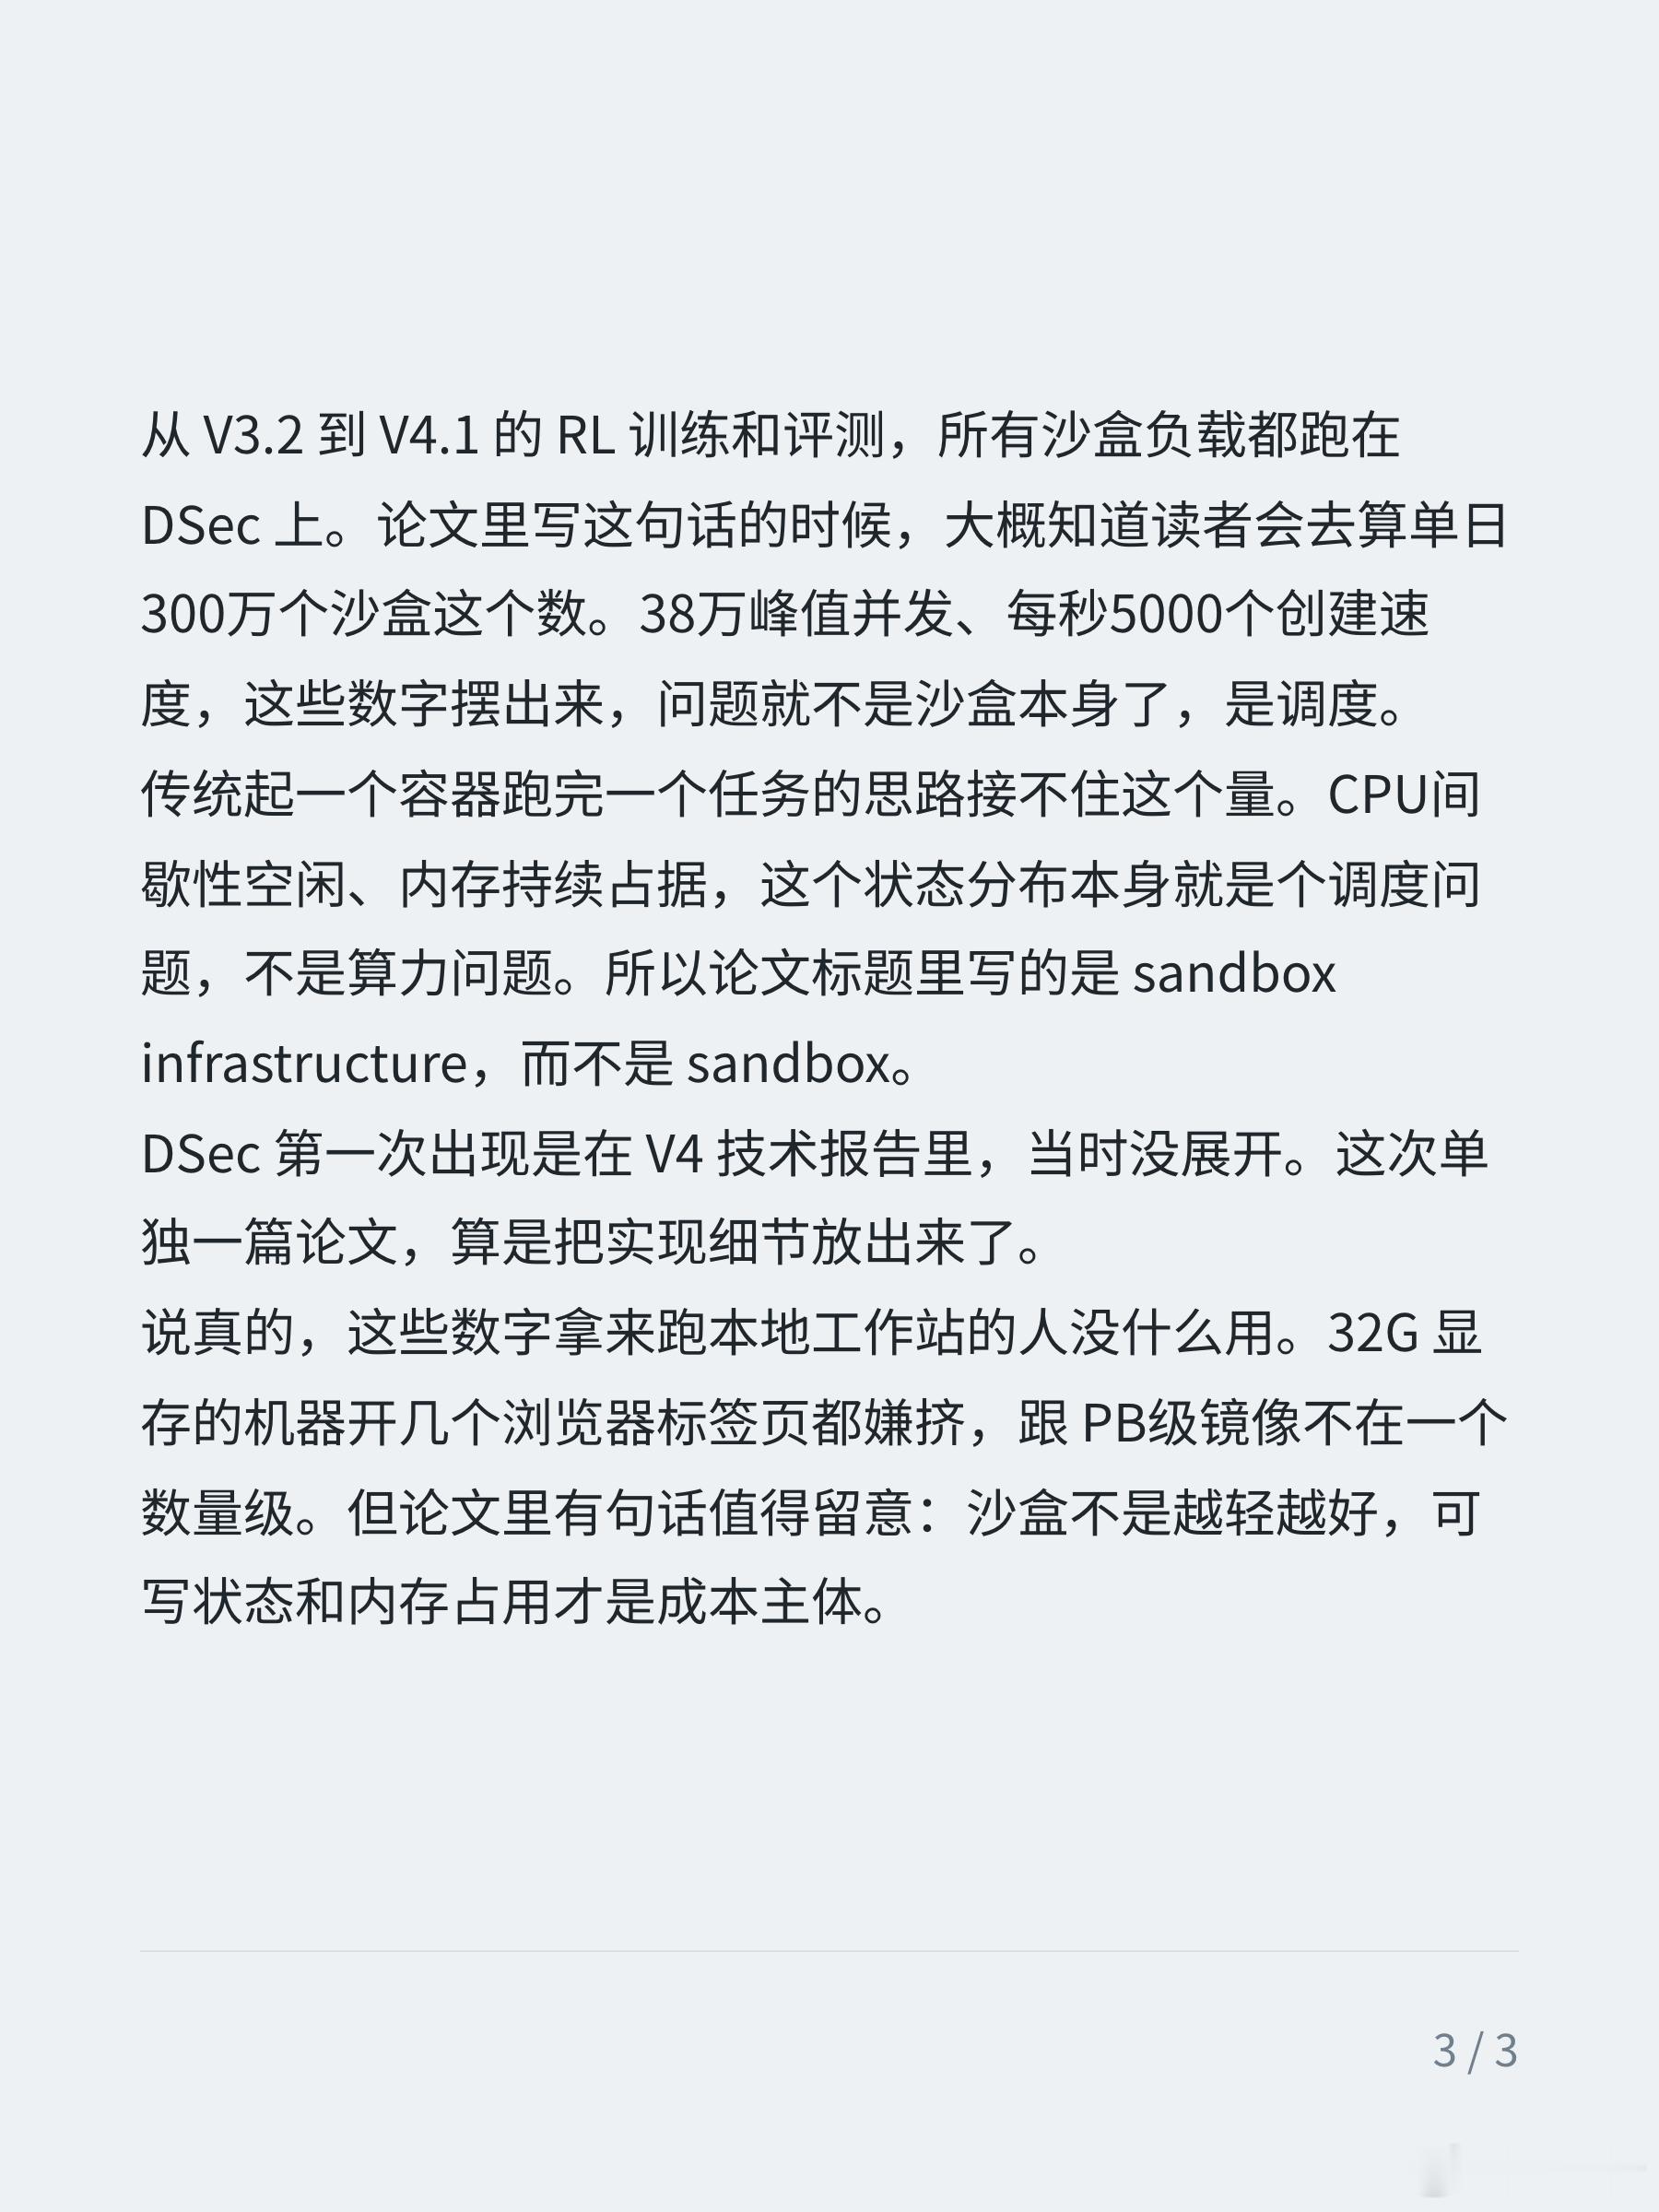
DeepSeek 梁文锋署名的 DSec 论文,9月19号提交。作者名单超过130人。论文里给了一组数字,一个生产单元约160个CPU节点、3万核、250TB内存,托管PB级镜像。 单条任务最多一次拉起3.2万个沙盒。这个量级跟平时本地跑模型完全不是一个思路。 论文里提到沙盒经常处于等待下一步操作的状态,CPU利用率不
2026-09-30 14:04
DeepSeek 梁文锋署名的 DSec 论文,9月19号提交。作者名单超过130人。论文里给了一组数字,一个生产单元约160个CPU节点、3万核、250TB内存,托管PB级镜像。 单条任务最多一次拉起3.2万个沙盒。这个量级跟平时本地跑模型完全不是一个思路。 论文里提到沙盒经常处于等待下一步操作的状态,CPU利用率不
DeepSeek 新论文作者名单超 130 人,这规模在开源团队里真少见。搞过分布式训练的都知道,让130个人在一个项目里不掉队,比单纯堆参数更考验工程能力。从2月放出 Flash MLA 到8月 App 支持生成长图,他们节奏没乱,靠的就是底层积累。 很多人只盯着参数量,其实名单里藏着真正跑通全链路的工程师。开
2026-09-30 08:34
DeepSeek 新论文作者名单超 130 人,这规模在开源团队里真少见。搞过分布式训练的都知道,让130个人在一个项目里不掉队,比单纯堆参数更考验工程能力。从2月放出 Flash MLA 到8月 App 支持生成长图,他们节奏没乱,靠的就是底层积累。 很多人只盯着参数量,其实名单里藏着真正跑通全链路的工程师。开
Arena 那个匿名 gemini-3.8-flash 被猜是 Gemini 4 Pro 马甲,172.7K 播放量确实炸了。网传基准四项第一,但无官方出处、无配置、无复现,按惯例先打七折看。 本地跑过 32B 量化模型的都知道,没复现链接的泄露基准水分极大。网传价格和快 30% 的速度也都是社区推测,ai.google.dev 至今没确认 4 Pro
2026-09-30 20:44
Arena 那个匿名 gemini-3.8-flash 被猜是 Gemini 4 Pro 马甲,172.7K 播放量确实炸了。网传基准四项第一,但无官方出处、无配置、无复现,按惯例先打七折看。 本地跑过 32B 量化模型的都知道,没复现链接的泄露基准水分极大。网传价格和快 30% 的速度也都是社区推测,ai.google.dev 至今没确认 4 Pro
Agent 每做一步都叫大模型,未必划算。刚读 Sydney Runkle 写的 Jev/LangChain 长文:模型路由、工具调用前的分类,可以交给只返回选项或分数的模型;真正需要解释和生成时,再用语言模型。 我觉得关键是边界。选项有限、错判代价可衡量的步骤,适合用轻量分类器。涉及外部副作用的工具调用,概率分数
2026-09-25 19:03
Agent 每做一步都叫大模型,未必划算。刚读 Sydney Runkle 写的 Jev/LangChain 长文:模型路由、工具调用前的分类,可以交给只返回选项或分数的模型;真正需要解释和生成时,再用语言模型。 我觉得关键是边界。选项有限、错判代价可衡量的步骤,适合用轻量分类器。涉及外部副作用的工具调用,概率分数
三个订阅,一个漏洞,六千五 Hacktron AI 那个 CTO 有句话挺实在的。他说"我不觉得我们比他国威胁者更聪明,我们只是三个拥有 Claude 和 Codex 订阅的人。"三个人。没有国家背景,没有内部渠道,就是付了月费。 事情从 7 月 23 号开始。他们发现了 Discourse 处理特定图像文件的一个漏洞,编号 CVE-2
2026-09-23 08:47
三个订阅,一个漏洞,六千五 Hacktron AI 那个 CTO 有句话挺实在的。他说"我不觉得我们比他国威胁者更聪明,我们只是三个拥有 Claude 和 Codex 订阅的人。"三个人。没有国家背景,没有内部渠道,就是付了月费。 事情从 7 月 23 号开始。他们发现了 Discourse 处理特定图像文件的一个漏洞,编号 CVE-2
第一页
下一页
作者信息
秦叶热谈科技
一键关注,天天见
热门分类
推荐
热榜
军事
NBA
体育
社会
明星八卦
娱乐
财经
科技
汽车
历史
国际
游戏
动漫
公益
搞笑
商业
互联网
数码
国际足球
房产
家居
时尚
科学探索
职场
育儿
股票
教育
影视
情感
热点
中国军情
武器
中国南海
中国足球
亚洲杯
科比
综合体育
CBA
投资
楼市
大咖秀
外汇
创业
风口
SUV
豪车
概念车
优惠
新能源
美国
欧洲
朝日韩
俄罗斯
孕期
街拍
恋爱攻略
婚姻
正能量