挖宝挖宝,Anthropic 工程师 Lance Martin 教你如何提示现在的模型。
出自他 10月12日在 AIE 上的演讲。
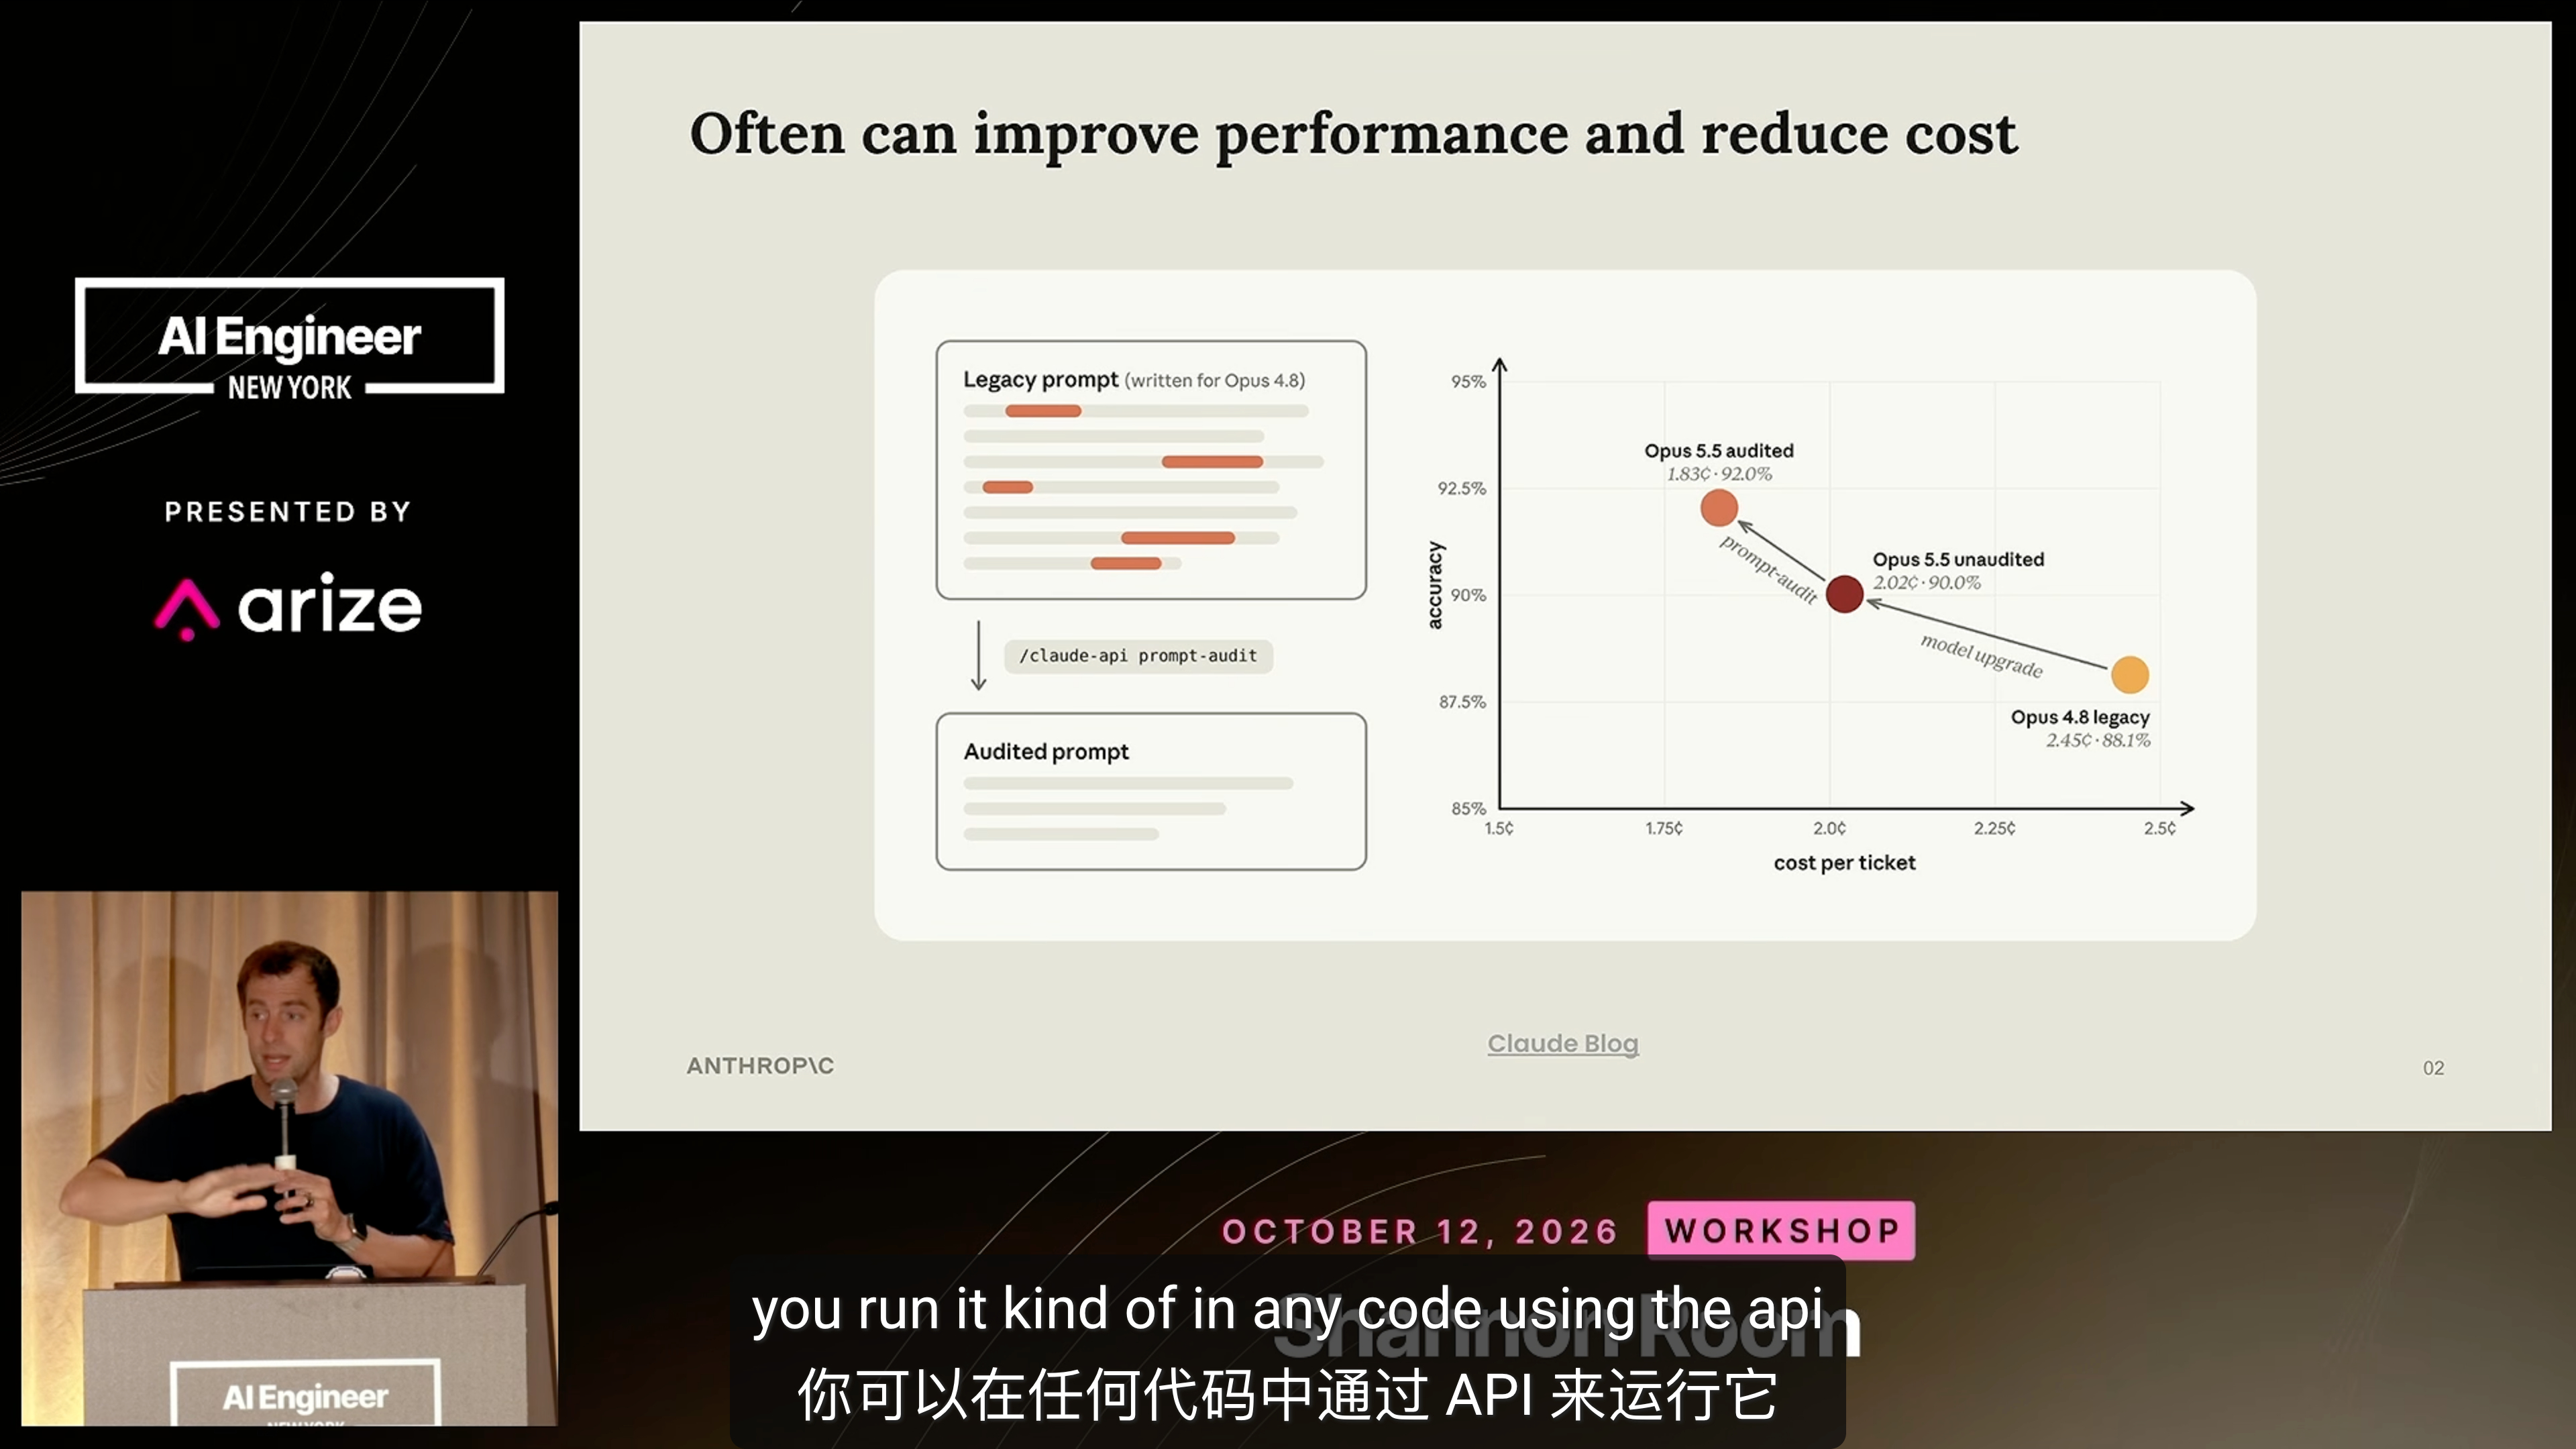
1、提示词调优(图1)
提示词会像代码一样积累历史包袱。以前有帮助的写法,换到更强的模型上,可能增加消耗,甚至降低效果。
例如“逐步思考”“务必极其全面”;不断要求模型“再检查一遍”;过度规定思考过程;互相矛盾的规则。这些在旧模型下可能有用,但是会伤害当前前沿模型的表现,并增加成本。
使用 /checkup prompt-audit(如果使用的是 api,命令换成/claude-api prompt-audit),可以优化 skill、提示词,A\ 的数据显示,使用这个命令之后,Opus 5.5 的正确率从90%提升到了92%,成本也有所下降。
---以下内容主要是针对 agent 开发者,普通用户可以不用看了
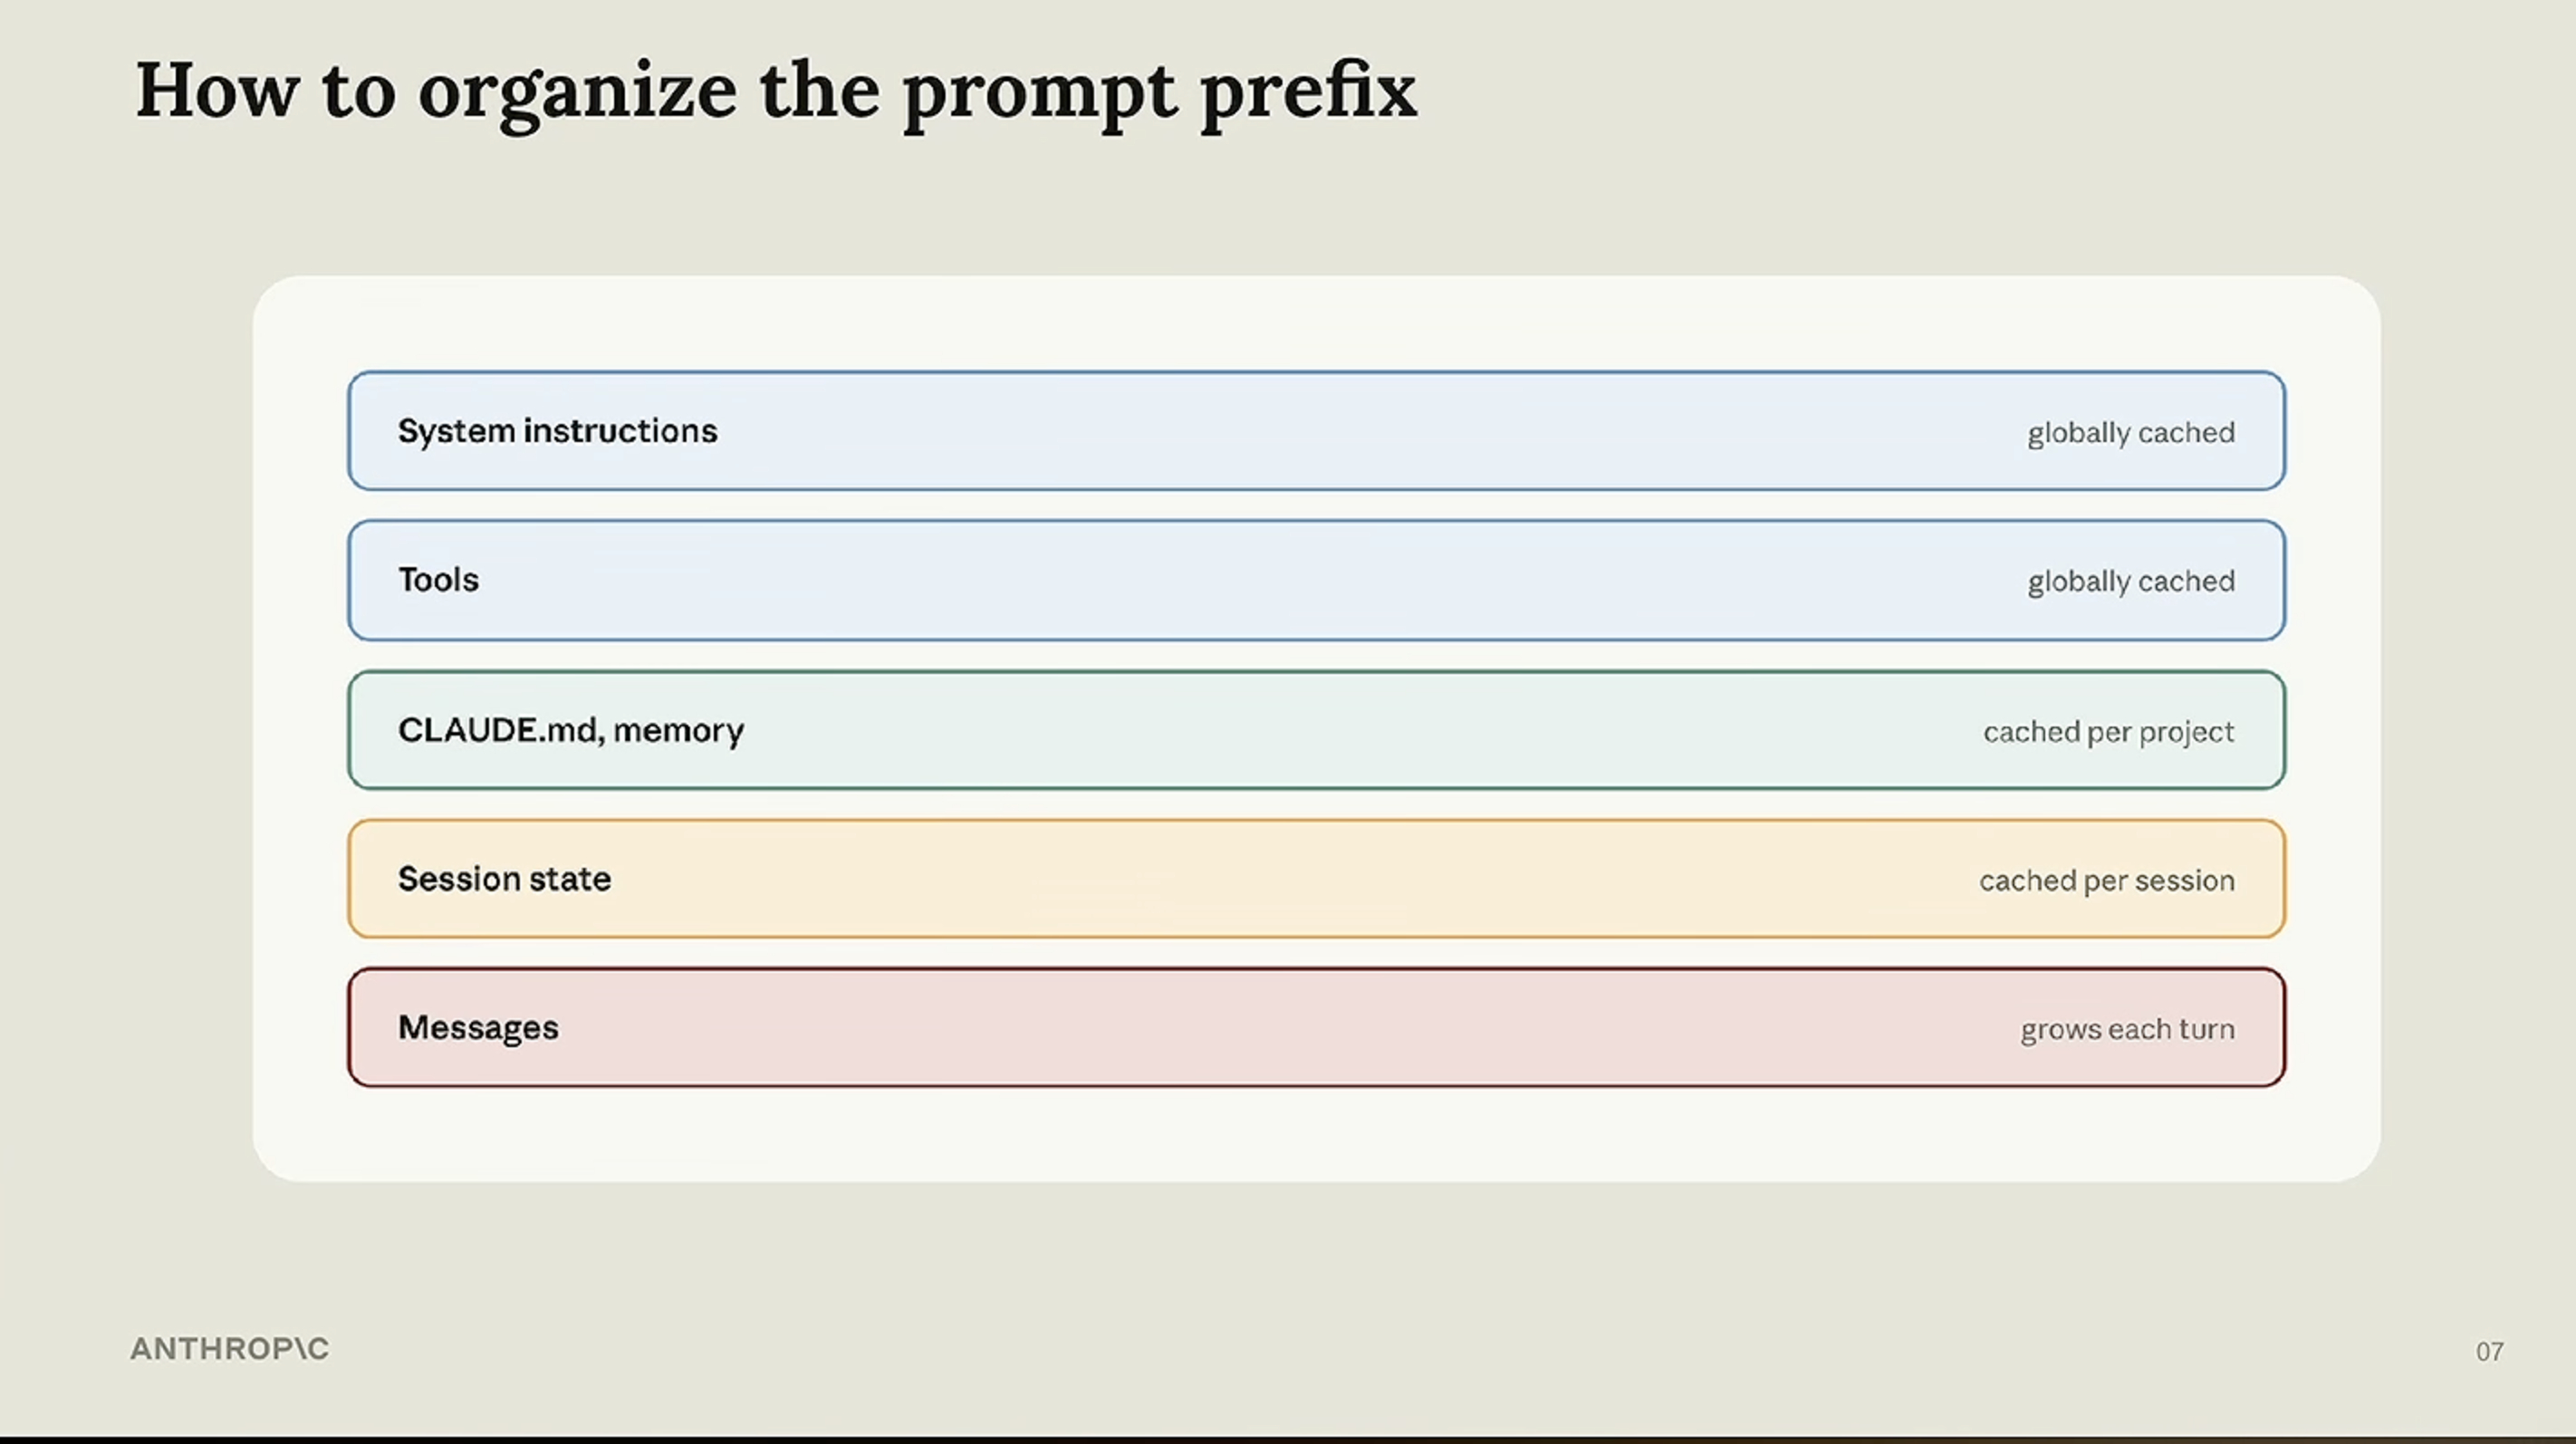
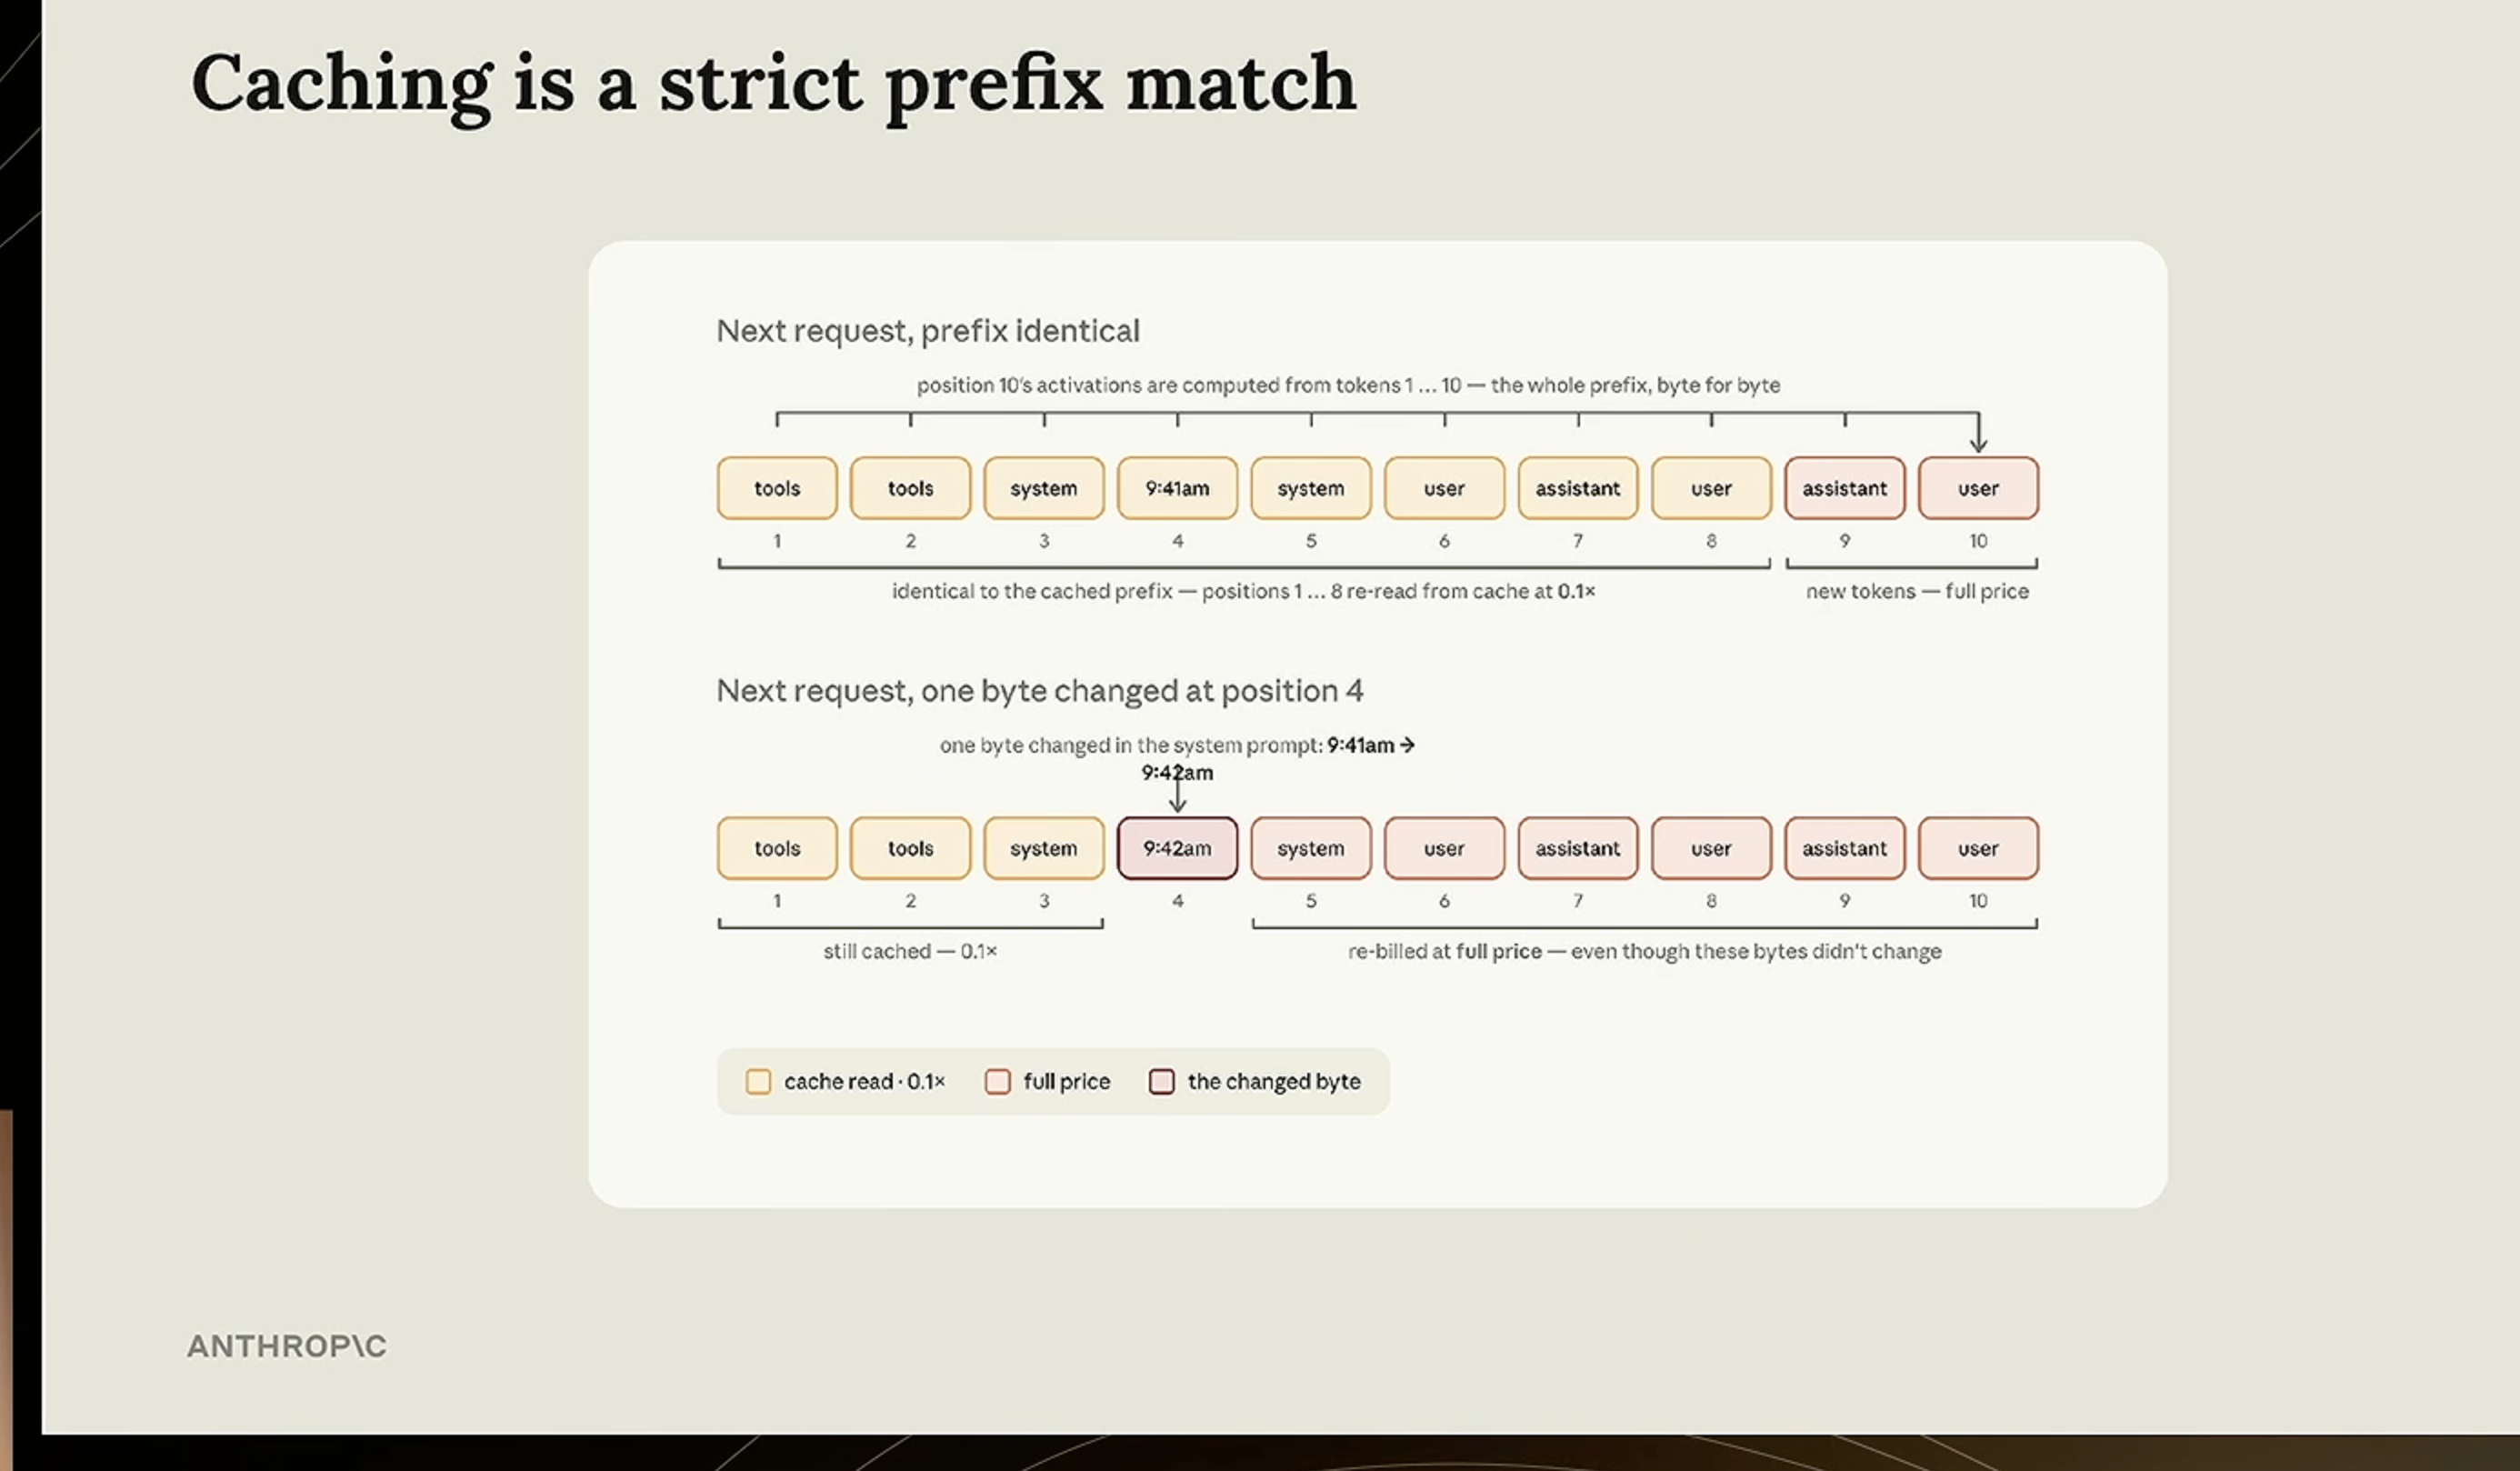
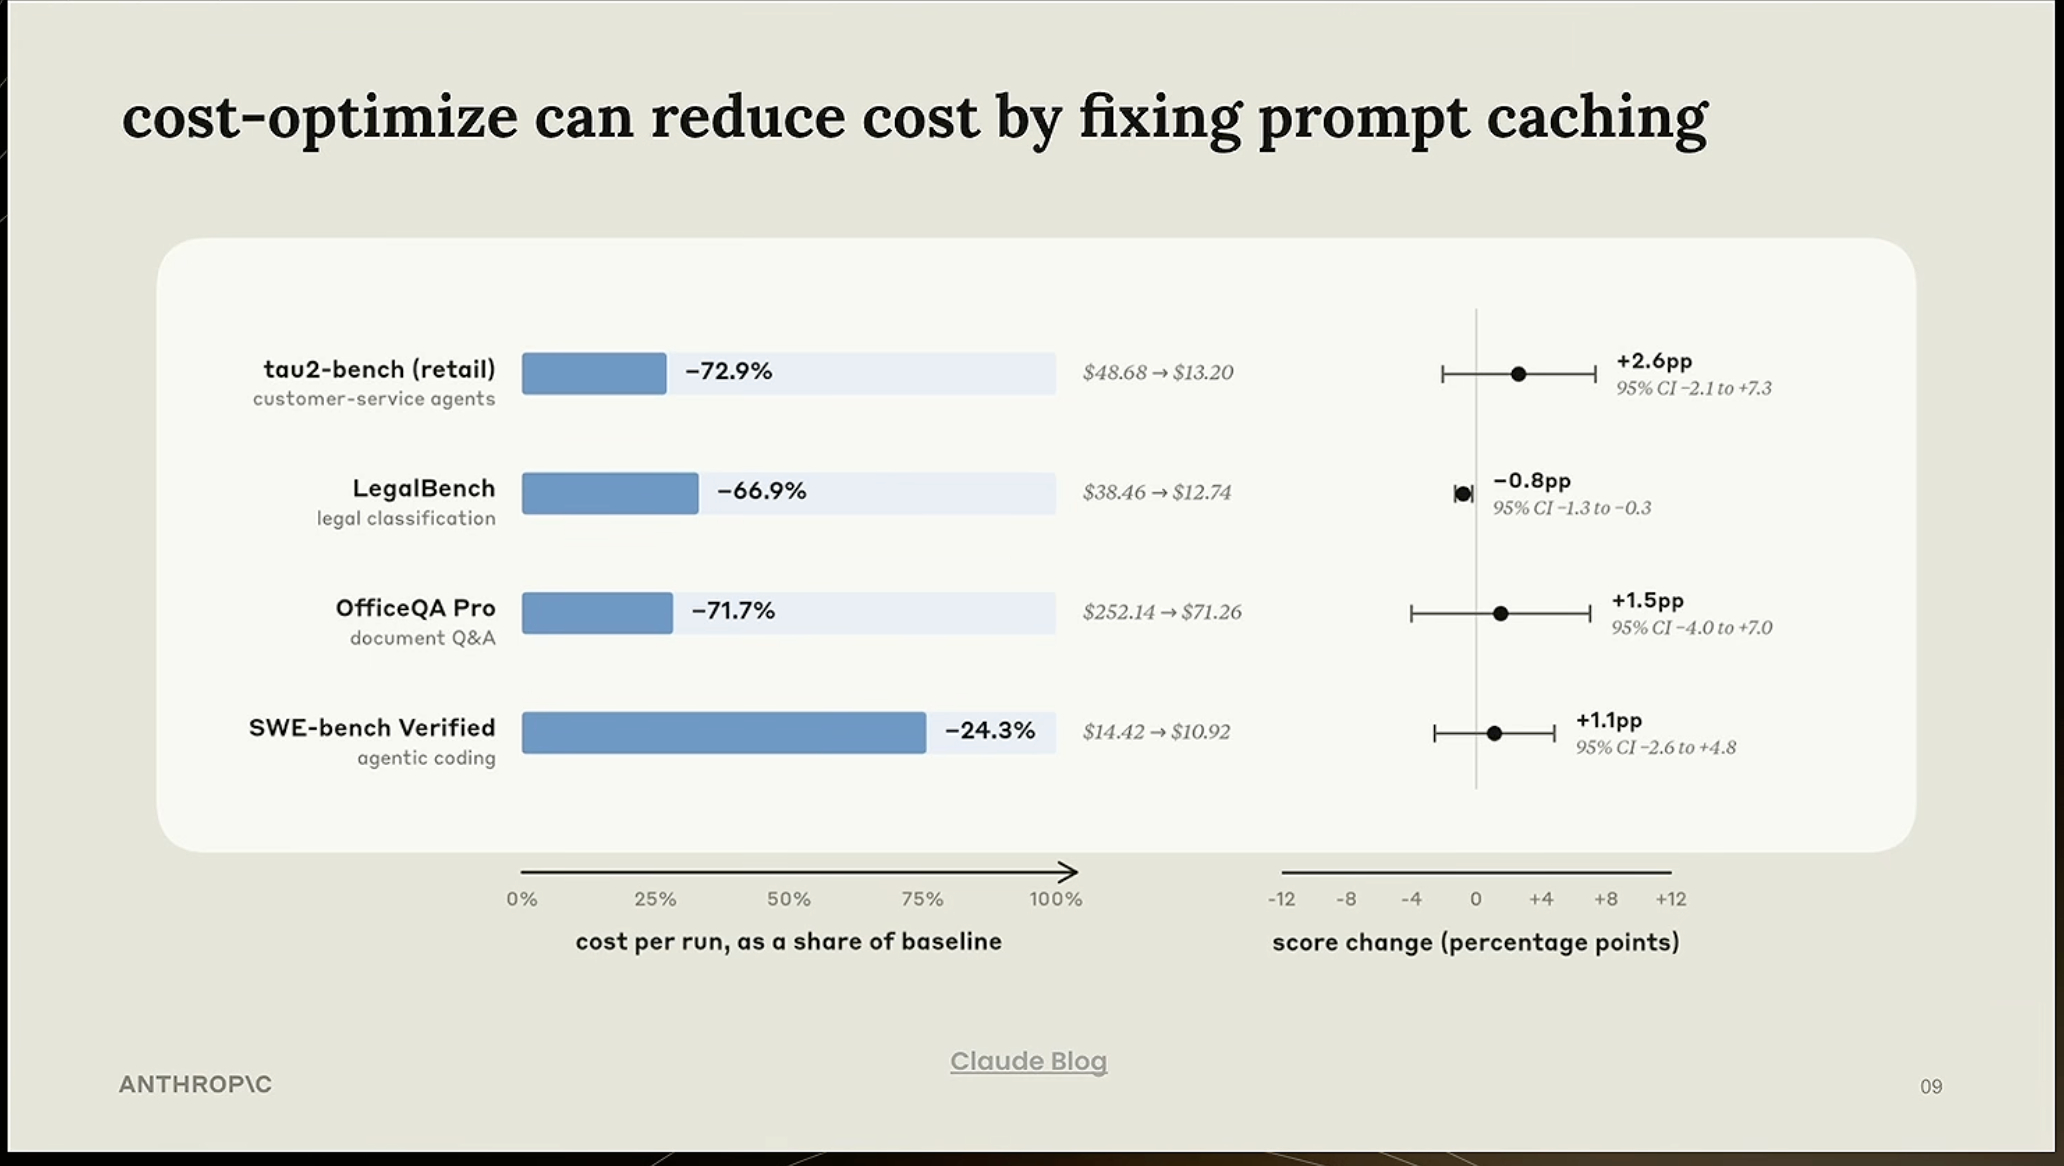
2、使用提示缓存(图2-4)
提示缓存采用严格的前缀匹配,即使发生一个字节的变化,提示缓存都会失效,要注意。这对于使用 api 来构建应用的人来说,很关键。
如果你在使用 claude api 构建,工作台可以查看相关数据,也可以通过这条命令来优化自己的提示缓存:/claude-api cost-optimize。A\ 团队在不同 harness 上评测的时候发现,通过这条命令,可以降低 72%的成本,但性能几乎不变(因为有些 harness 没有优化提示缓存)。
3、良好的评估设计
前沿 Claude 很擅长自我纠错,只要给它一个结构清晰的评估,它就能自己去爬山优化。
好评估有四个特征:- 换更强的模型,分数会上升;- 给更多思考预算,分数会上升;- 最强模型也还有提升空间,没有饱和;- 多次运行之间方差小。
最常见的坑是评估里混着一堆有歧义、本来就无解的题。看起来还有 20% 的提升空间,其实哪个模型都拿不到,结果白白烧了大量 token 去爬一个实际已经饱和的评估。
使用 /claude-api build-eval 来构建评估。它不限定你的数据放在哪里,可以接任何 tracing 工具。给它你的问题、关注点和原始 trace,它会一步步带你建评估集,和你一起检查评分标准。
4、爬山
爬山最大的风险是过拟合:在评估上分数很好看,一上生产就没效果。比如某道题需要 OCR,于是在 harness 里加了个 OCR工具,可生产环境根本用不上;或者提示词被调成了只适合评估集措辞的样子。
/claude-api hill-climb的做法是把评估集分成训练集和测试集。爬山时只看训练集里的失败案例来决定怎么改,每一轮同时报告训练集和测试集的分数。如果训练集在涨、测试集不动,基本就是过拟合了。
这里有个很实用的经验:强模型配低 effort,往往比弱模型配高 effort 更省、效果也更好。聪明的人不用那么费劲就能把事做好,用的 token 反而更少。Lance 的建议是先试 Opus 5.5 low,不够再往上调,别一上来就开 max。
另外,爬山不保证收敛。卡住几轮之后,这个 skill 会把剩下的失败案例聚类分析,经常发现卡住的原因是题目有歧义或评分有问题,而不是 Claude 能力不够。
5、设计能最大化发挥 Claude 能力的 harness
2024 年 Claude 3 Opus 只能自主工作约 4 分钟,2025 年的模型能做 1–2 小时,现在已经能连续做一到两天的任务。任务时长变了,harness 的要求也跟着变,可靠性和安全性变得非常关键。
这就是 Claude Managed Agents 的设计思路:把"大脑"(harness)和"手"(沙箱)分开。
- 会话日志是独立的、只追加的对象。harness 挂了或者沙箱挂了,都能从日志恢复,不会出现跑了一夜、半路崩掉、所有状态都丢了的情况;- 密钥放在 vault 里,Claude 可以引用 API key,但看不到明文。一个连续跑好几天的 agent,直接拿着敏感密钥确实让人不放心。Lance 和 CJ 写过一篇博客,用定时部署、密钥管理、记忆这些组件搭了一个自动汇总信息并发到 Slack 的 agent。在 Claude Code 里运行 /claude-api,把博客链接(claude.dev/blog/building-effective-agent-automations)丢给它,就能把这个示例直接跑起来。
视频链接:网页链接