FreeToken项目Logo
项目是什么FreeToken不是聊天前端,也不是一个新的大模型,而是一套把开源模型跑在本地电脑上的推理引擎。它专门面向“混合专家模型”(MoE):这类模型的总参数量很大,但每次生成内容时只会激活其中一部分专家。真正的难点,是如何安排显卡显存、系统内存和CPU之间的分工。
FreeToken把消费级显卡、CPU、主机内存和带宽统一调度,目标是在个人电脑上运行更依赖数据中心的模型。官方README称它可在游戏PC上运行290B以上模型。
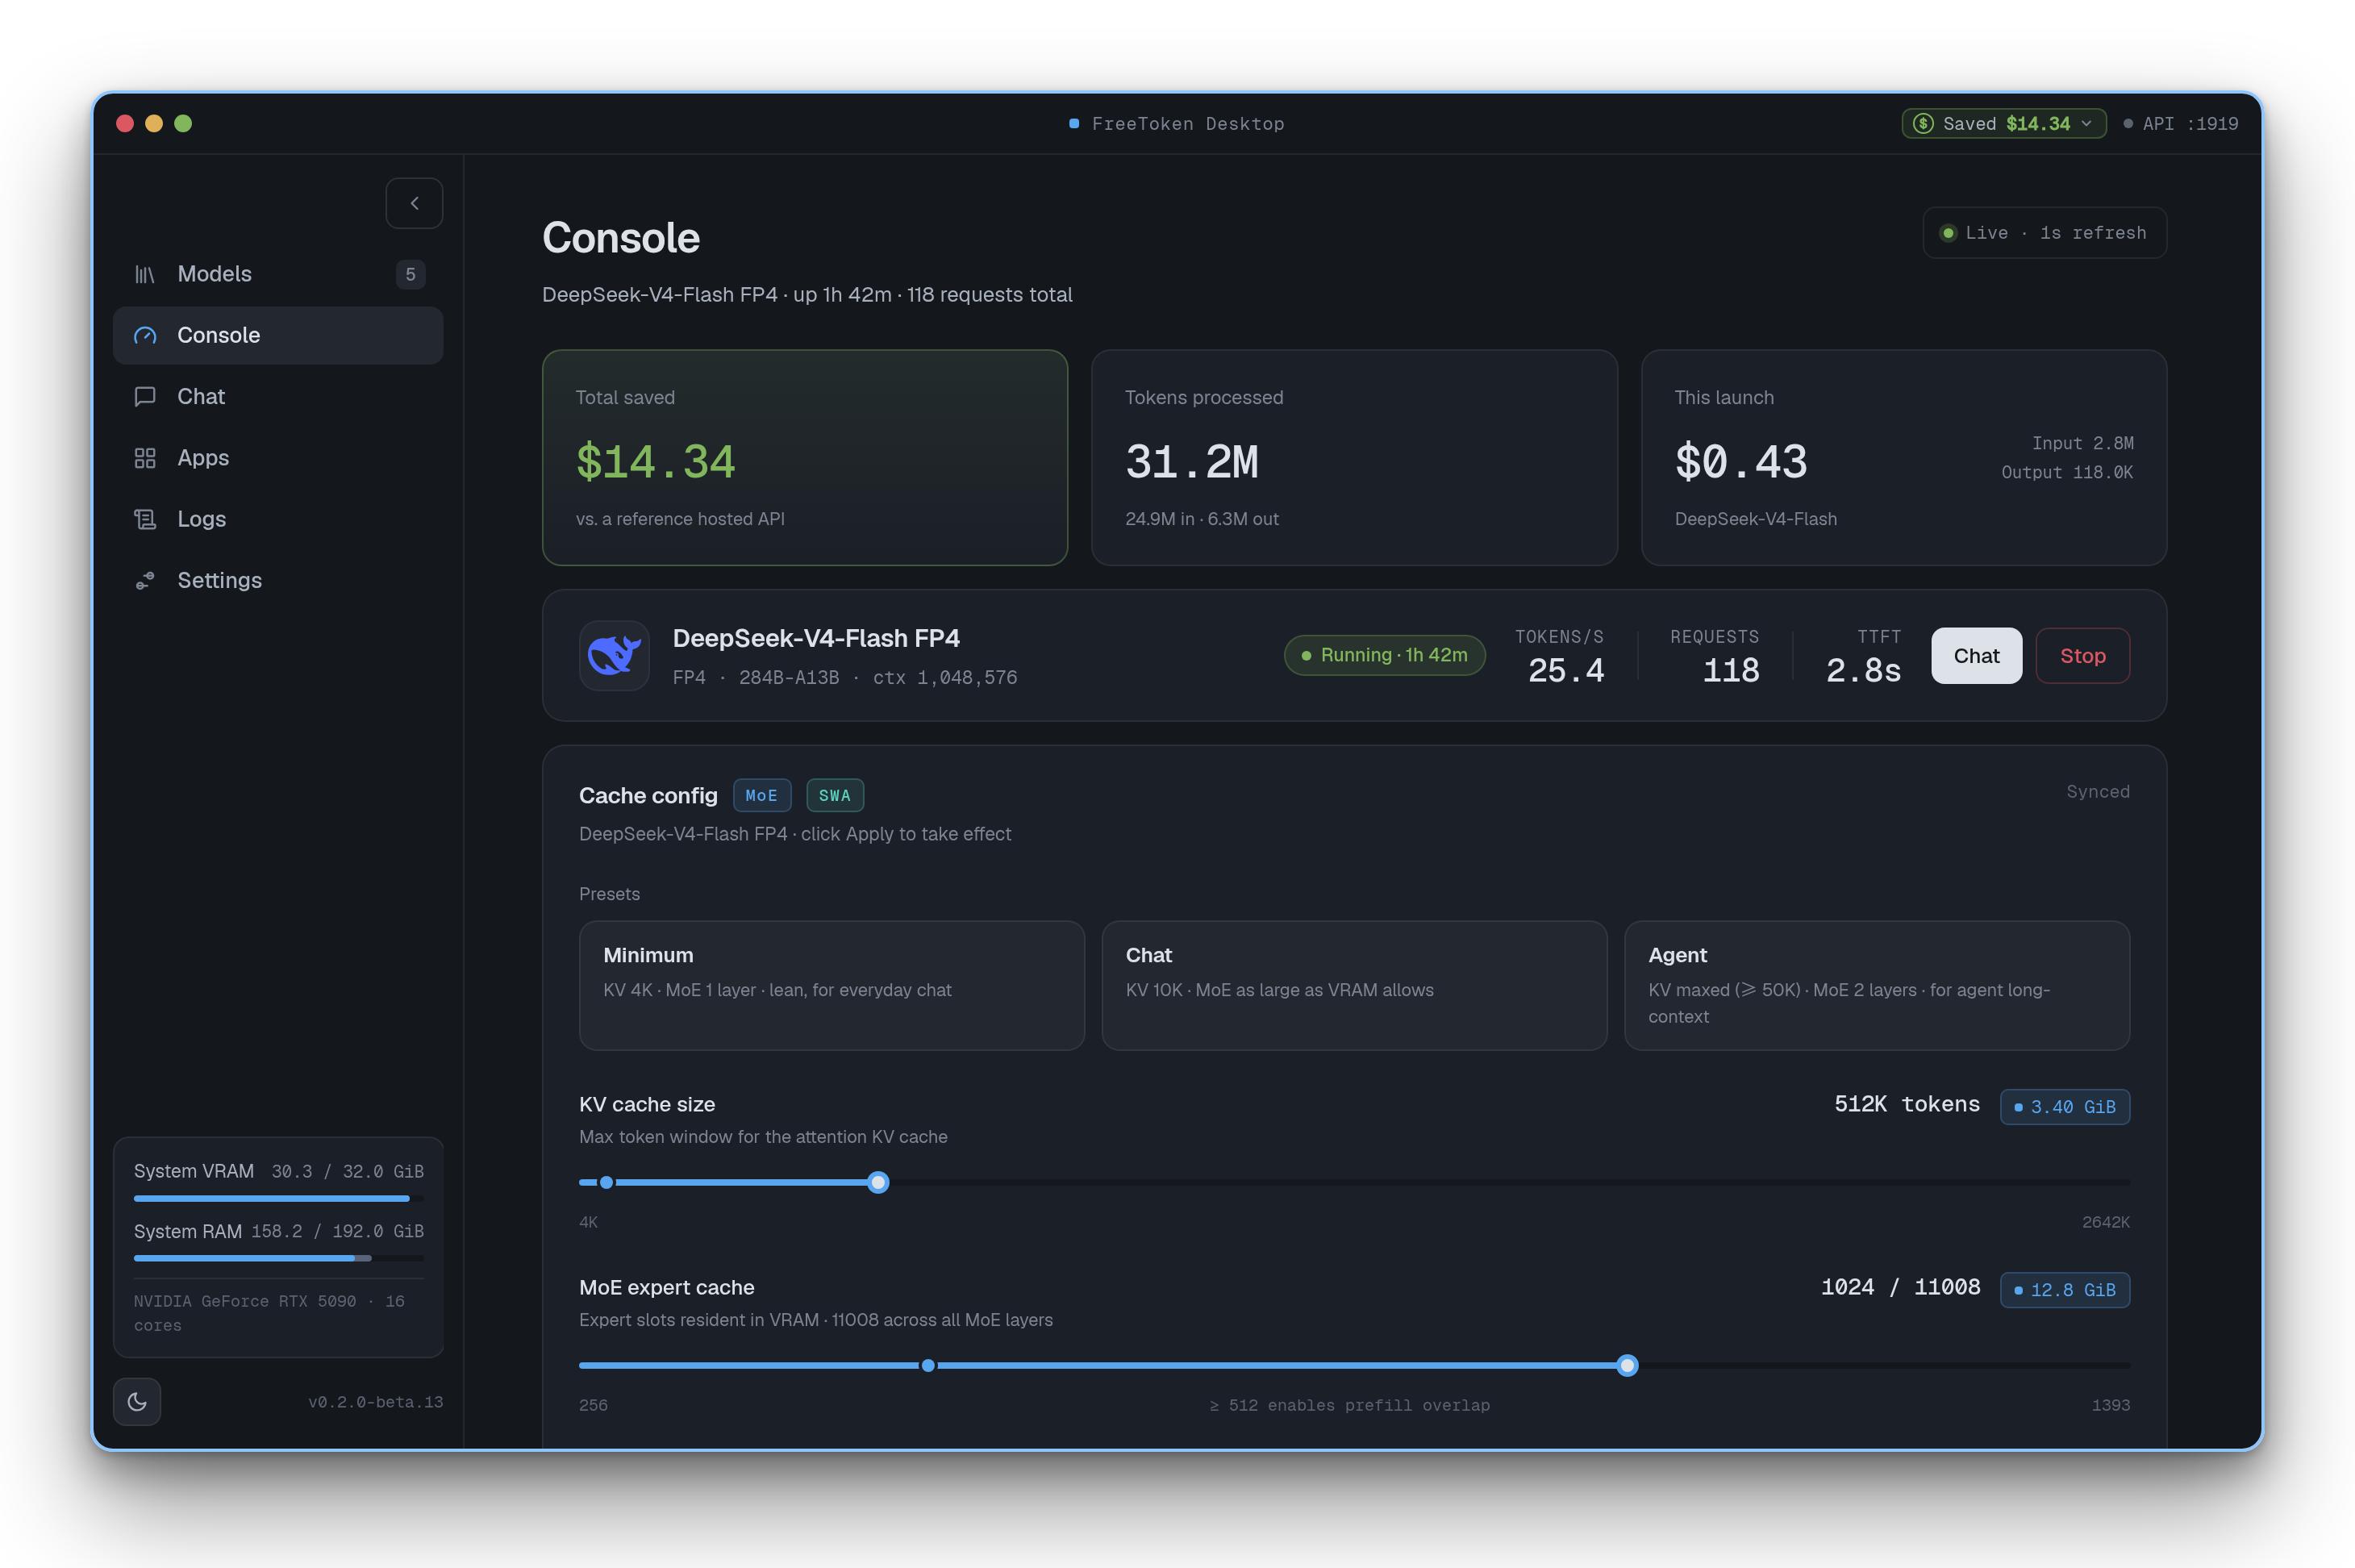
核心亮点让显卡和内存协同工作:根据机器实际带宽,动态决定模型专家由GPU计算,还是从主机内存调入,避免固定分配方式拖慢速度。为长对话优化:它会缓存已经处理过的上下文。Agent连续调用工具、修改任务上下文时,可以减少重复计算。显存可以动态调整:在专家缓存和对话历史缓存之间重新分配空间,不必重启引擎或重新加载模型。接入现有工具:支持兼容OpenAI和Anthropic格式的接口,可以连接编程Agent和其他工具调用程序。提供桌面版和命令行:官方页面提供Windows、Linux桌面版;命令行则可通过uv或pip安装。适合谁用它适合有NVIDIA RTX 30、40或50系列显卡,想本地运行大模型、编程Agent或工具调用应用的人。本地部署也更适合关注数据位置、调用成本和网络稳定性的开发者。
命令行安装要求Linux x86_64、NVIDIA GPU、580以上驱动和CUDA 13。Apple Silicon和AMD不在这份要求内,Mac用户需先确认桌面版支持,不能照搬Linux教程。
为什么值得关注FreeToken的价值不只是“把模型塞进显存”,而是重新安排整台电脑的资源。官方论文称支持20多个MoE模型,覆盖8GB笔记本显卡到工作站;报告了35B在笔记本、284B在游戏PC、753B GLM-5.2在单张工作站显卡上的运行结果。实际速度仍取决于硬件和模型格式。
项目还很新,最新版本为v0.1.2。它采用Apache-2.0许可证,适合愿意配置环境、验证模型并接受快速迭代的开发者;想开箱即用可先试桌面版。
小编点评
FreeToken把本地推理的竞争,从“显卡有多大”推进到了“整台机器怎样协同工作”。
项目地址:
https://github.com/FlashML-org/FreeToken