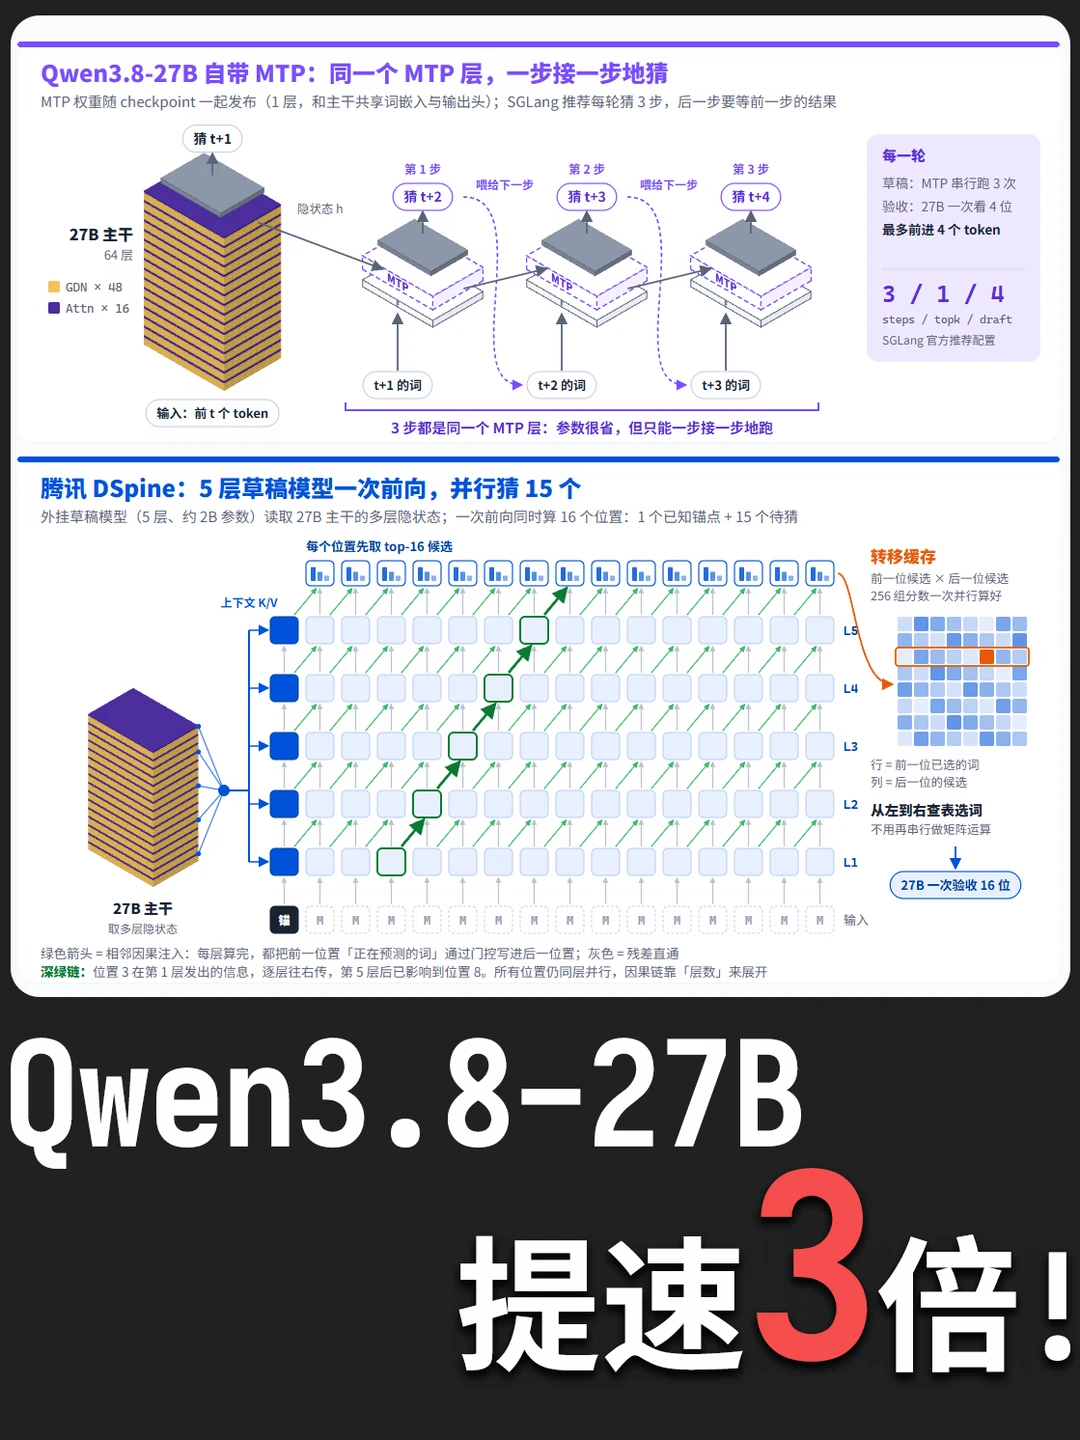
我以为投机解码这块已经卷到头了, 没想到腾讯又整出了新活. 腾讯优图刚在 HuggingFace 上放出了 Qwen3.8-27B-DSpine-b16 这个新草稿模型. 直接从原来 MTP 加速的1.6倍左右提升到了3倍. 官方测试来到了 805 tps (8并发). 官方没说是什么卡, 但是从用的 FlashAttention 3 来看应该是 Hopper 架构的卡.
他是怎么做到的的呢? 其实很简单, 大家都知道传统MTP最大开的是 MTP3 (一次猜3个token), 这个草稿模型开到了16, 然后接受长度能到7.2 (GSM8K 数学题测试集).
给大家讲一下 DSpine 最亮眼的几个技术细节:
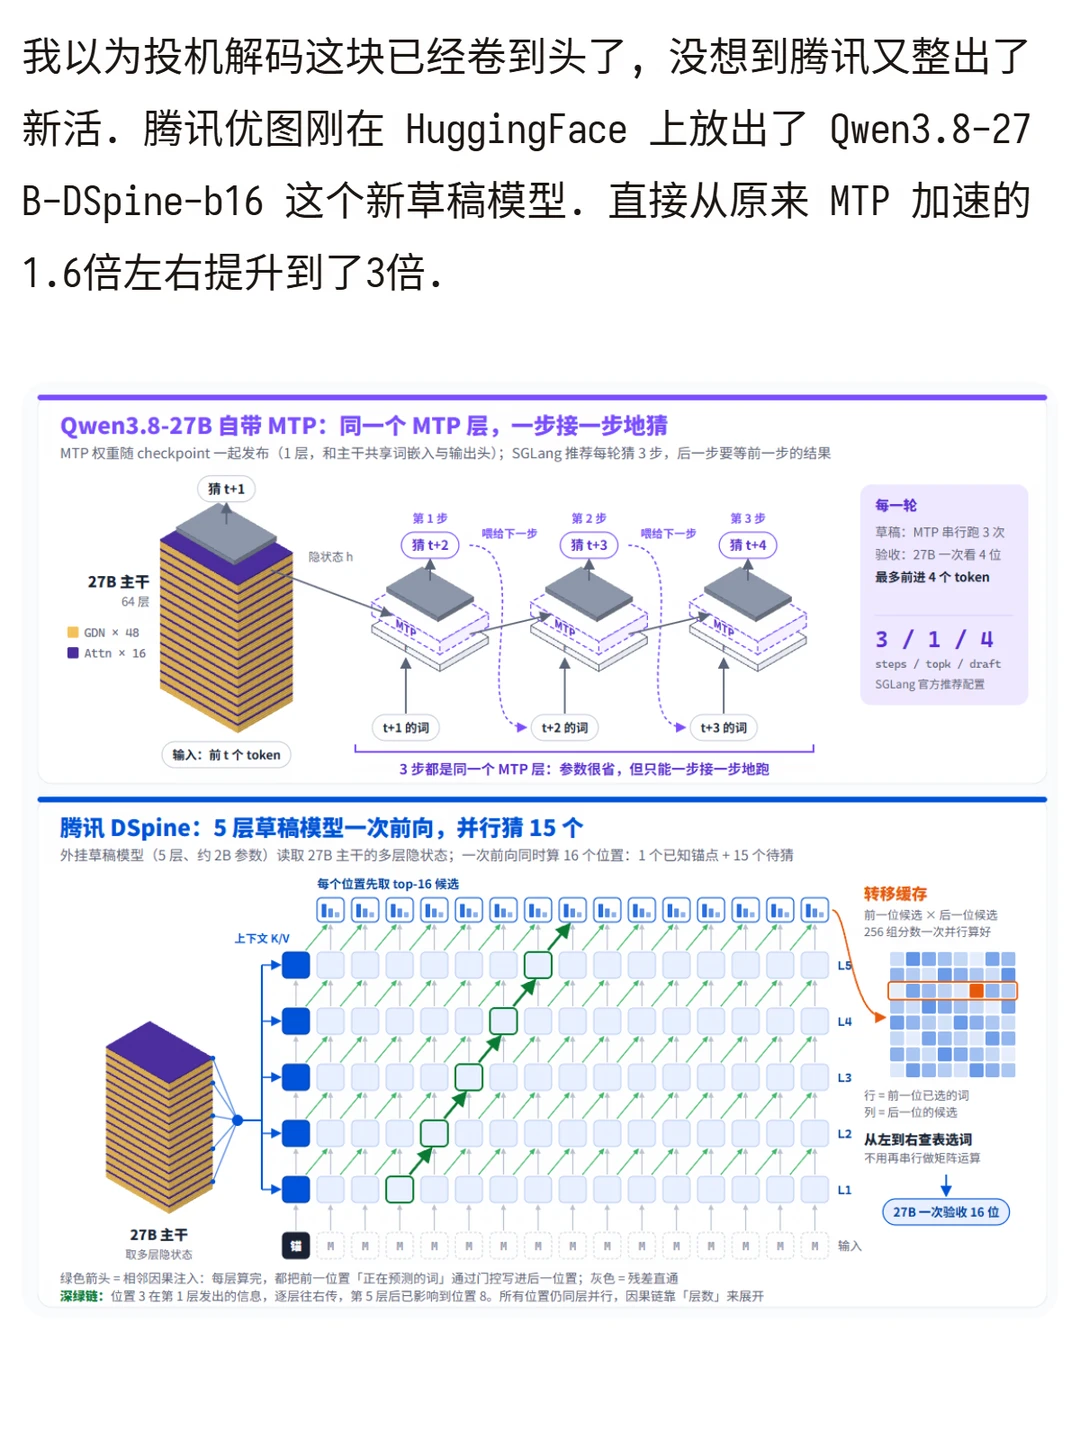
- 草稿模型只有 5 层 (约 2B 参数), 一次前向「并行」猜 16 个位置 (1 个已知锚点 + 15 个待猜), 而不是一个一个往后猜
- 用「相邻因果注入」在每一层都把前一个位置「正在预测的词」写给后一个位置, 让因果依赖沿着网络深度一层层传下去
- 用「转移缓存」把相邻两个位置 16×16 = 256 种候选组合的分数一次性并行算好, 选词时直接查表
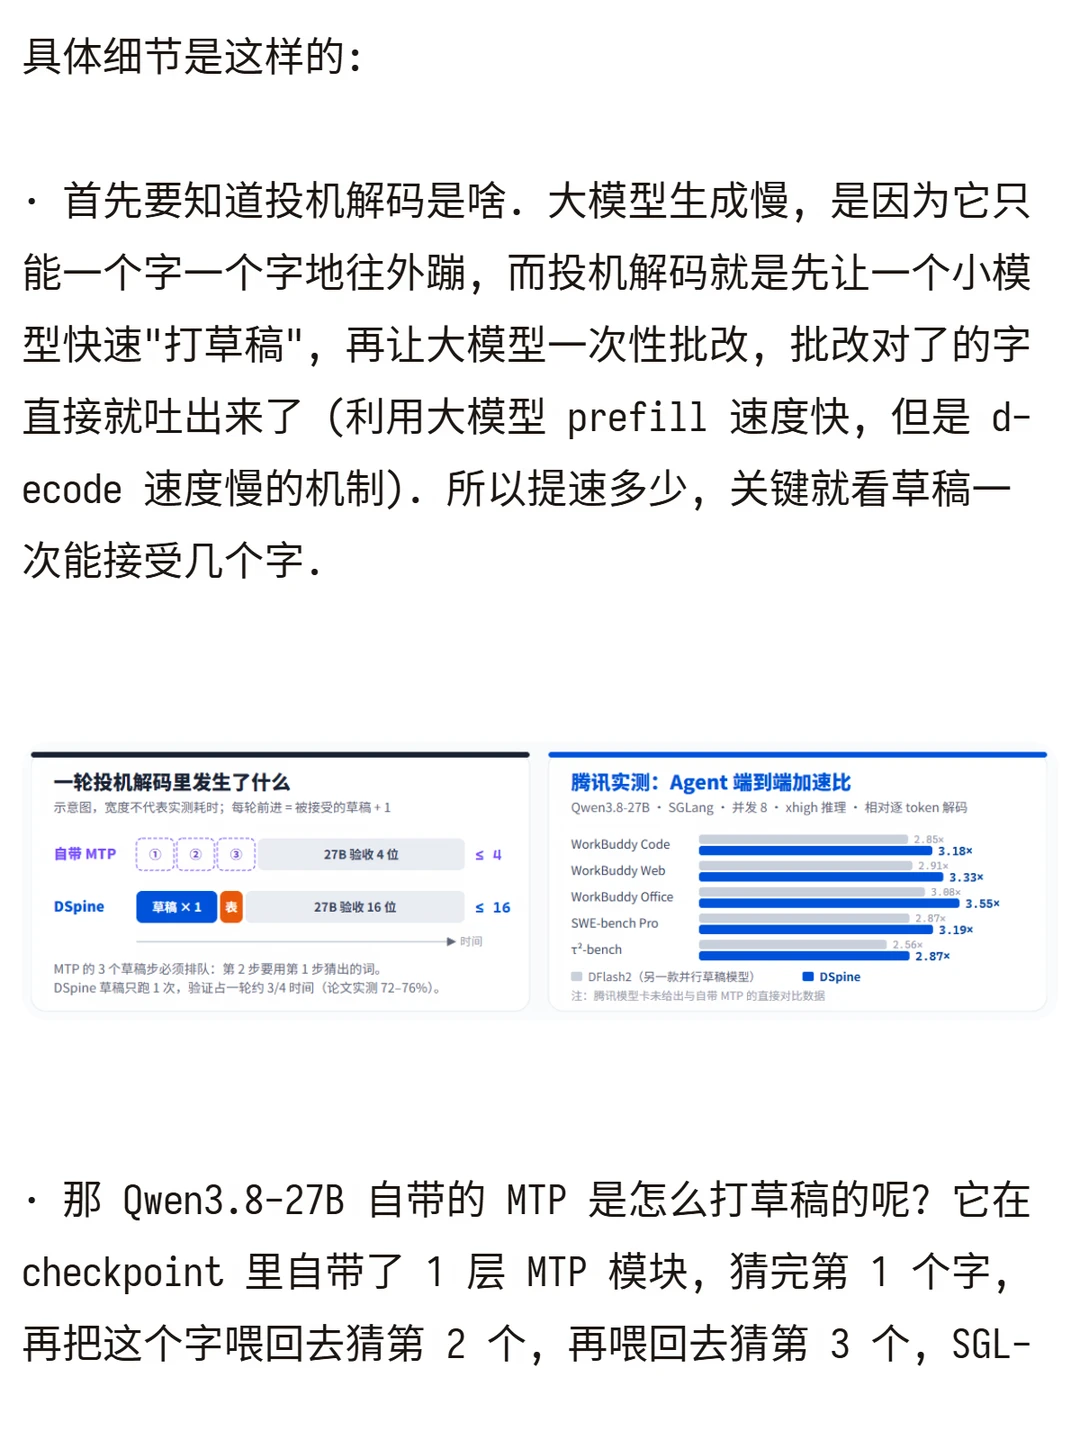
最后论文里实测了耗时, 5 层注入加起来每轮最多只多花 0.15 ms, 整轮耗时和 DFlash2 基本持平, 但这样一顿操作每轮收下的字更多了, 所以速度更快了.
当然还是有需要注意的地方:
一方面 DSpine 是个独立的 2B 草稿模型, 要额外占一点显存, 不像 MTP 是 checkpoint 自带的开箱即用.
另一方面腾讯模型卡对比的是 DFlash2 和逐 token 解码, 并没有直接给出和 Qwen 自带 MTP 的对比数据. 而且投机解码在高并发下收益会下降 (论文里 8B 模型并发 32 时提速降到了 1.6 倍左右, 跟原装MTP差不多了), 所以更适合本地部署、低并发、追求单路速度的场景, 比如自己跑 Agent 写代码.
#腾讯 #腾讯优图 #Qwen #Qwen38 #投机解码