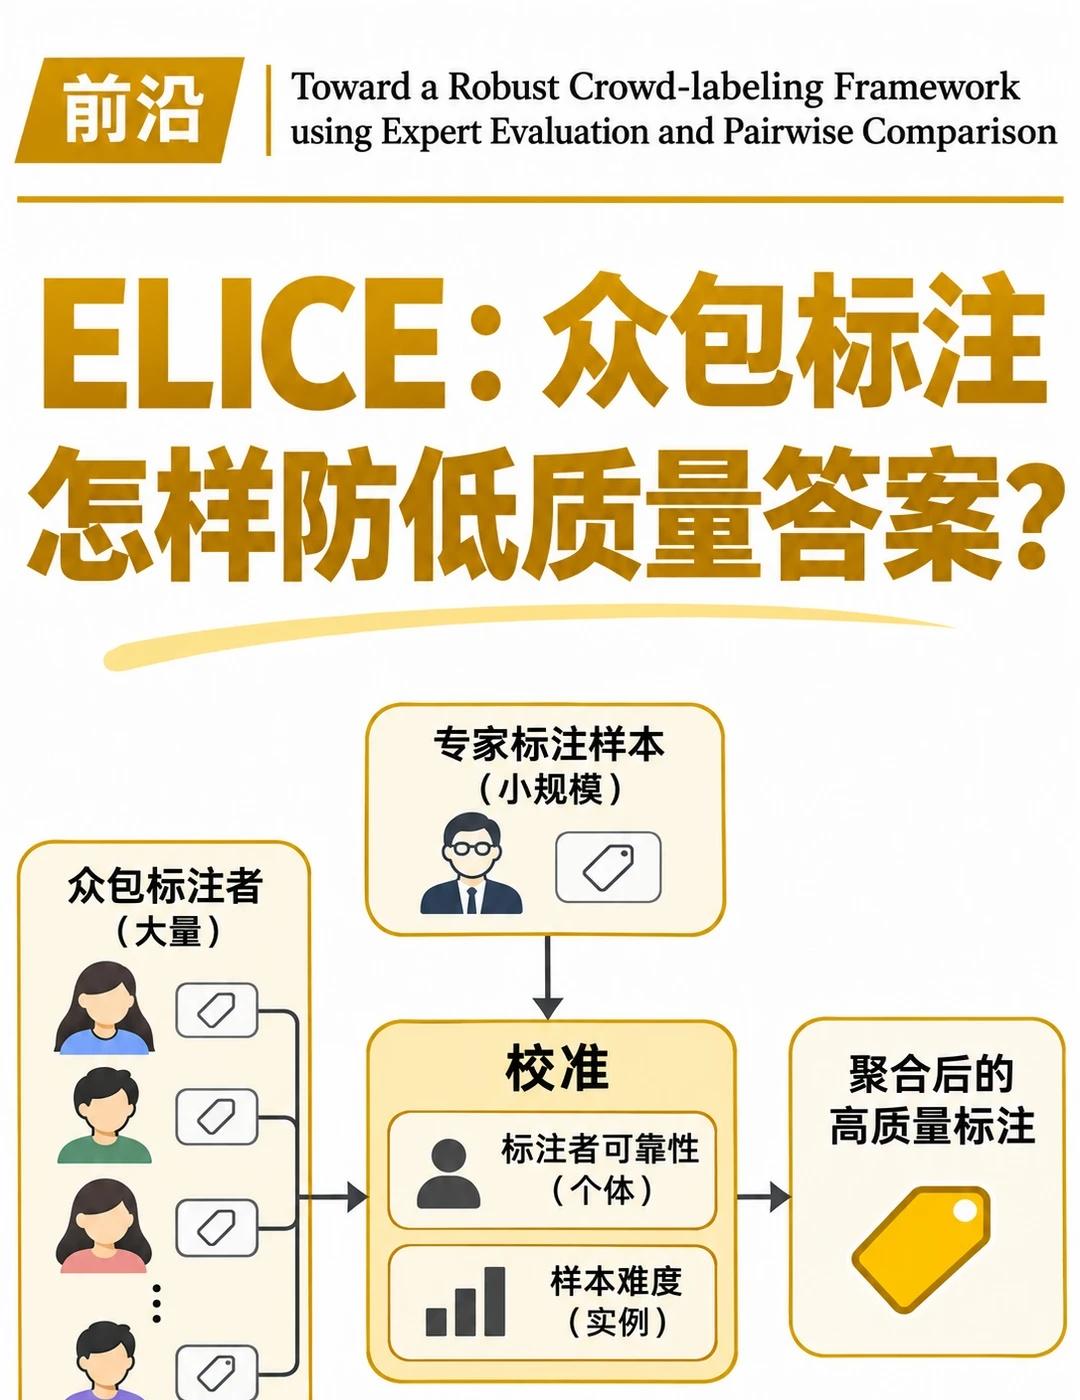
ELICE:众包标注怎样防低质量答案?
训练AI需要大量标签,但请专家逐条判断,成本往往很高。众包标注把任务分给许多人,能更快获得答案,却也会遇到能力参差、粗心甚至恶意标注。论文《Toward a Robust Crowd-labeling Framework using Expert Evaluation and Pairwise Comparison》讨论的正是:当部分答案不可靠时,怎样把众人的判断合成更可信的标签。
最直观的做法是多数投票。问题在于,五个人里若有三个人不熟悉某类样本,人数优势反而会放大错误。标注者的能力不同,样本本身的难度也不同:一张清晰图片与一张模糊图片,不能按同样方式衡量答对率。
作者提出 ELICE(Expert Label Injected Crowd Estimation)。它只请专家标注数据集中的一小部分样本,再利用这些参考答案估计每位众包标注者的能力,以及每个样本的难度。随后,系统把两类信息用于汇总大量众包标签。可以把专家标签理解成一把有限的校准尺:不要求专家做完全部工作,却让系统更清楚该信任哪些回答、哪些题目更容易引发分歧。
论文特别关注低质量或恶意标注者比例上升时的表现。已有研究指出,比例越过某个范围后,整体标注准确率可能突然明显下降,而不是缓慢变差。作者称 ELICE 的多种扩展版本能够推迟这种急剧下降,并在实验比较中取得更好的标注准确率。
另一项工作是给出专家标注数量的下界,用来讨论至少需要多少专家样本,才能估计众包能力与样本难度,并改善最终标签质量。这里的“下界”是理论分析中的条件,实际项目仍要看任务类型、标注者构成和数据分布,不能拿一个固定数量套用所有场景。
这篇研究发表于2016年,放到今天看依然有现实意义:高质量数据不只靠多收集,还要设计能识别噪声的标注流程。少量专家判断与大量众包结果如何配合,是数据质量管理中的基础问题。
论文:arXiv:1607.02174
AI前沿 数据标注 众包 机器学习