AI越聪明越烧Token吗
Fable 5.2上线后,Plotly发现了一个尴尬的事实:单价降了20%,总费用反而涨了。这不是个例,是行业正在集体撞上的墙。
答案不是简单的“越聪明越烧”,是聪明的方式变了。
第一层,任务本身变“长”了。 聊天机器人读一句、答一句,消耗有限。Agent式任务不一样,它要规划、要试错、要在出错后自己纠正、要在后台持续跑。Gartner的数据很直白:完成同一项任务,代理式AI消耗的token是基础聊天机器人的5到30倍。当一个任务从“回答一个问题”变成“办成一件事”,token消耗量级就跳了一档。
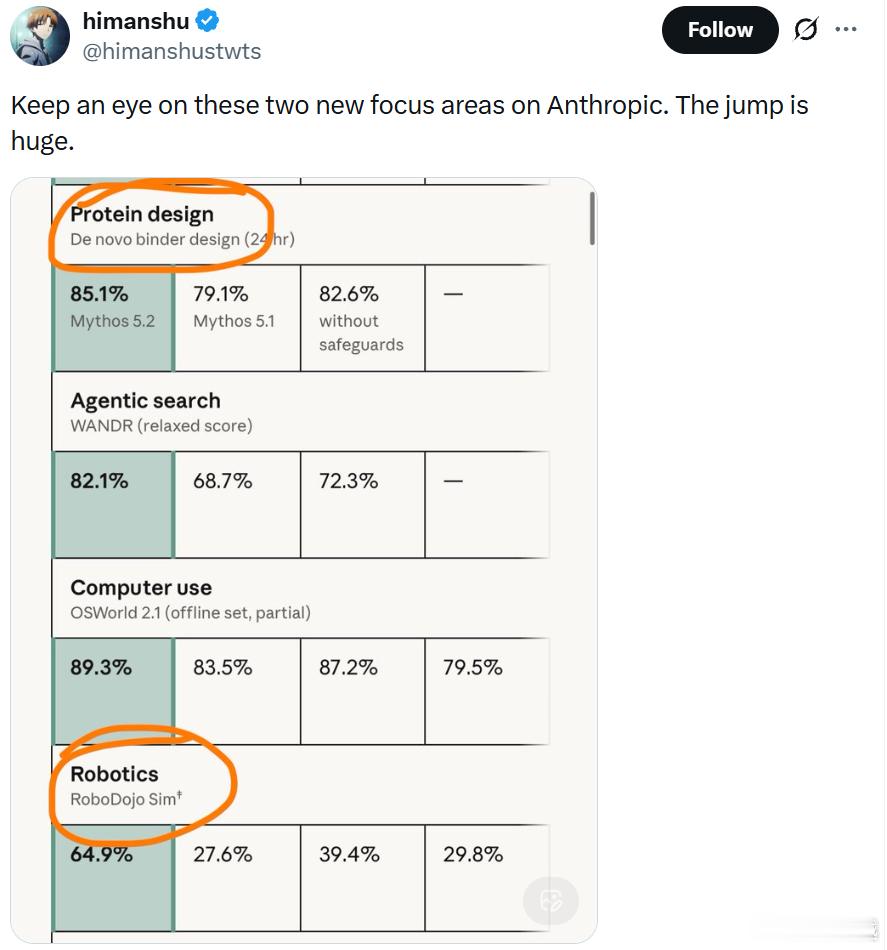
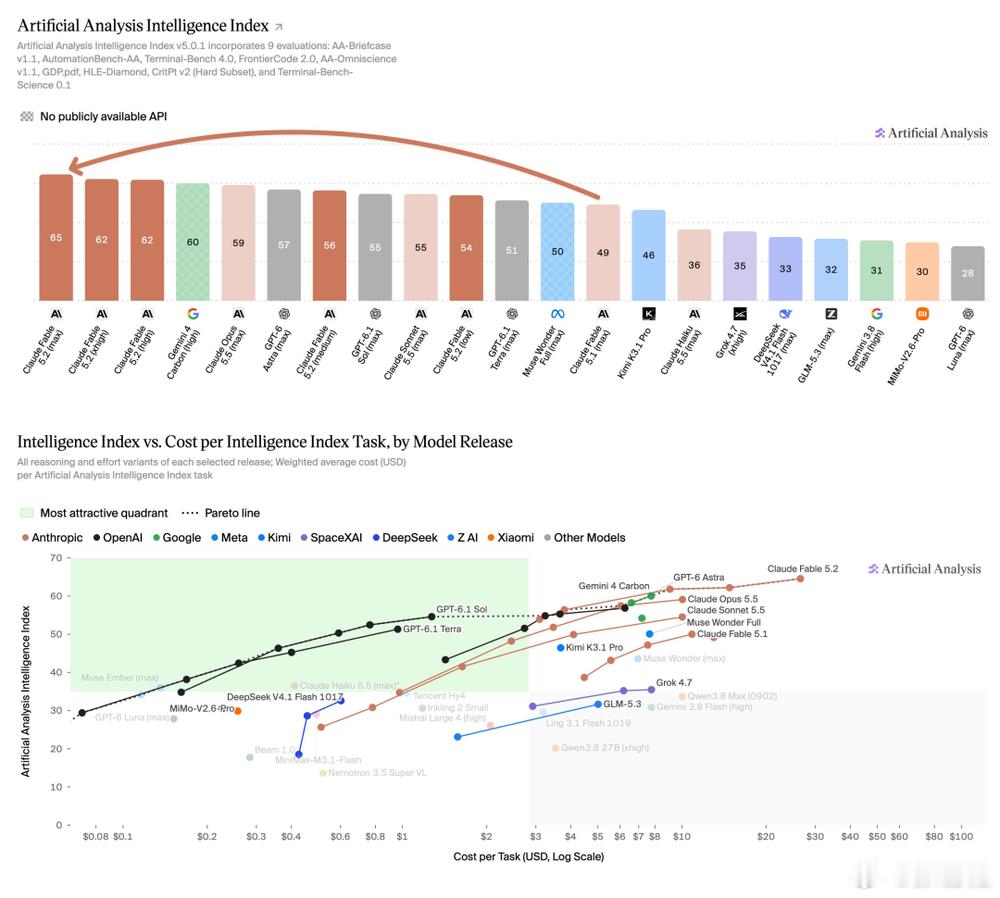
第二层,模型变“话痨”了。Fable 5.2在长任务上确实强,但它的内部思考、自我验证、多步推理都在烧token。Artificial Analysis测下来,单任务平均成本不降反升,最直接的原因就是它比以前“话痨”太多。一个游戏关卡跑了43小时、86.3亿token,账单超过1.4万美元。这不是模型变笨了,是它在用更多的token换更深的推理。
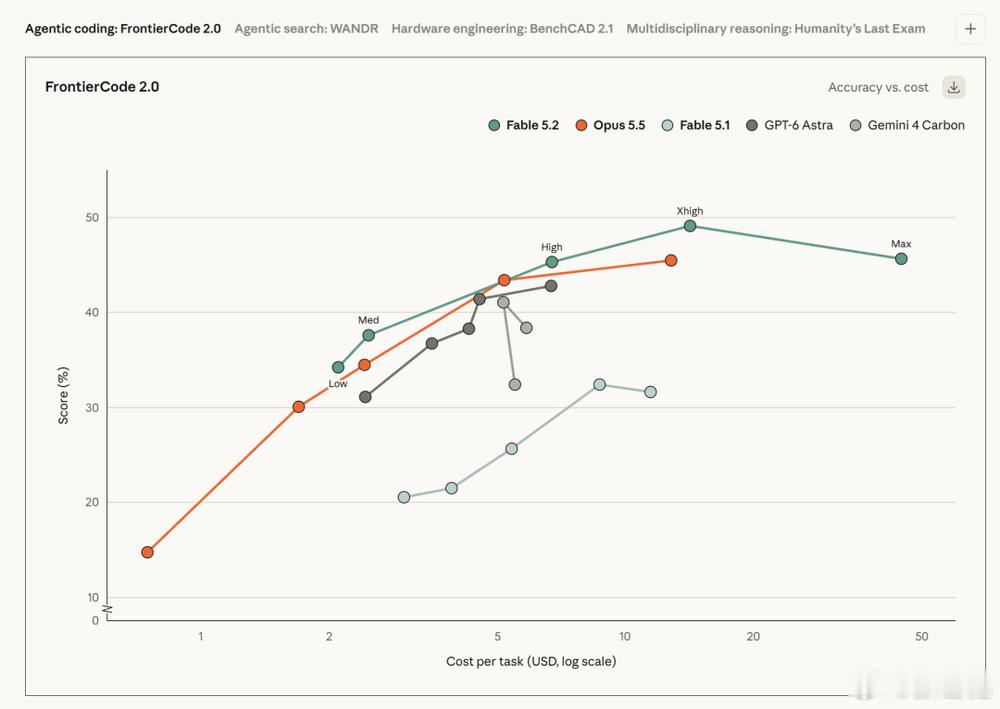
第三层,也是最容易被忽略的:你选的档位。Fable 5.2把effort开到High,成绩能接近Opus 5.5开到头,但每个任务成本只要后者一半左右。同一个模型,配置不同,账单能差出几倍。“聪明”的成本,有一部分是用户自己选的。
所以真正的问题不是“AI越聪明越烧Token吗”,而是“你为哪种聪明付费”。
短问答、快查询,便宜模型足够,没必要上旗舰。长任务、复杂推理,贵有贵的道理,但得看清楚每一分钱花在了哪一步。Gartner把这叫“推理悖论”——token单价长期在降,但代理式工作流的推理成本到2028年将增长超过5倍。省钱的方向不在等降价,在按任务分级、按需求配档。
Meta的Muse Ember走的是另一条路:单任务成本只有Claude Haiku 5.5的三分之一,在成本敏感的高频Agent场景里做到了够用且便宜。不是所有活都需要最聪明的模型,也不是所有聪明都值得你付全价。
AI可以更聪明,但账单不该是唯一的代价。 选对模型、配对档位、看清任务类型,比追最新旗舰更省钱。