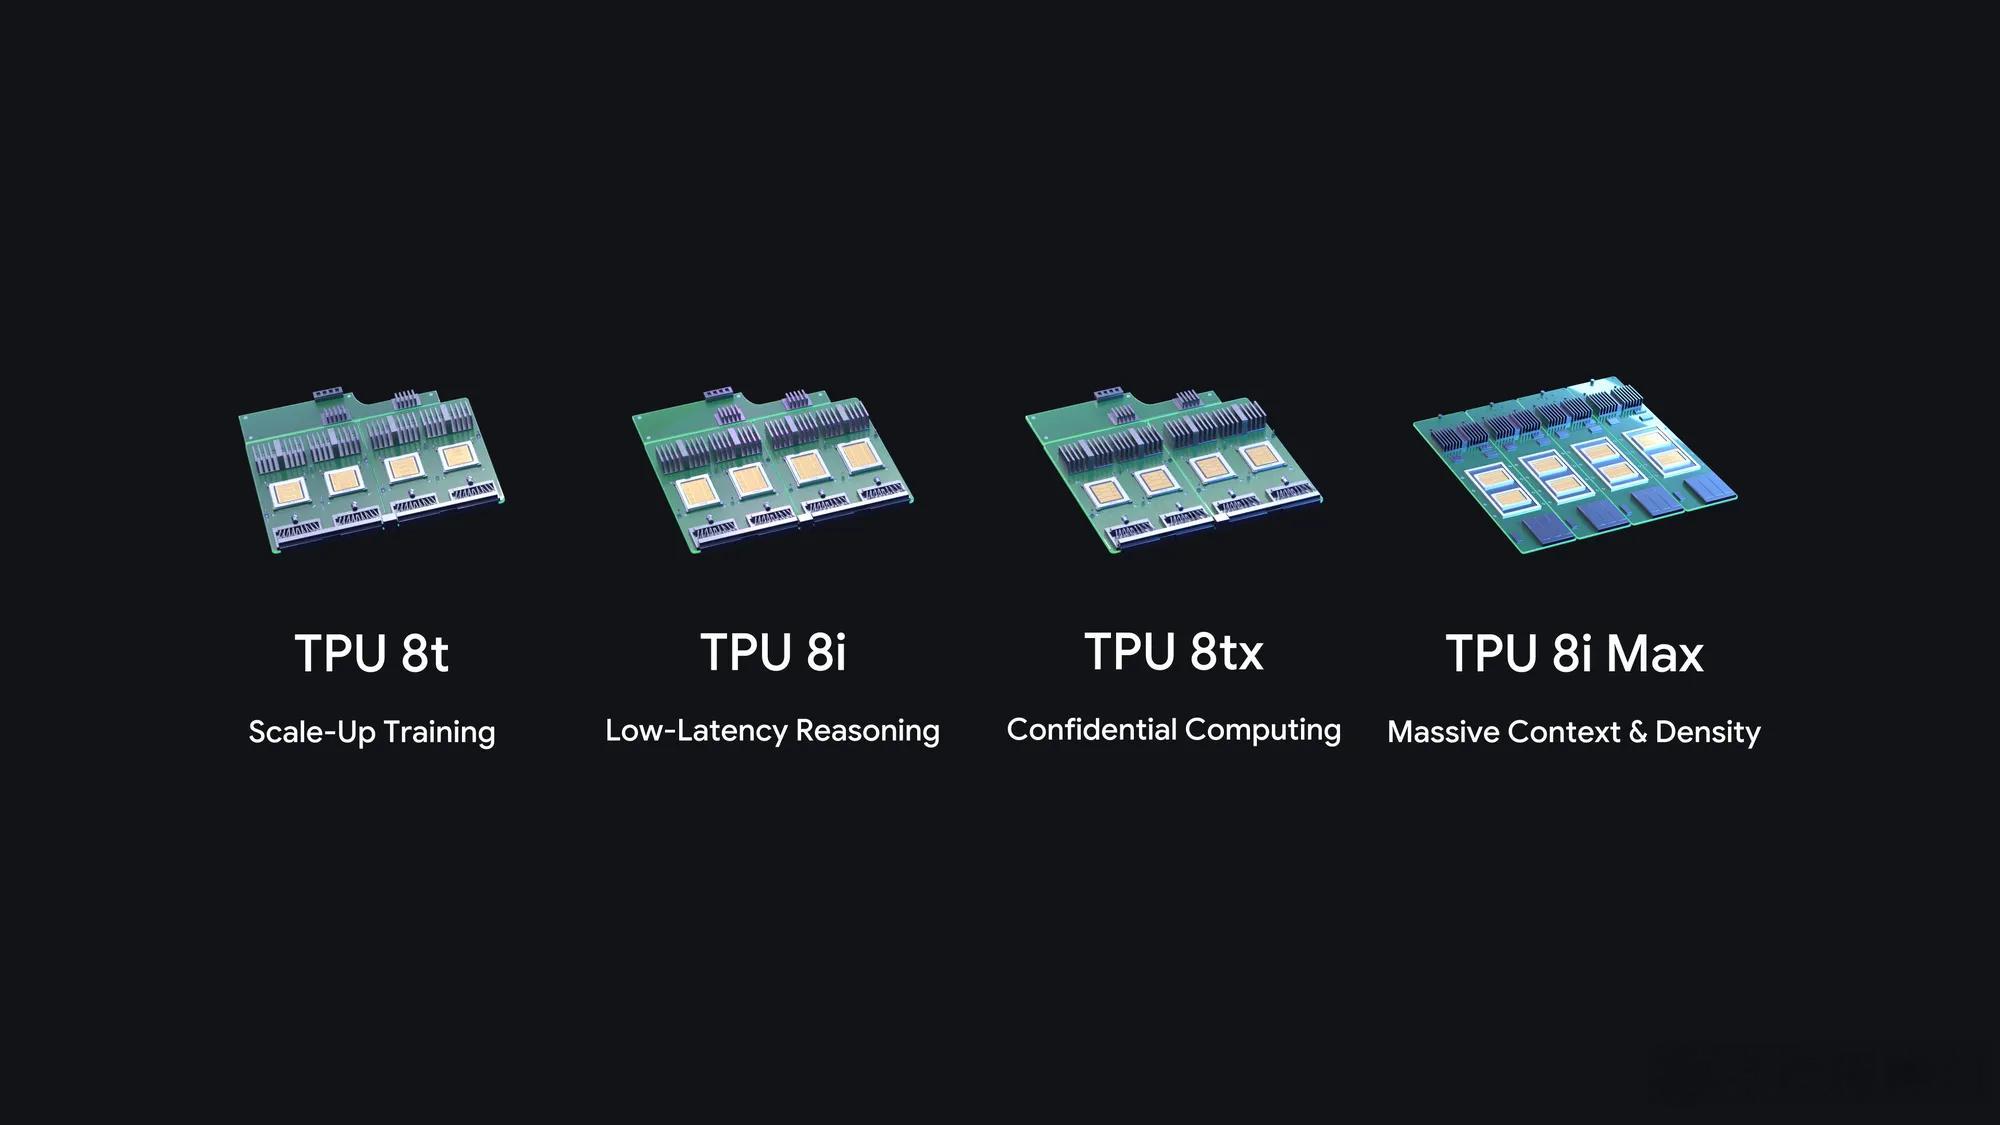
谷歌罕见的一年连发 4 款 TPU,最新推出了 8tx 和 8i Max。
决心要把底层基建全面重构为 Agent 原生架构,顺手还把 CUDA 的生态护城河拆掉了一大半。
现在的智能体跑的都是百万级上下文,显存带宽是最大的瓶颈,而调外部工具,等人类审批时,芯片又在空转。
这次谷歌把两颗芯片塞进同一封装 8i Max,算力和 HBM 显存带宽直接翻倍,软件上开源 TPU Sync 统一内存池,首字延迟下降了 90%,同时推出了新引擎,在智能体停顿等待时毫秒级挂起会话,释放算力。
大家都知道,芯片流片动辄两三年,根本追不上几个月一变的 AI 软件,Google 的策略是芯片不变,通过快速重组封装,光网络和内存,几个月就攒出一套新的。
新发布的 TPU 8tx 把训练芯片,低延迟推理网络和硬件加密揉进了一套系统,打破了数据进内存计算必须解密的惯例,延迟减半且几乎零性能损耗。
开源了 TorchTPU,让 PyTorch 代码,vLLM 和 SGLang 零代码修改直接原生运行,提供的 TPU 智能体插件,可以直接接入 Cursor 和 Claude Code,在几分钟内自动完成 TPU 上手配置,诊断瓶颈,并用自然语言自动调优自定义内核。
how i ai