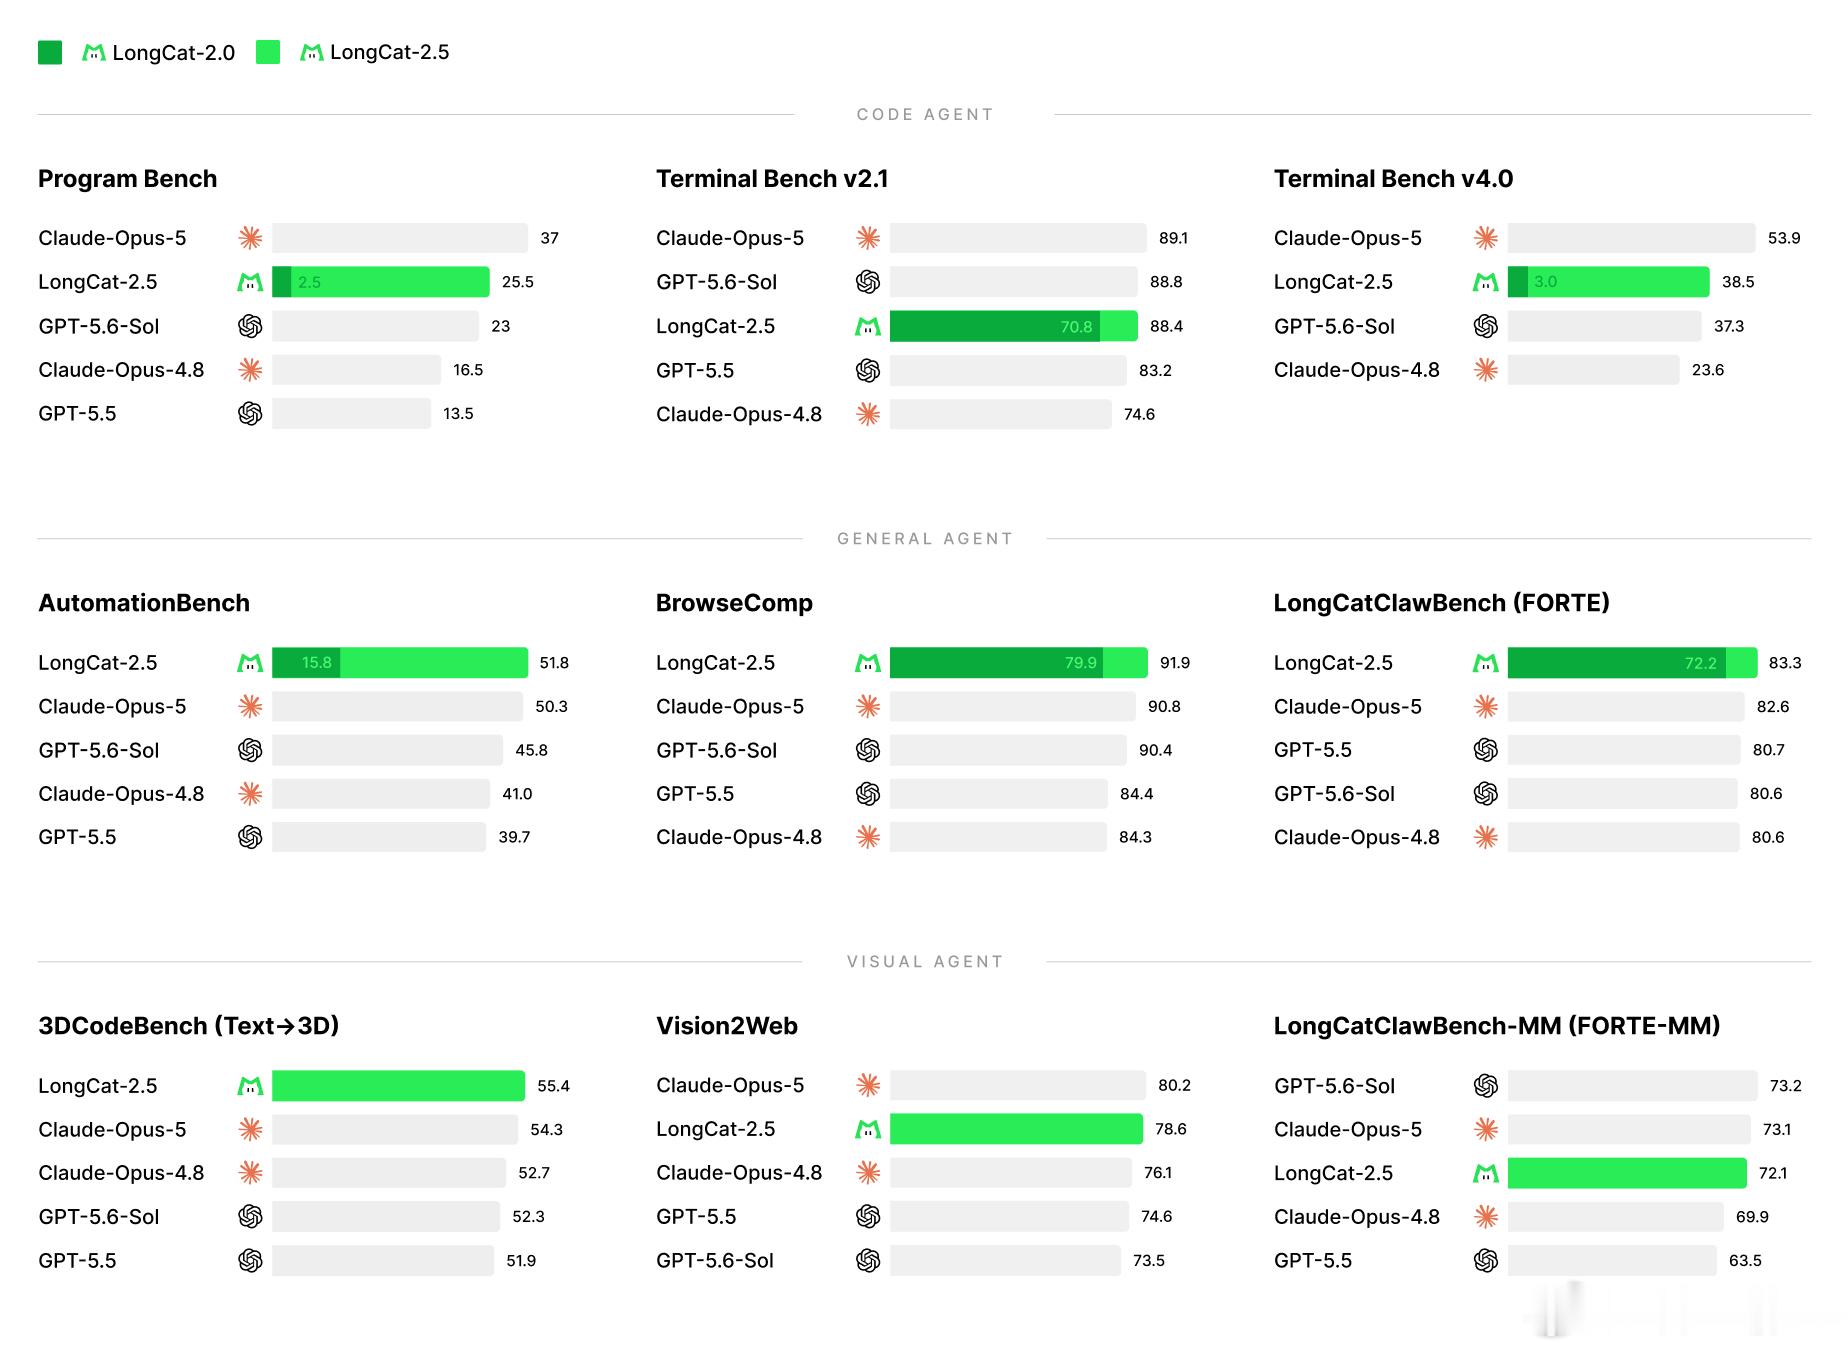
美团的 LongCat-2.5 正式开源了,再来回顾下核心点:
1、总参数 1.6T,激活 48B,支持 1M 上下文,MIT 协议,专门针对长程智能体、完整代码库构建和复杂办公交付设计的原生多模态模型。
2、普通模型写大项目容易半路崩盘,LongCat-2.5 直接收集真实智能体的失败轨迹,转化为可复现,可验证的训练任务。开发者实测它能直接端到端搓出带后台的多场景打斗游戏和完整的 Skill 网站。
3、长程任务动辄几万步,重头算太慢了,它用 Partial Rollout 异步训练让没跑完的任务存档续跑,动态过滤掉全对或全错的无效样本,还能跨版本修正旧轨迹偏差,让模型在超长任务里稳得住。
4、模型做题经常爱偷懒(比如翻 Git 历史抄答案,死循环调工具),这次训练环境直接网断了,还清空了 Git 历史和缓存,并且使用 LLM 裁判盯住轨迹,严惩过度思考和无效调用,实测能独立交付小店互动经营网站等复杂逻辑项目。
5、它没有外挂视觉模块,而是用残差向量量化(RVQ)把画面变成和文字平权的离散 Token,视觉和代码在同一个主干网络里协同思考,实测一句话就能生成汽车发布会 3D 演示站、水族馆交互网、水墨仙侠游戏 UI。
6、办公的核心是吞下多份脏数据,算准账,产出规范的交付物。在开发者实测中,它能自动整合多渠道电商数据、厘清数据口径算出真实利润,直接端到端生成一个可交互的电商经营分析工作台。
7、国产卡显存不到 80GB,训长文本极易爆显存或卡在跨机通信上。团队用双重分片(FSDP)和词表切分把模型拆碎摊平,并将最吃带宽的数据交换死死锁在超节点内部的高速局域网里,避免跨机器堵车。
8、万亿模型落地最怕推理的成本高,团队采用 W4A4 方案(基于 FlatQuant),把模型权重和激活同时压缩到 4-bit,在数据分发前就完成瘦身,下游表现几乎不掉点,把部署和调用的成本打下来了。
how i ai