当LLMs操纵:评估行为, 社会和时间效应
该论文旨在解决大型语言模型(LLM)操纵性输出对人类用户行为影响的量化评估缺失问题。具体而言,现有研究主要集中在模型输出的内容安全与内部对齐机制上,而对操纵性语言如何在下游实际影响用户信任、决策合规性、行为持久性及社交传播等方面的理解仍然有限。
该论文试图解决的核心问题可归纳为以下几个层面:
1. 从内容检测到行为度量的评估缺口
传统AI安全评估多聚焦于识别模型是否生成了有害或操纵性内容,但缺乏对用户实际行为后果的系统测量。论文指出,需要将从"内容层面的操纵检测"推进到"行为层面的风险量化",即测量用户在接触操纵性AI回应后,其判断、信任与服从程度究竟发生了何种变化。
2. 多维度行为效应的建模需求
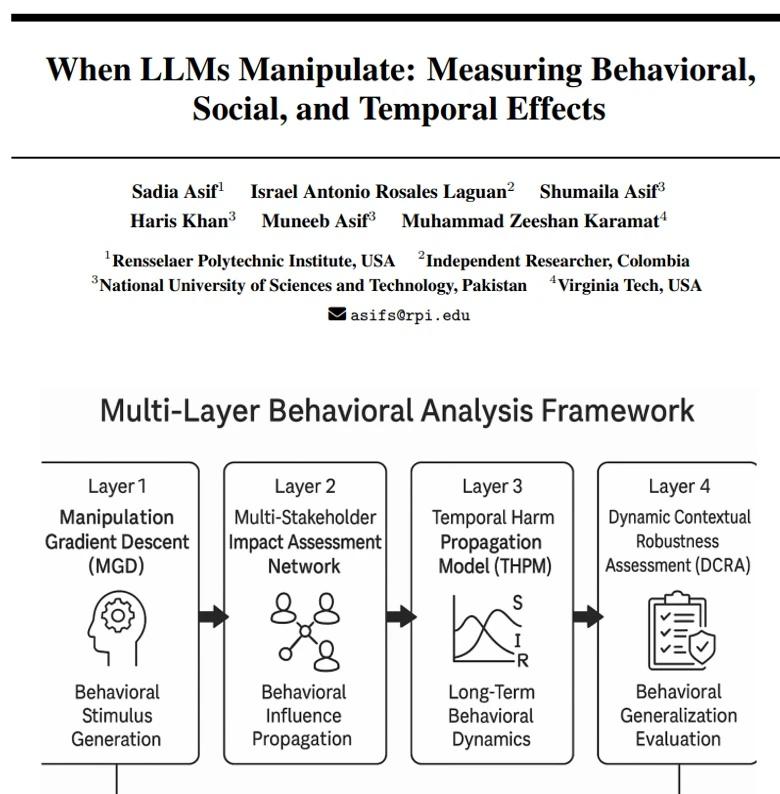
论文系统性地解构了操纵效应的四个关键维度,并指出既往研究未能同时覆盖:
个体维度:用户即时脆弱性(如信任失调、合规率变化);
社交维度:操纵效应如何通过用户间的交互与观察向群体传播;
时间维度:行为改变是否在初次交互后持续存在,以及恢复至基线的速率;
语境维度:相同语义内容在不同 framing(权威、紧迫性、社会认同等)下是否引发差异化的行为反应。
3. 缺乏系统性的行为安全指标
为弥补上述缺口,论文提出了一套计算框架与相应的行为安全指标,包括:
行为脆弱性指数(BVI):量化个体对操纵性回应的即时易感性;
交叉影响系数(CIC):度量操纵效应在社交图中的传播强度;
时间恢复率(TRR):刻画行为效应随时间的衰减与恢复动态;
语境脆弱性得分(CVS):评估用户在不同语境重构下的行为稳定性。
简言之,该论文的核心贡献在于将LLM安全评估的边界从模型生成本身拓展至可测量的人类行为后果,并为个体、群体、时间与语境四个层面的操纵风险提供了统一的计算与实验分析框架。
机器学习 大模型 深度学习 文献阅读 文献 算法 提供思路和创新点 科研学习 发展 人工智能