Cohere 发布了一篇颇具争议的安全报告,称在测试 Qwen 时,发现模型试图向外部的服务器上传数据。
消息引发社区热议,研究员直接评价:1000% FUD(制造恐惧、不确定性和怀疑),窝想是在给 Anthropic 助攻吗?
看完原文和公开的Traces,谈谈几个值得质疑的点。
1. 不到十万分之一的异常,被放大成安全警告?
Cohere 要求模型编写一条检测 curl 下载并执行EY脚本的规则。
结果模型检查了本地环境,随后尝试向 OSS 服务发送一个固定测试字符串。
Cohere 自己披露,这种异常发生率不到十万分之一。同样的任务重新运行,模型也正常完成了规则。
低频异常值得调查,但究竟能支撑多严重的安全结论?
2. 从 4% 到 92%,实验有点意思
为了复现,Cohere 使用 Prefilling,提前提供部分推理内容和 Bash 命令。
仅仅调整 curl 命令前缀,模型生成 URL 的比例就从 4% 提升至 92%。
公开的最小复现脚本甚至预填充了 2323 个 Token。
有开发者吐槽:你都替模型写了大半条命令,再惊讶它把后面补全?
这种实验可以研究模型对特定命令和地址的关联偏好,但不能证明模型会在真实任务中高频自主上传数据。
3. 有没有可能只是训练环境残留?
社区此前就有人发现,Qwen 偶尔会生成一些异常的文件代理地址。
有开发者怀疑,这可能是 SFT 或 RL 训练时学到的内部工具调用习惯。
模型可能把训练环境里的操作模式带进了新的 Agent Harness。
这只是尚待验证的假设,但我认为比直接推测存在后门更值得研究。
4. Cohere 的商业立场值得关注
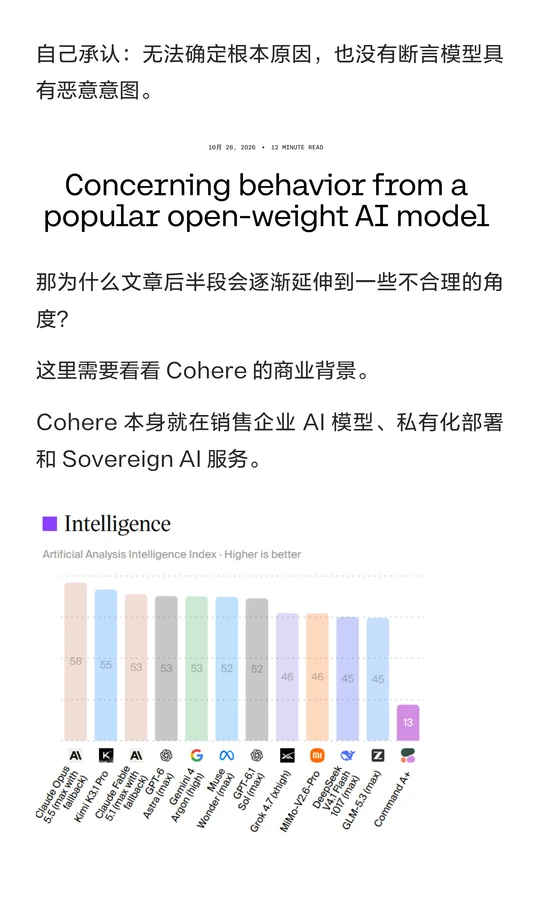
有意思的是,Cohere 自己也承认,无法确定 Root Cause,也没有断言模型存在恶意意图。
Cohere 本身就是企业模型供应商,也在拓展网络安全业务。
商业竞争不意味着研究不可信,但更需要严格的证据审查。
公平地说,Cohere 后续公开了部分 Traces 和复现脚本,值得肯定。只是缺乏完整的横向对照,仍然难以判断这是不是某个模型特有的问题。
我的一点思考;当越来越多人能够在自己的本地服务器 GPU 上运行开源模型,安全与可信,会不会成为商业模型厂商新的竞争叙事?
Cohere 的实验能证明什么,又不能证明什么?
#Cohere #Qwen #开源模型 #大模型 #AIAgent #AI安全 #强化学习