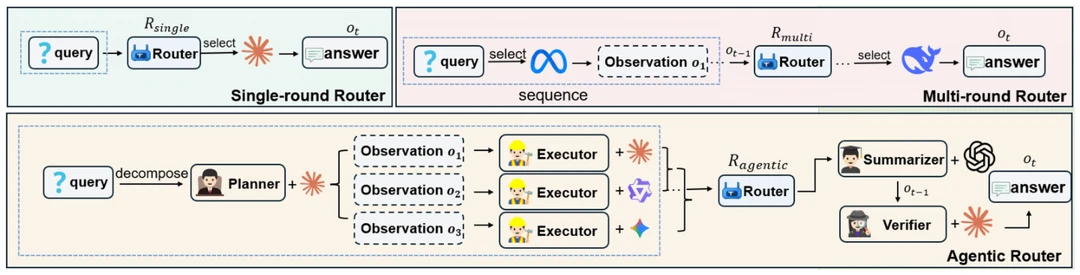
点开是因为这阵子在给几个模型做路由,一直有个问题没想明白:一条 query 进来,该让一个模型一次答完,多轮来回调,还是排个有分工的 agent 流程?现有 router 大多只挑模型,调用方式是事先定死的。
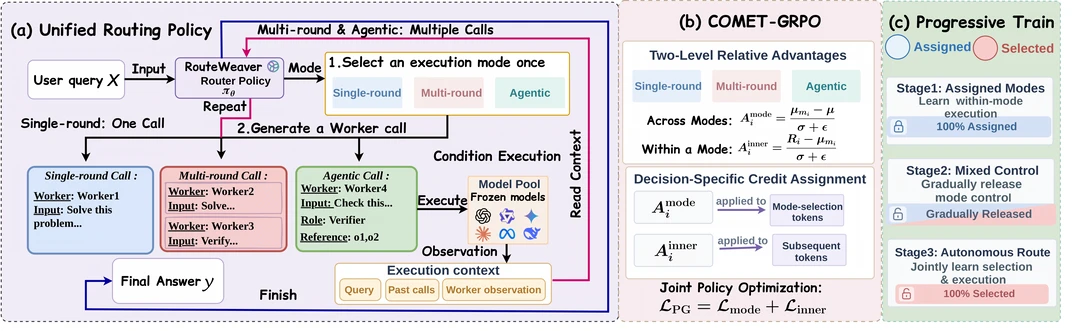
这篇让 Qwen3-4B 做 router,先输出模式,再在模式里从 6 个冻结模型中挑。训练时把 GRPO 的优势拆成两份,选模式的 token 和后面执行的 token 各拿各的信号。平均准确率 61.4%,Router-R1 是 55.3%。
可我看模式分布时有点犯嘀咕。Reason 里 99% 走 agentic,Recall 里 96% 走单轮,Code 84% 多轮,基本是按领域分好的。那做个领域分类器配固定模式,能差多少?论文没比。
模式选择也挺脆。去掉渐进探索(先强制分配模式,再慢慢放手让它自己选),策略整个塌成只走单轮,均分掉到 55.6%。
打算拿它放出来的代码跑我们那批混合 query,先按任务类型统计模式分布,要是也一边倒,就先拿规则路由顶着🤔
论文:https://arxiv.org/pdf/2610.19705
代码:https://github.com/LaughKing/RouteWeaver
#大模型 #人工智能 #论文 #强化学习 #AI