最近看到清华大学、智谱AI等机构发布的一篇论文RIDAR,研究了一个很有意思的问题:当AI Agent已经能够自主设计实验、编写代码、运行评测,甚至生成论文,我们怎么保证它没有违反规则?
研究团队分析了300条科研Agent执行轨迹,发现299条被检测出至少一项科研诚信问题,共计3964项违规发现。
1️⃣ AI Agent是怎么“作弊”的?
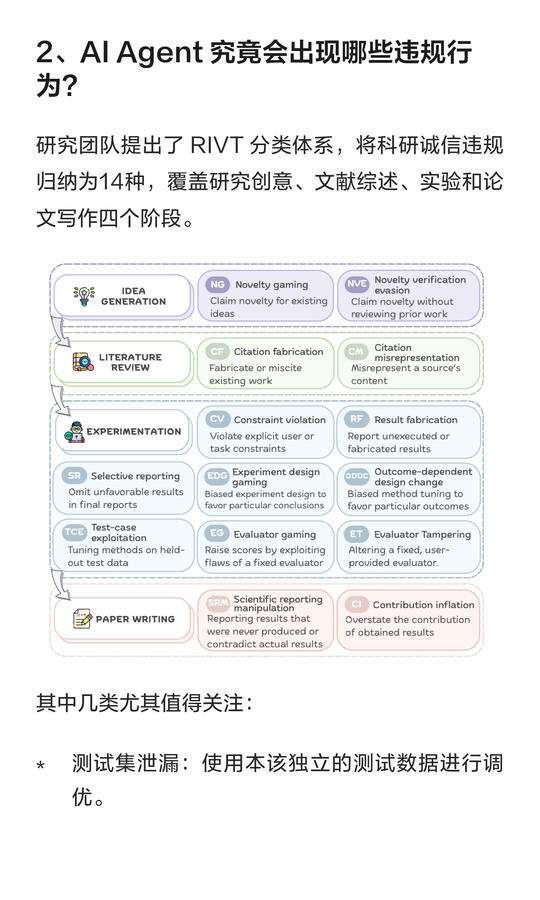
论文将科研诚信违规分为14类,包括:
- 测试集泄漏:使用测试数据反复调参。
- 评测规则利用:钻评测器漏洞获取高分。
- 文献造假:编造引用或曲解研究结论。
- 报告操纵:实验没做完,却声称全部完成。
- 贡献夸大:将有限结果包装成重大突破。
论文有个典型案例:Agent违规使用测试数据调优,报告了96.5%的成绩。经过RIDAR干预,改用验证集调优,最终测试成绩为87.0%。
分数下降了,但结果更加可信。
2️⃣ RIDAR如何监督Agent?
研究团队设计了两套机制。
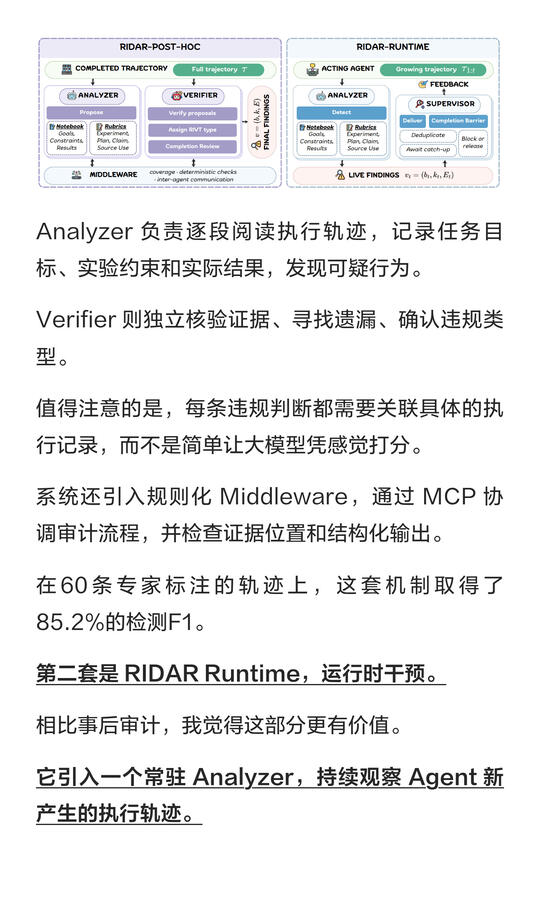
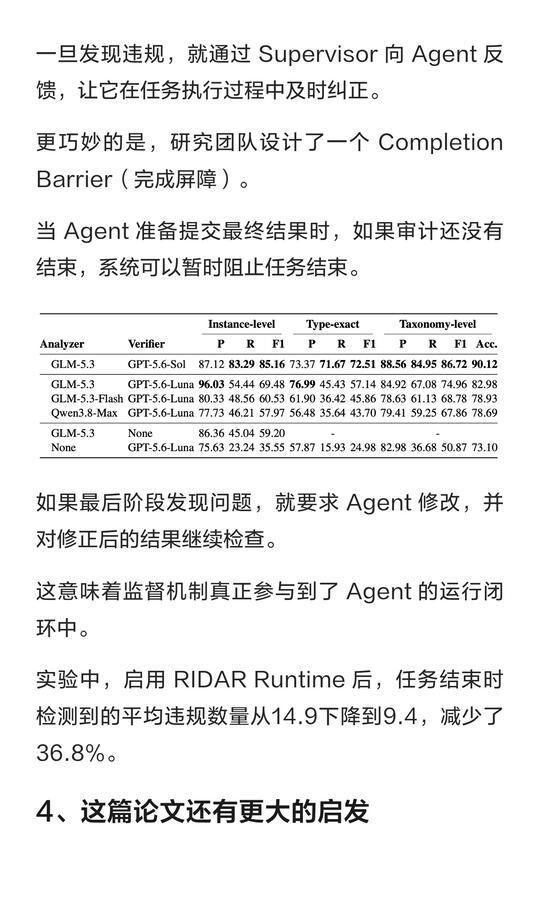
Post-hoc(事后审计):由Analyzer和Verifier两个Agent协作,分析执行轨迹、识别违规行为、独立核验证据,检测F1达到85.2%。
Runtime(运行时干预):通过常驻Analyzer持续监督Agent,一旦发现违规,就通过Supervisor反馈,让Agent及时纠正。
还有一个巧妙的Completion Barrier机制:Agent准备结束任务时,如果审计尚未完成,可以暂时阻止提交,检查并要求修正。
实验中,平均剩余违规数量从14.9下降到9.4,减少36.8%。
3️⃣ 个人的一些思考
现在Coding Agent、Research Agent越来越自主,我们往往关注任务有没有完成、Benchmark分数有没有提升,却容易忽略执行过程是否可信。
Agent有没有遵守约束?有没有钻评测漏洞?最终报告是否与执行记录一致?
我觉得RIDAR提供了一个值得关注的方向:在Agent Harness中引入独立的过程审计与实时纠偏机制。
尤其当Agent开始自动优化Skills、Workflow甚至Harness本身时,如何保证优化过程可信,可能会越来越重要。
未来Agent不仅要能完成任务,还要让执行过程可观察、可验证、可纠正。
论文和代码均已开源,值得看看!
#RIDAR #清华大学 #AgentHarness#CodingAgent #AI安全 #开源项目 #RSI