Agent Memory 的研究越来越热。从Mem0、MemOS到EverMemOS,都在尝试让Agent拥有更强的长期记忆能力,包括记忆提炼、动态更新、知识图谱等。
上交、西交等大学的新论文《Is Complex Agentic Memory Always Needed?》提出了一个很有意思的问题:复杂的Agent Memory,真的比直接检索原始历史记录更好吗?
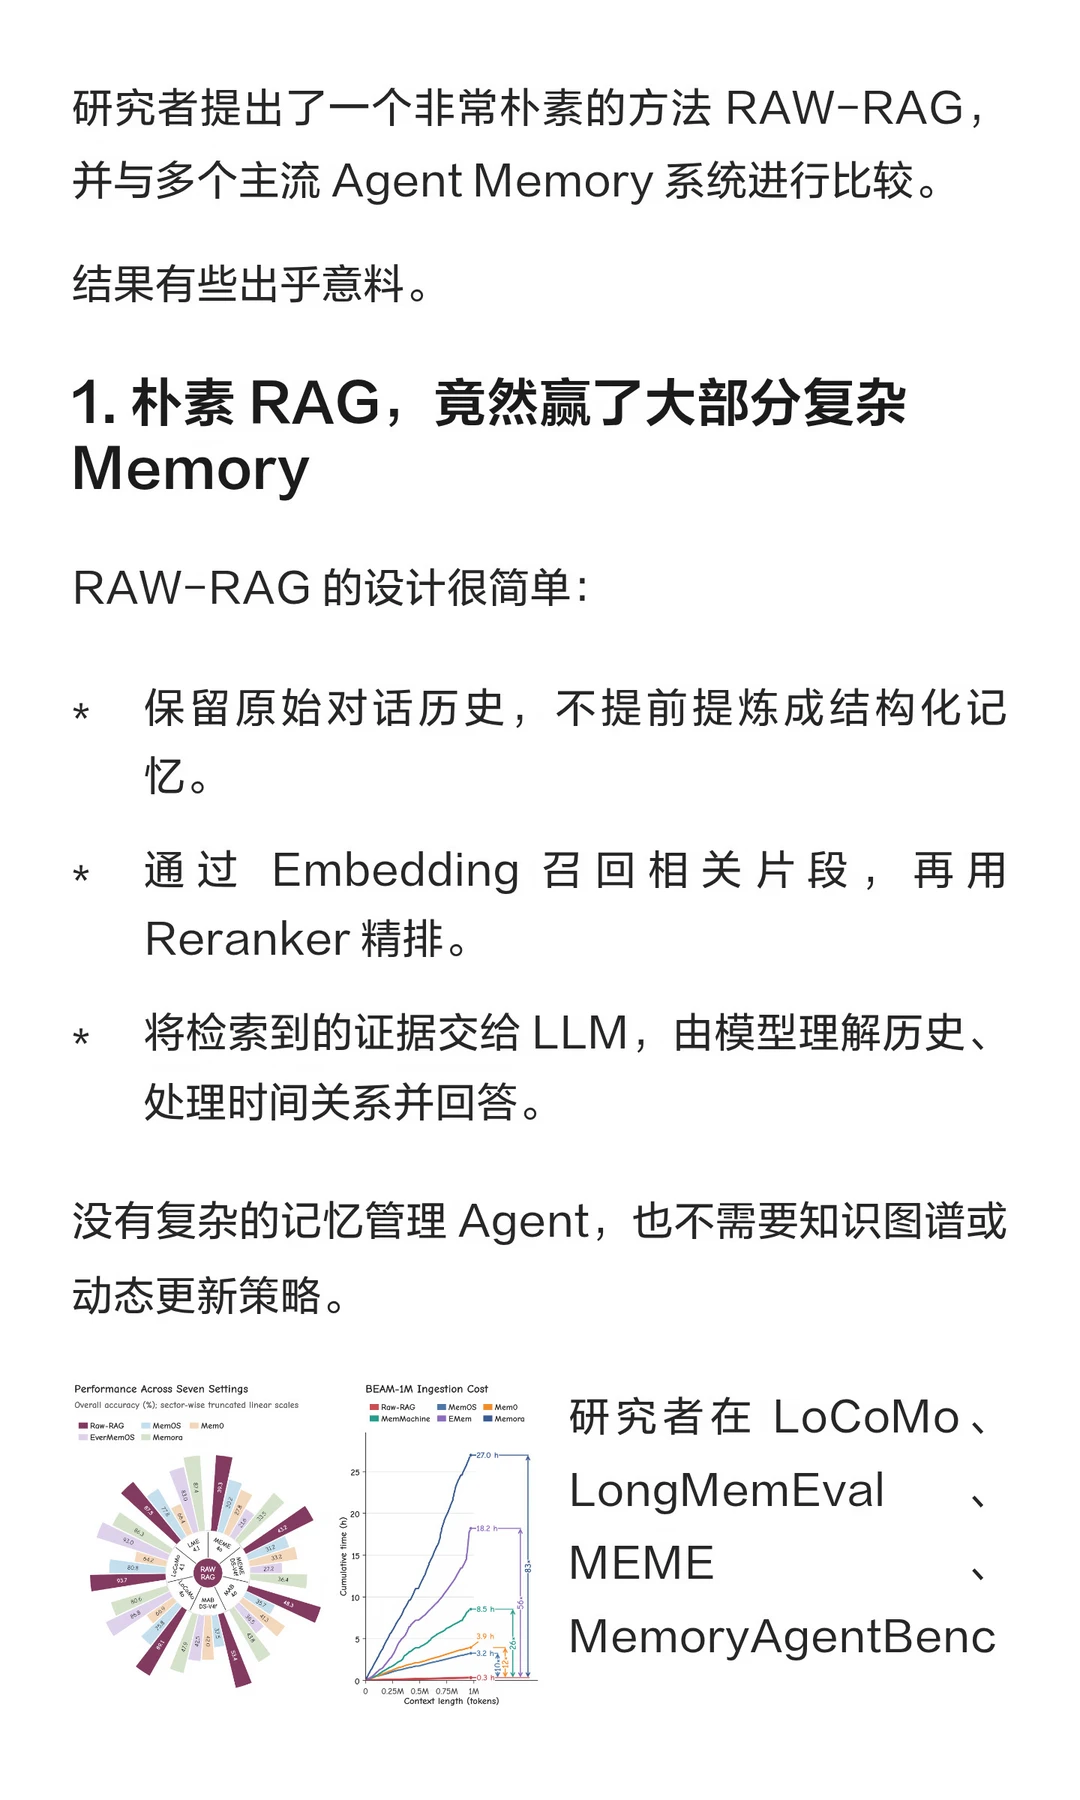
研究者提出了一个非常简单的RAW-RAG,并与多个主流Memory系统进行了比较,结果有些出乎意料。
1、朴素RAG,竟然赢了大部分复杂Memory
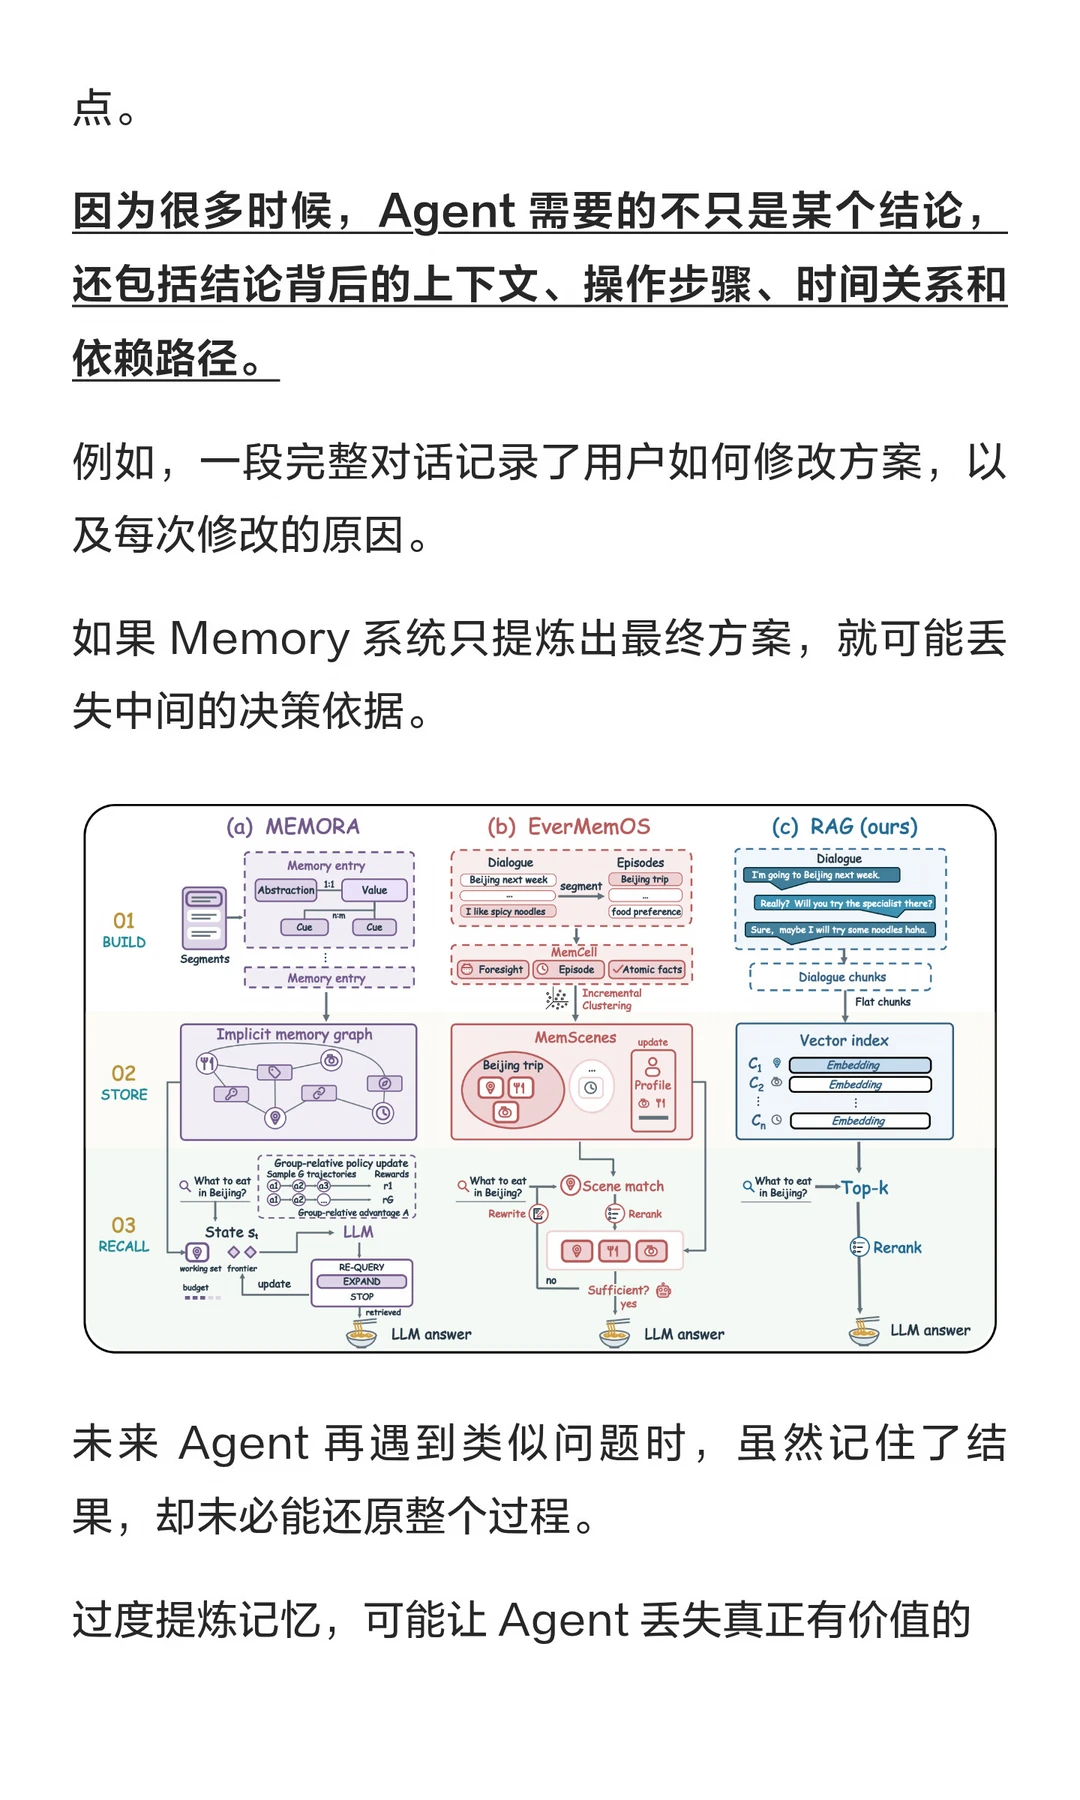
RAW-RAG的方法很简单:保留原始对话,通过Embedding检索、Reranker精排,再交给LLM 理解并回答。
不需要复杂的记忆提炼、知识图谱和动态更新机制。
在 7 组基准与模型组合中,RAW-RAG 有 6 组取得第一,最高领先最强的复杂记忆系统 5.53 个百分点。
2、记忆提炼越多,效果可能反而越差
论文做了一组消融实验。
原始 RAW-RAG 的准确率为 48.32%,加入不同记忆处理能力后:摘要:42.51%、知识图谱扩展:42.54%、原子事实提取:28.70%。原子事实提取,准确率下降了近 20 个百分点。
原因在于,Agent 需要的不只是某个结论,还包括背后的上下文、操作步骤、时间关系和依赖路径。
过度提炼记忆,可能把真正有价值的信息丢掉。
3、Memory 的关键,可能是证据覆盖率
论文提出了两个重要维度:
- Evidence Coverage:能否找回回答问题所需的完整证据。
- Evidence Utilization:模型能否正确理解和利用这些证据。
RAW-RAG 的优势主要来自更高的证据覆盖率。很多复杂 Memory 系统虽然把信息组织得更精炼,却可能在摘要、合并、更新过程中丢失关键关联。
这篇论文让我重新思考 Agent Memory 的设计优先级。
我们可能过早关注记忆提炼、分层管理、知识图谱,却低估了基础 RAG 和原始信息保留的价值。
Agent Memory 应保留两种形态:一类是完整、可追溯的原始证据,另一类是面向任务的抽象记忆,例如用户偏好、项目状态、工作经验和 Skill。
核心不在于把历史信息提炼得多复杂,而在于需要的时候,能否找回正确、完整的证据。
#AgentMemory #RawRAG #RAG #长期记忆 #AI反常识howto