给 agent 加长期记忆,我一直默认得上 Mem0 这类:抽事实,能改能删。
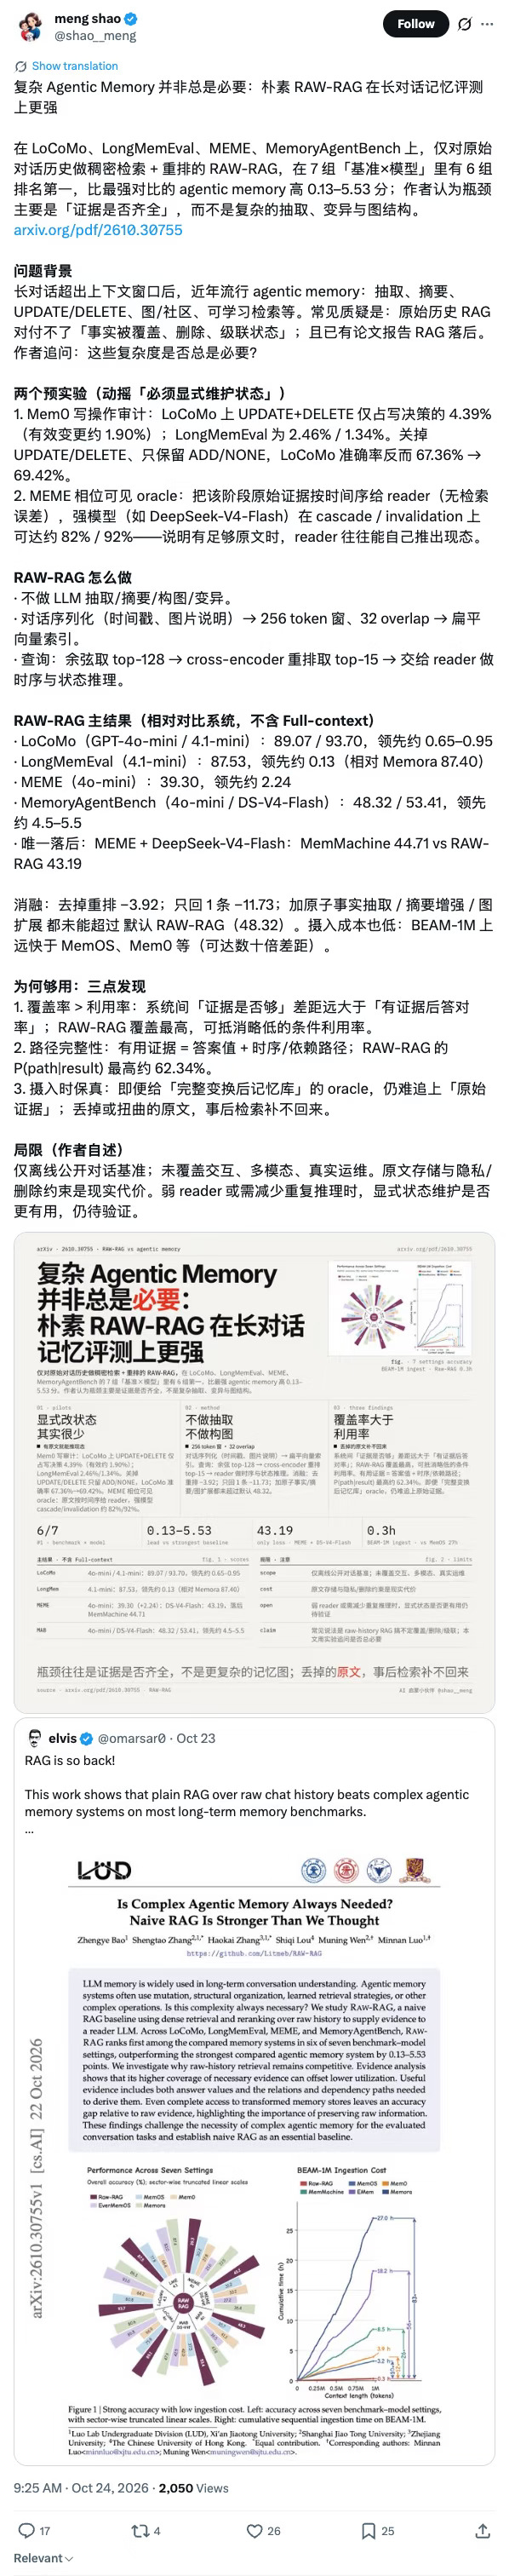
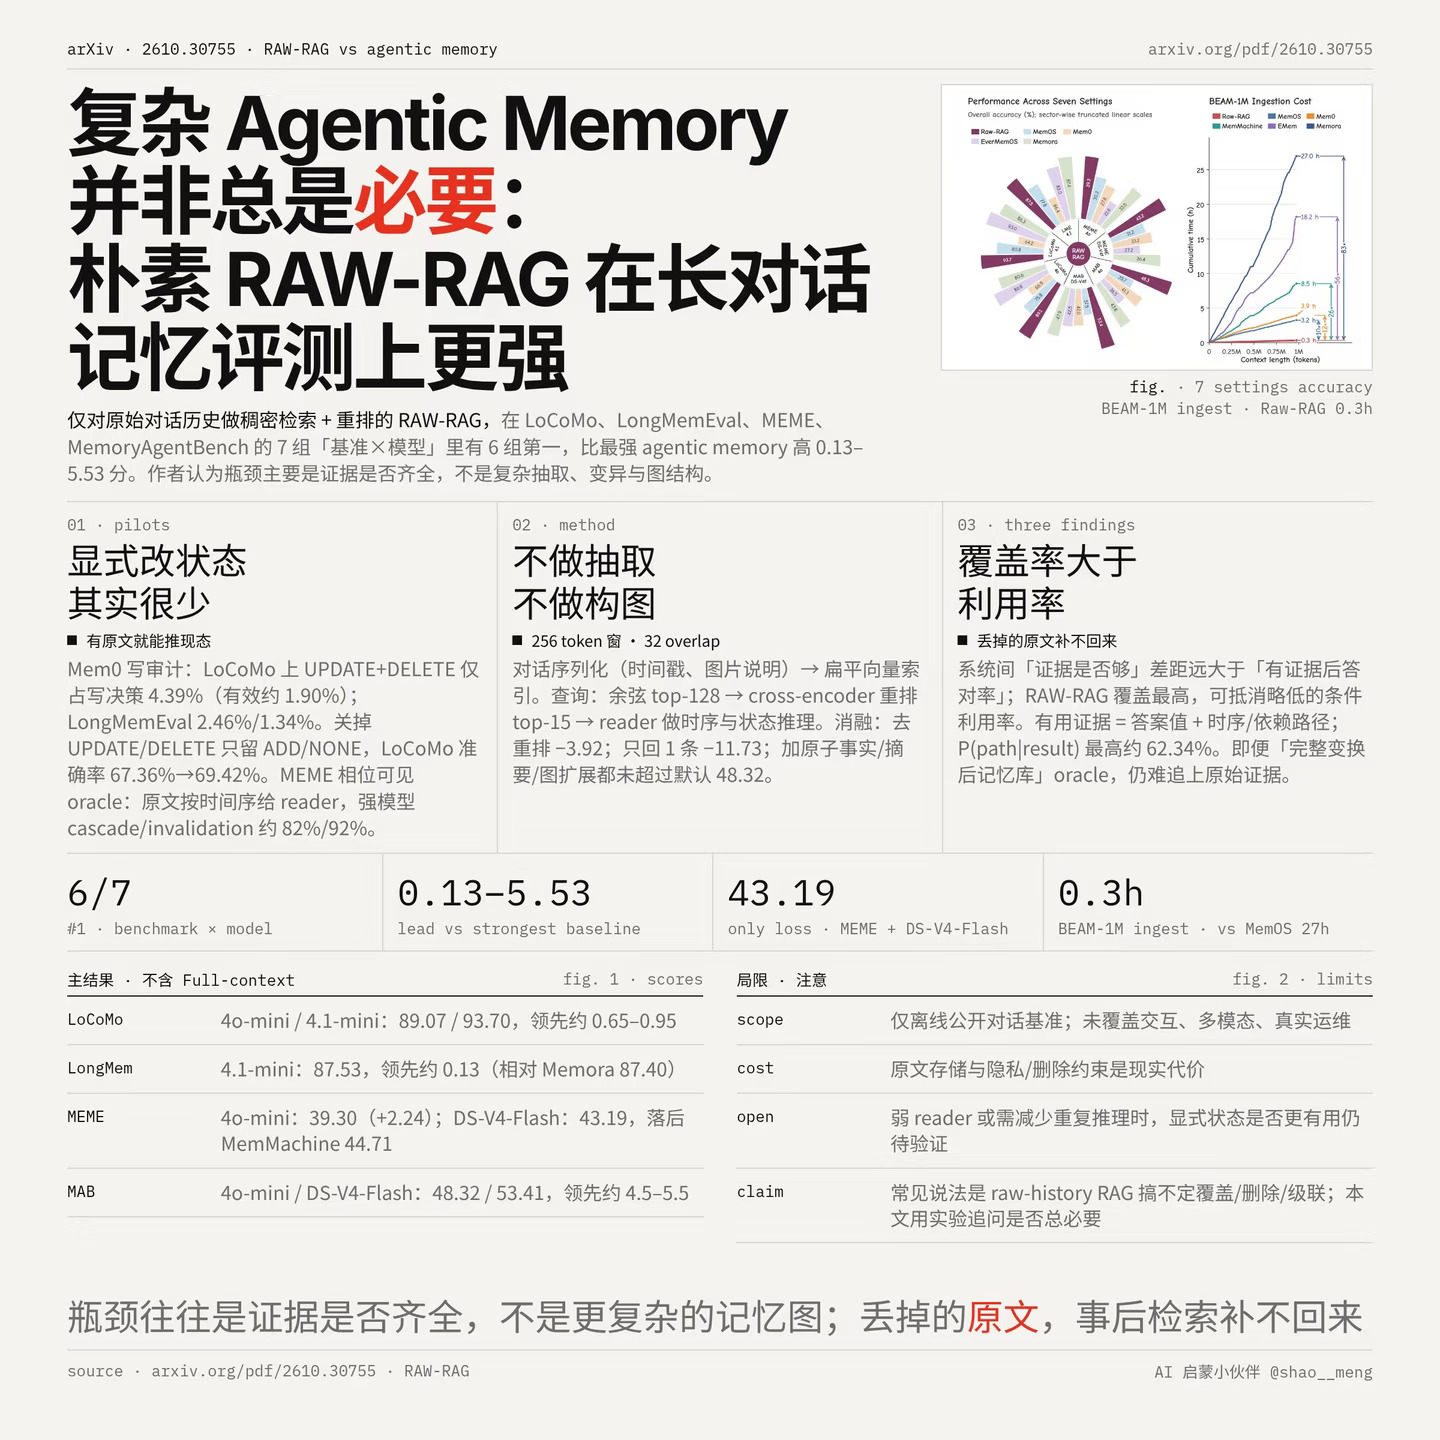
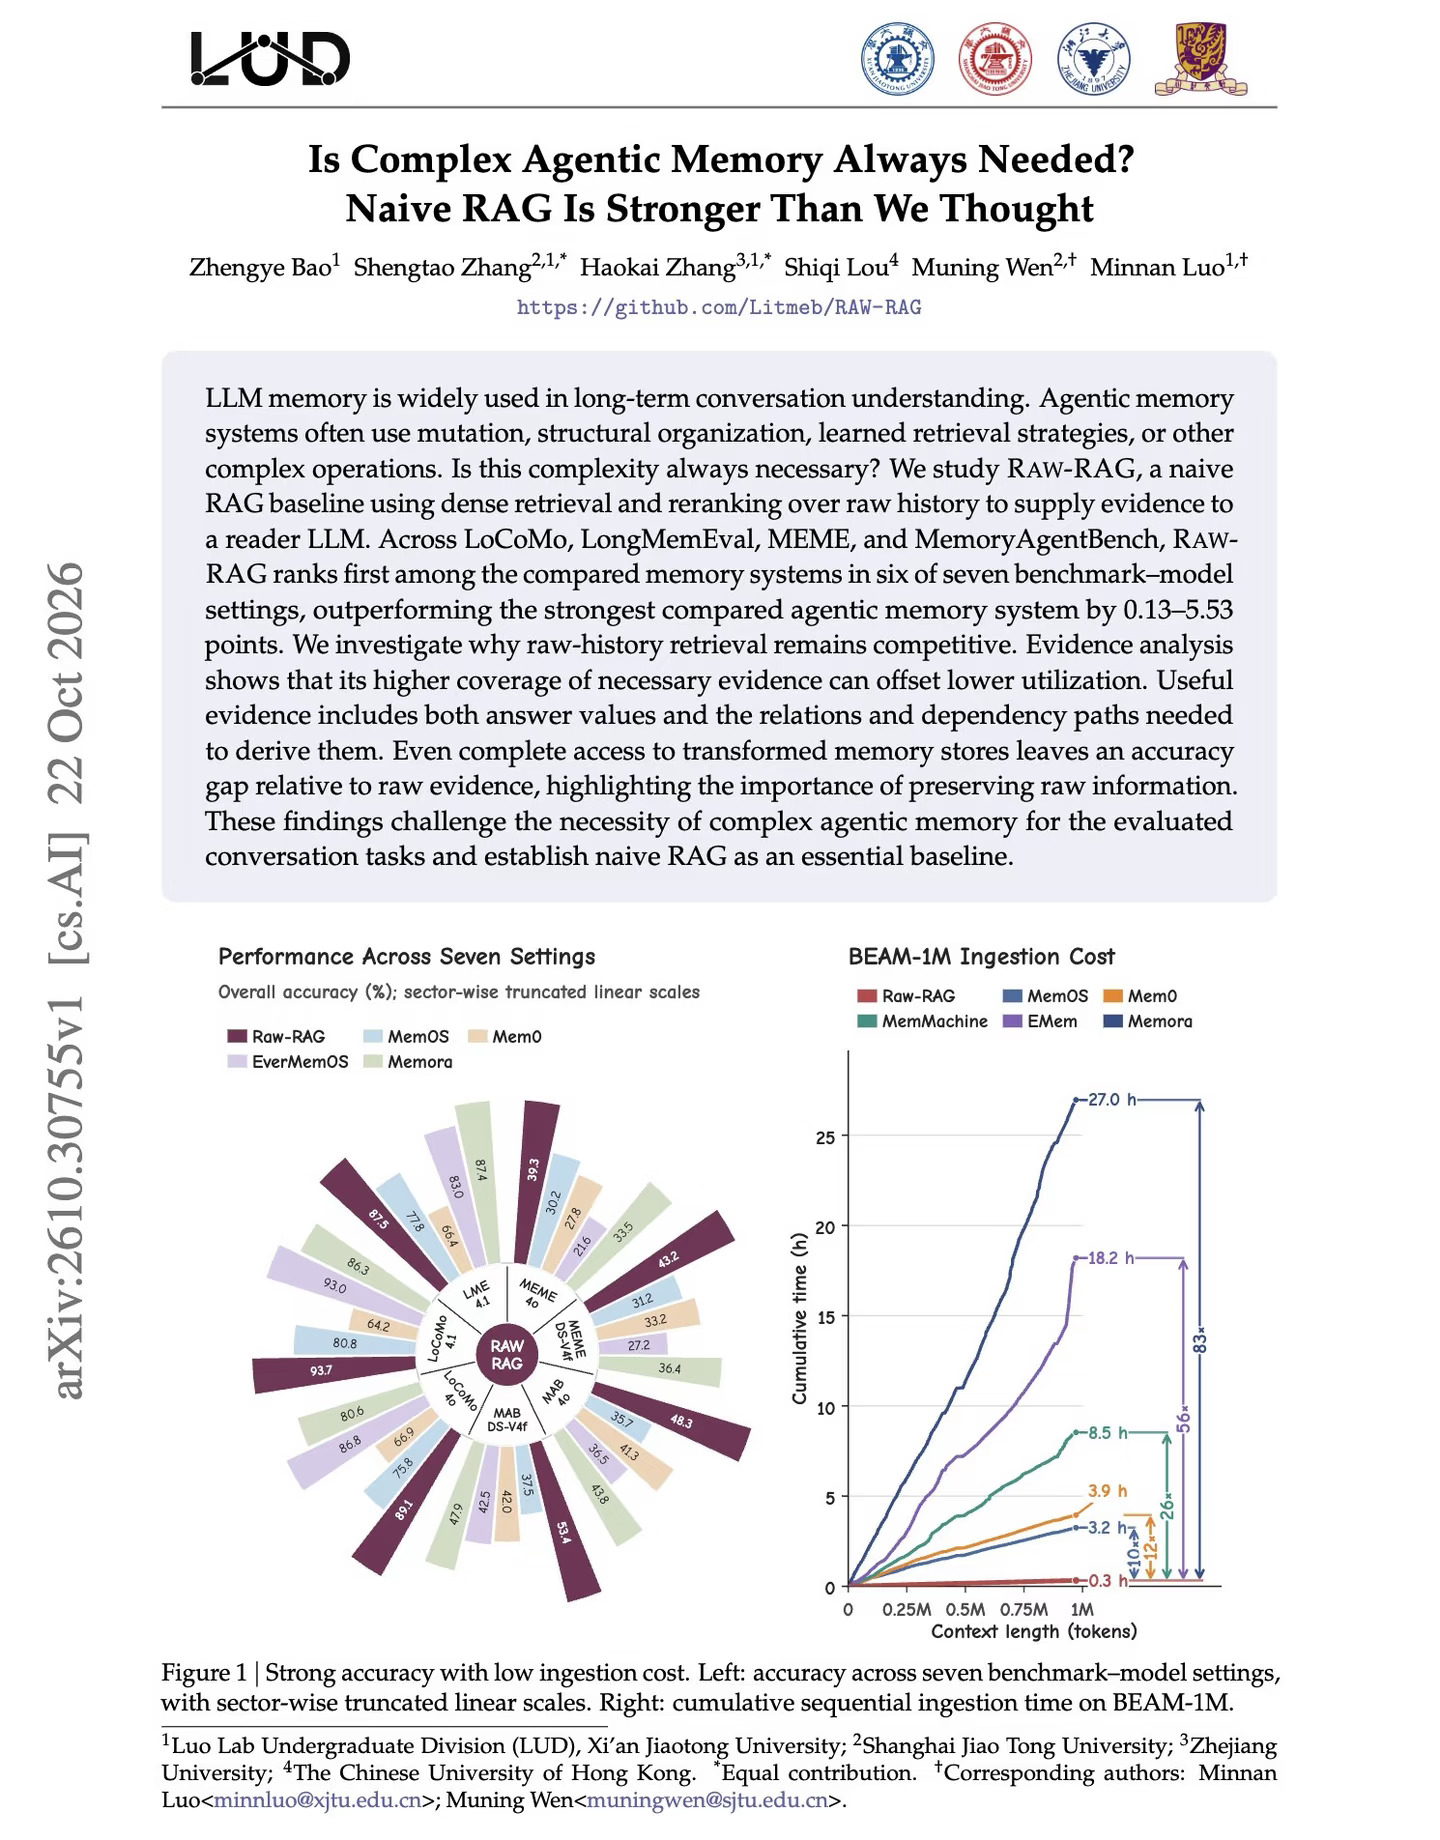
这篇论文拿最笨的办法去比。原始对话切成 256 token 的块,向量检索加 cross-encoder 重排,留 15 块直接给模型读。4 个长对话记忆基准、7 组设置,它 6 组第一,比排第二的对手高 0.13 到 5.53 分。
Mem0 那组统计挺扎心的:LoCoMo 上 UPDATE 和 DELETE 只占写决策的 4.39%,关掉它们,准确率反而从 67.36% 到了 69.42%。
建库也快,BEAM-1M 上 0.3 小时,慢的系统要 27 小时。
不过都是离线的公开对话集,读答案的模型也是 4o-mini、4.1-mini 这些。我这边用户偏好改得勤,新旧说法一起被检出来,模型分得清哪句算数吗?
#大模型 #RAG #人工智能 #AI