月之暗面发布 Kimi K3.1 Pro,2.8T 总参数、104B 激活参数,支持100万 Token 上下文,也同步发布的 Kimi K3.1 Pro 技术报告。推荐大家读一读。
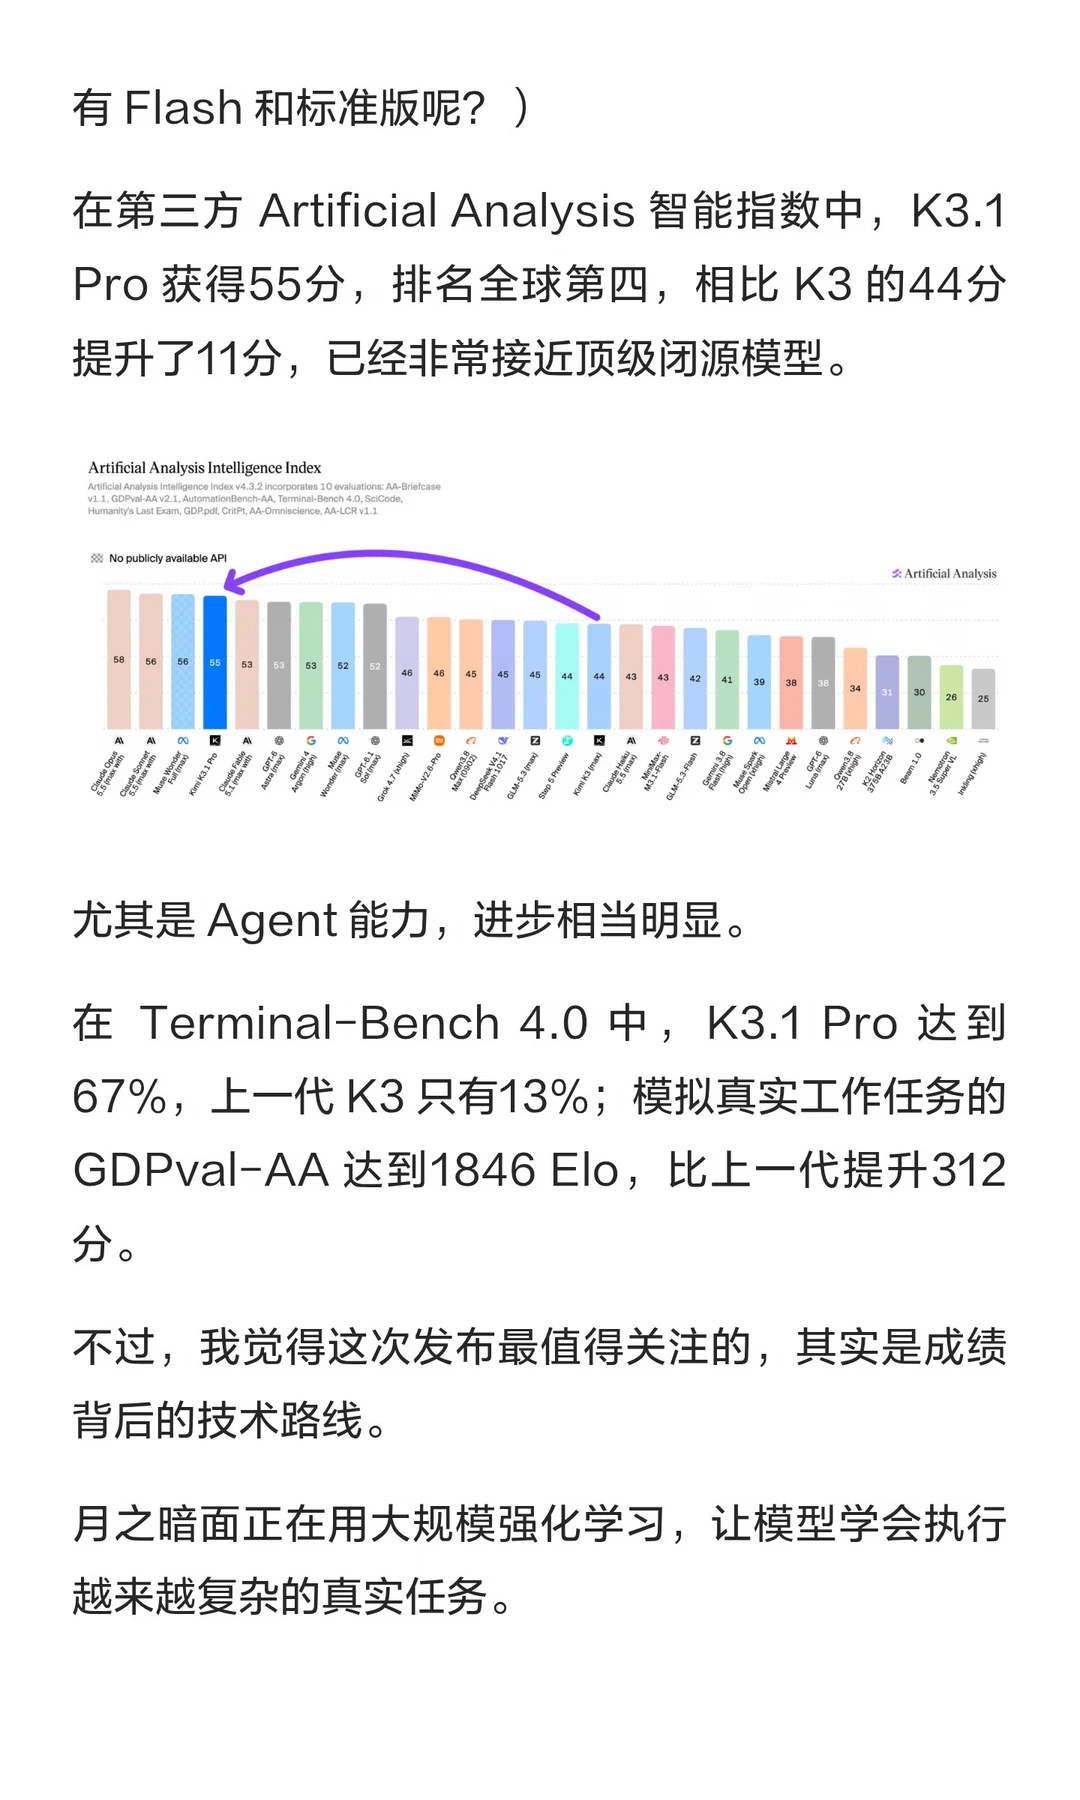
Artificial Analysis 榜上,K3.1 Pro 获得55分,比 K3 提升11分。尤其是 Agentic Coding,Terminal-Bench 4.0 成绩从13%提升到67%。
但我觉得,这次最值得关注的是背后的技术路线。
1、基础架构没换,RL Scaling 带来巨大提升
K3.1 Pro 延续 K3 的 MoE 架构,主要通过扩大后训练规模,在数百个领域开展联合强化学习(Joint RL)。
这也说明,在足够强大的基础模型之上,Post-training 仍然有很大的提升空间。
尤其是 Coding、3D、金融等复杂任务,模型需要持续执行、获得反馈、修正错误,这些场景非常适合通过可验证的反馈进行强化学习。
2、Agent RL 开始拼训练基础设施
这次报告专门强调了 Sandbox、Rollout Scheduling、Long-context Inference 和 Environment Quality Checks。
Agent RL 需要让模型在真实或模拟环境中执行任务,通过工具运行结果获得反馈。
而不同任务的执行时间差异巨大,训练系统既要高效调度大量轨迹,又要保证执行环境和奖励信号的可靠性。
未来 RL Scaling 的竞争,除了算力,还取决于训练环境质量、轨迹采样效率和 Reward 的可靠性。
3、从写代码,到完成复杂工程任务
报告展示了一个有意思的案例。
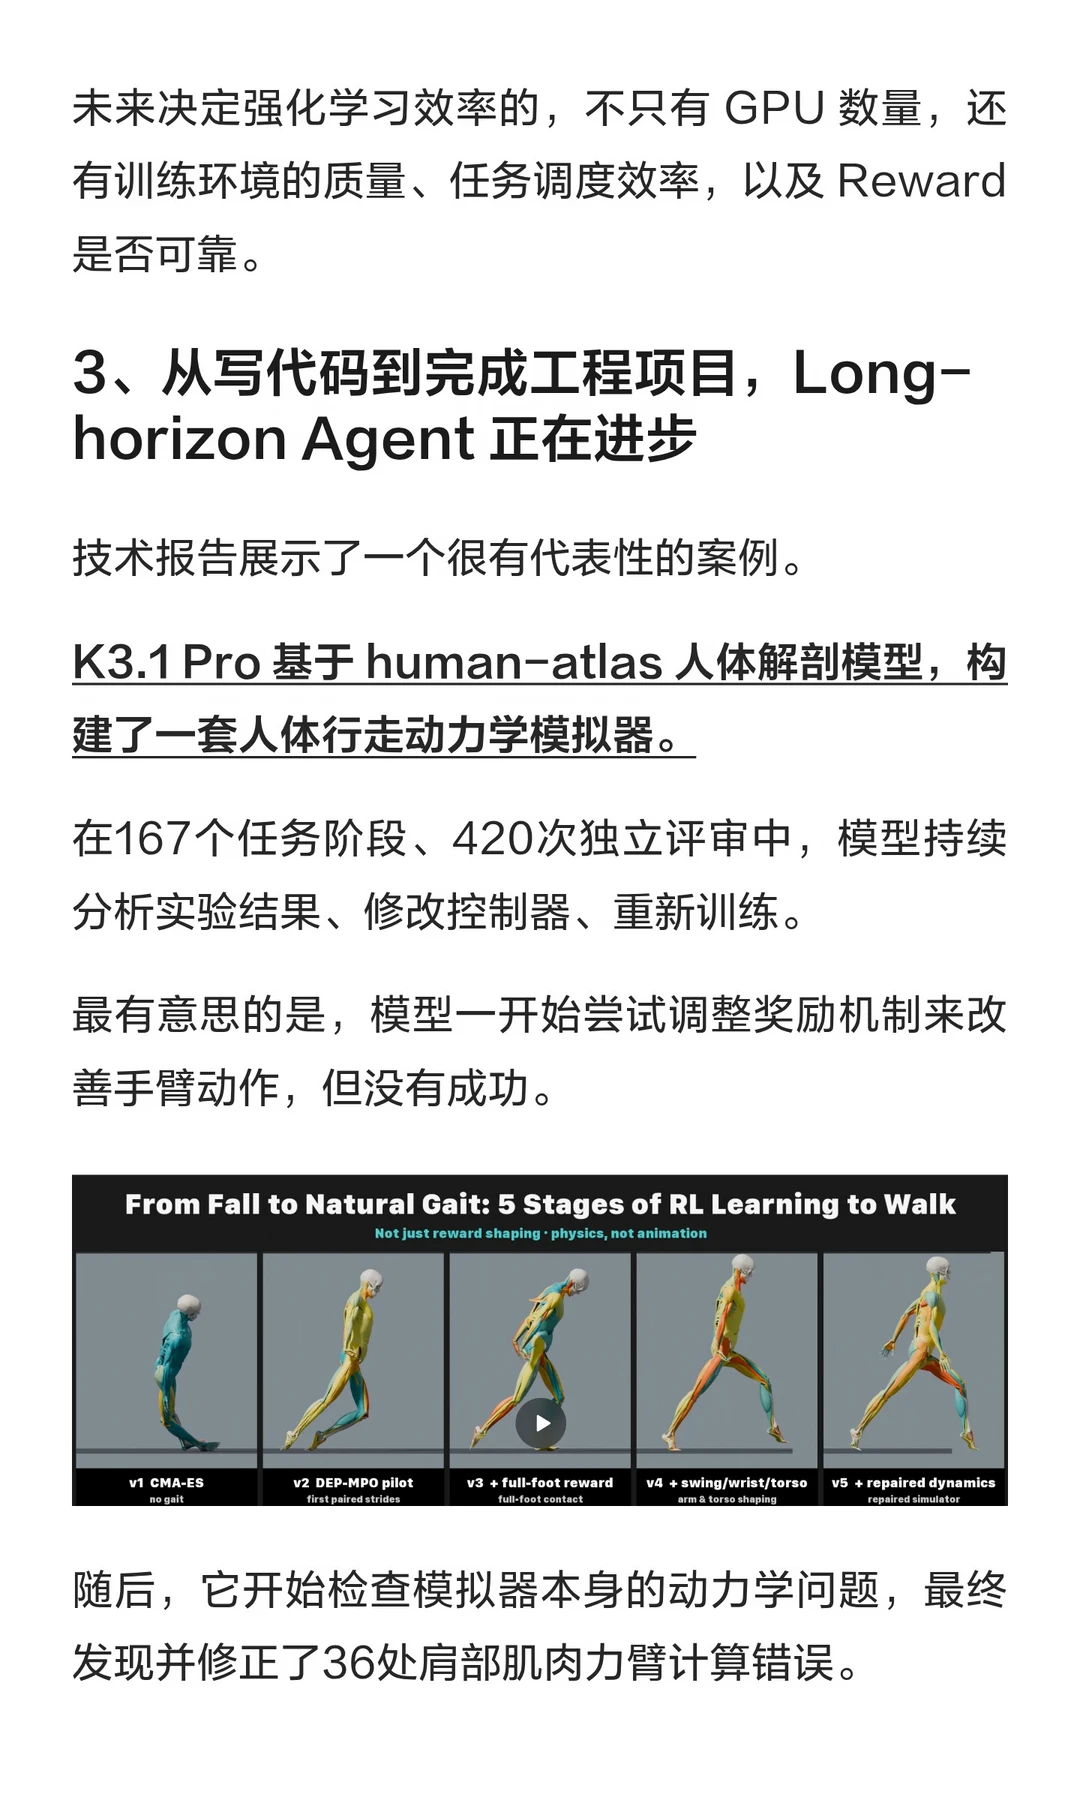
Kimi 在构建人体行走模拟器时,经过167个任务阶段、420次评审,最终发现并修正了36处动力学计算错误,让模拟人物连续行走11.2秒。
它不只是修改代码,还能分析实验失败的原因,发现环境本身的问题,再修复并重新训练。
另外,在 BenchCAD 测试中,K3.1 Pro 使用工具后,成绩从72.8提升到92.7。
Agent 正在从代码生成,走向长周期、可验证的工程任务执行。
强大的基础模型,规模化 Agent RL,高质量的训练环境和反馈机制,可以继续推动模型能力显著提升,或许是后续大模型厂的重点方向。
#Kimi #月之暗面 #KimiK31 #KimiK31Pro #RLScaling #AgentHarness