DeepInfer 开源后,SGLang 和 vLLM 这周末接连公布了优化后的对标结果。围绕同一个模型 DeepSeek-V4.1-Flash,两家通用推理框架都在尝试进一步提高运行效率,在各自测试里,已经接近,部分还能更快一点。
我觉得,这件事值得关注的地方,是它让推理工程的价值变得更具体了。另外就是怎么 DeepSeek 一开源,大家突然都快了?
1、同一个模型,服务效率仍然有提升空间
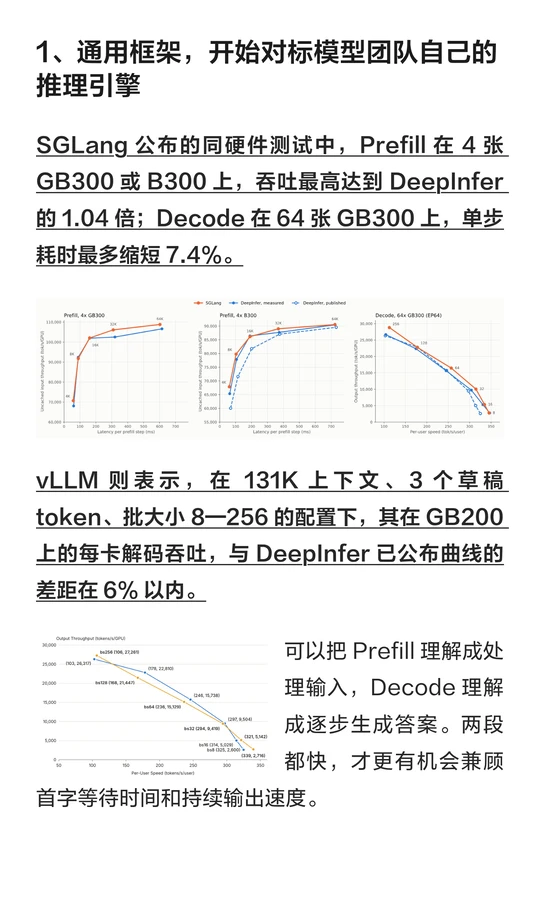
SGLang 公布的同硬件测试中,Prefill 在4张 GB300 或 B300 上,吞吐最高达到 DeepInfer 的1.04倍;Decode 在64张 GB300 上,单步耗时最多缩短7.4%。
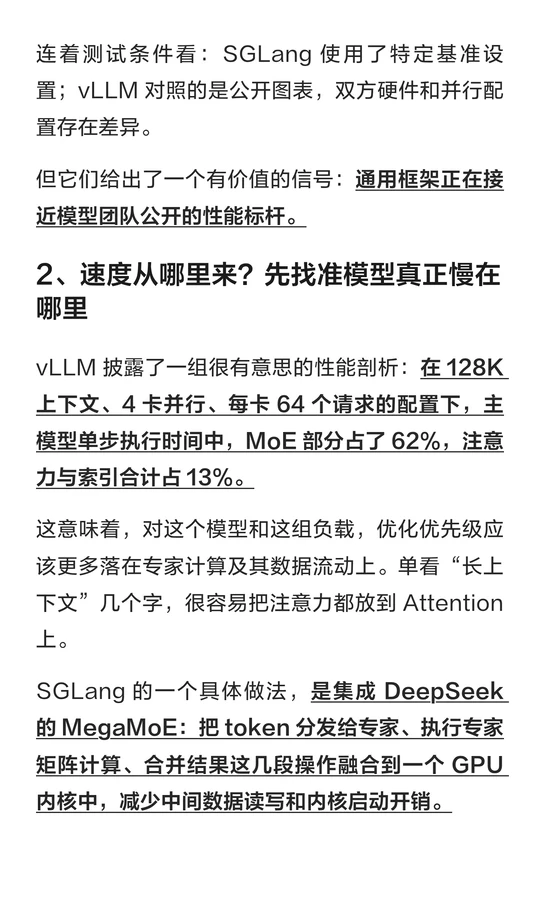
vLLM 则表示,在131K上下文、3个草稿 token、批大小8—256的设置下,其在 GB200 上的每卡解码吞吐,与 DeepInfer 已公布曲线的差距在6%以内。
这些结果需要连着条件看。两家的测试口径存在差异,不能直接拼成统一排名,但能看到通用框架正在接近模型团队公开的性能标杆。
2、这轮进步,来自持续积累和技术共享
这些优化并非都在 DeepInfer 开源后才开始。vLLM 之前已经发布过优化文章,SGLang 也已接入 DeepGEMM 内核的一项 PR。
DeepInfer 最初主要基于 vLLM,也受到 SGLang 等项目的启发;两家如今又持续吸收 DeepSeek 开放的高性能内核。工程经验在不同项目之间流动,成为继续优化的基础。
3、真正的难点,是把局部加速变成整体收益
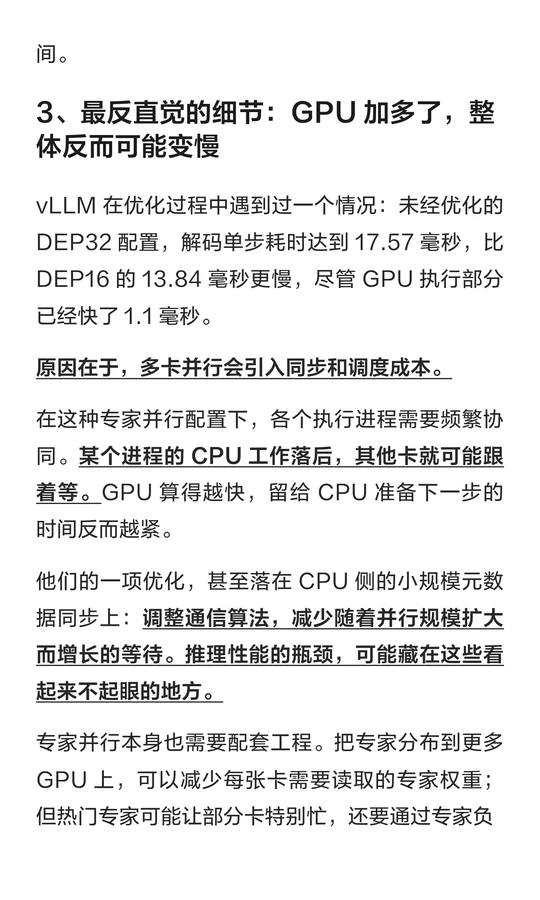
vLLM 披露过一个细节:在一次未经优化的配置里,32卡的解码单步耗时为17.57毫秒,比16卡的13.84毫秒更慢,尽管 GPU 执行部分已经加快。同步和调度开销抵消了计算收益。
这说明,增加 GPU、接入更快的内核之后,还要处理通信、缓存和负载均衡。单个环节的性能提升,需要整套系统配合才能兑现。
我的理解是,模型开源让更多人获得能力,推理工程的开放则帮助更多人高效地使用这些能力。最终值得比较的,是在相同质量和延迟要求下,真实任务能否跑得更快、更稳定、更省资源。
但 DeepSeek 在 Infra 的造诣真的是业界之秀啊。
#DeepSeek #AIInfra #AI推理 #DeepInfer #SGLang #vLLM #大模型推理 #开源AI #大模型