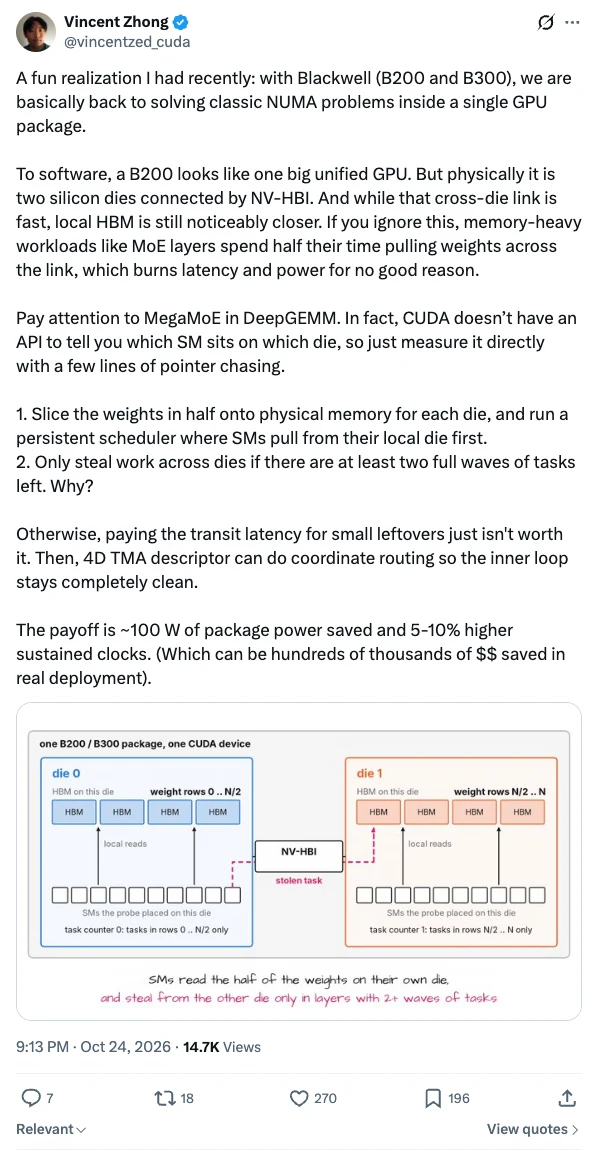
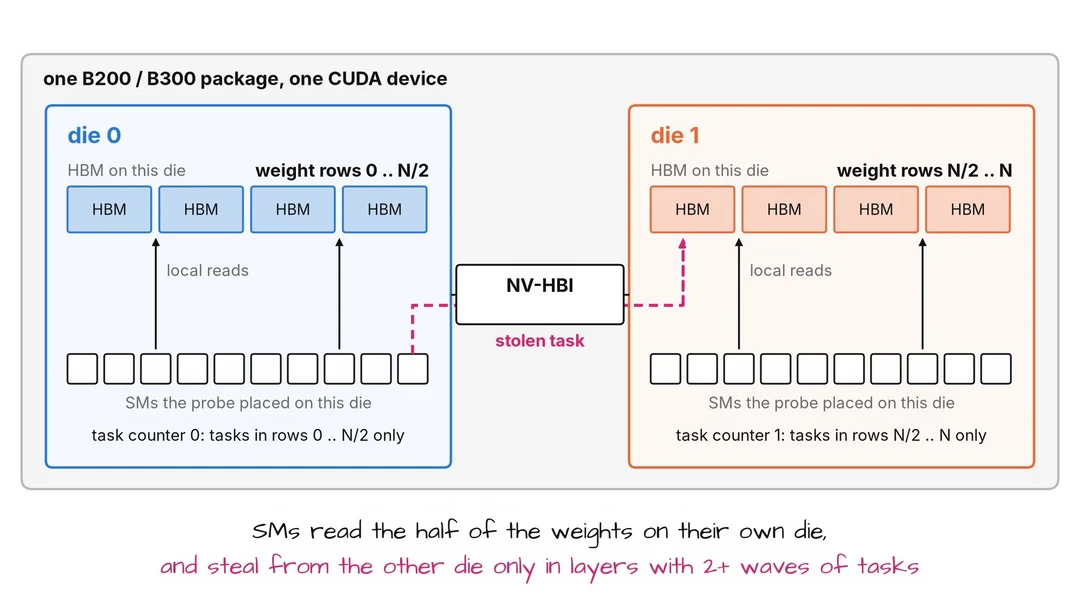
B200 在软件里看着是一整张卡,这点比看上去要紧。物理上它是两颗 die,靠 NV-HBI 连着,链路很快,但本 die 上的 HBM 还是更近。按原帖的说法,MoE 层要是不管这个,一半时间都花在跨 die 搬权重上。
CUDA 没有接口告诉你哪个 SM 在哪颗 die 上,只能用几行 pointer chasing 自己测。测完把权重切成两半,各放在一颗 die 的显存里,SM 先做本 die 的任务;剩下的任务不到两整波,就不去对面抢,零头不值得付跨 die 的延迟。他给的收益是封装功耗省约 100W,持续频率高 5% 到 10%。
有点像把 CPU 上的 NUMA 调度搬进了一个封装里,只是调度单位换成了 SM。这种事以后得每个 kernel 自己处理,还是会被 CUDA 收走?
#人工智能 #英伟达 #GPU #大模型 #CUDA