说是跟闭源头部模型打平,那 Terminal-Bench Science 那一格怎么算?
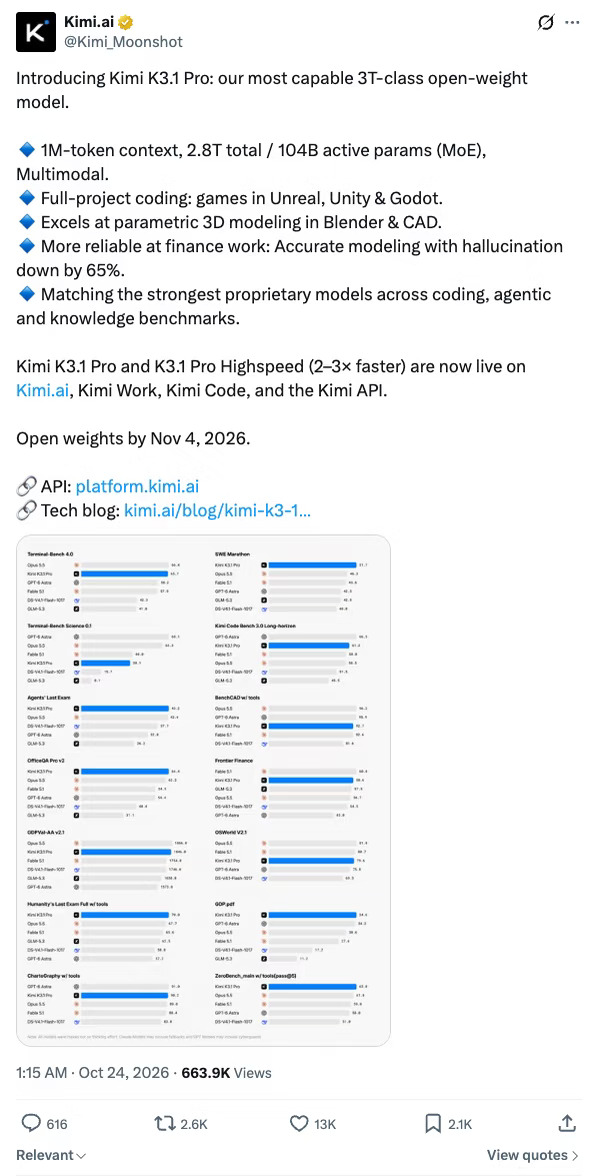
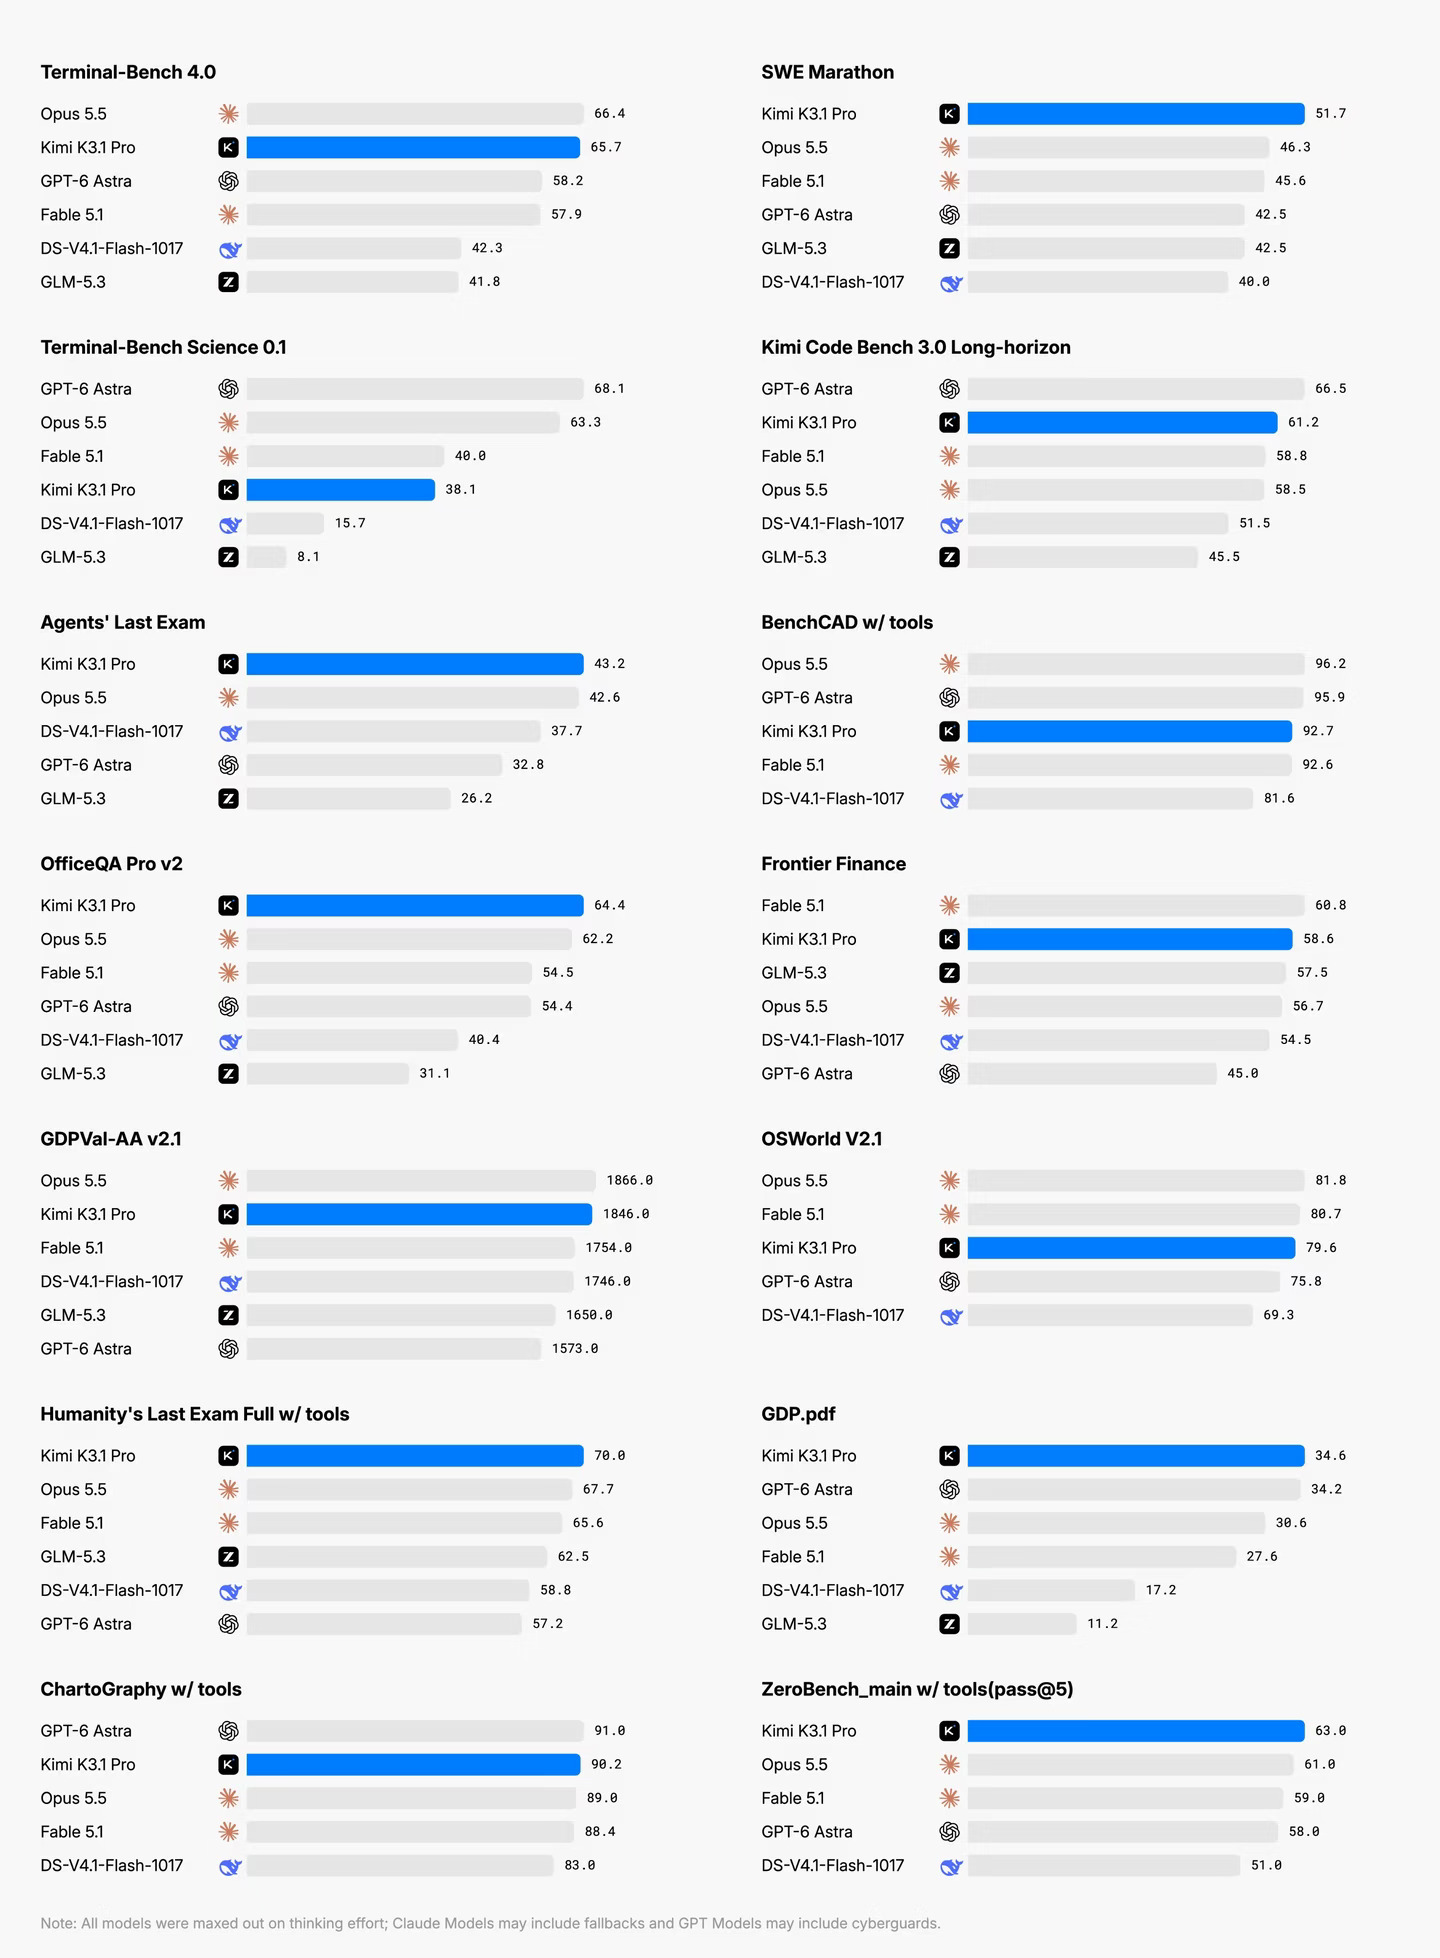
Kimi 贴的对比图,我从头看到尾。左上角 Terminal-Bench 4.0 是 65.7,跟 Opus 5.5 的 66.4 只差一点,正文主推的也是这个数。
往下一格就变了。
Terminal-Bench Science 0.1:GPT-6 Astra 68.1,Opus 5.5 63.3,Fable 5.1 40.0,K3.1 Pro 38.1。跟榜首差了 30 分,整张图里蓝条大多领先或贴着头名,就这一条短了一大截。正文没提这个榜,挑好看的放前面嘛,发布会都这么干。
不过这格没从图里删掉,还算老实。掉分的也不只它,DS-V4.1-Flash 15.7,GLM-5.3 只有 8.1,这个榜对谁都不太友好。
同样在终端里干活,换成科研任务就掉一截,到底卡在领域知识上,还是任务链更长、工具更冷门?
#Kimi #大模型 #人工智能 #AI编程 #AI