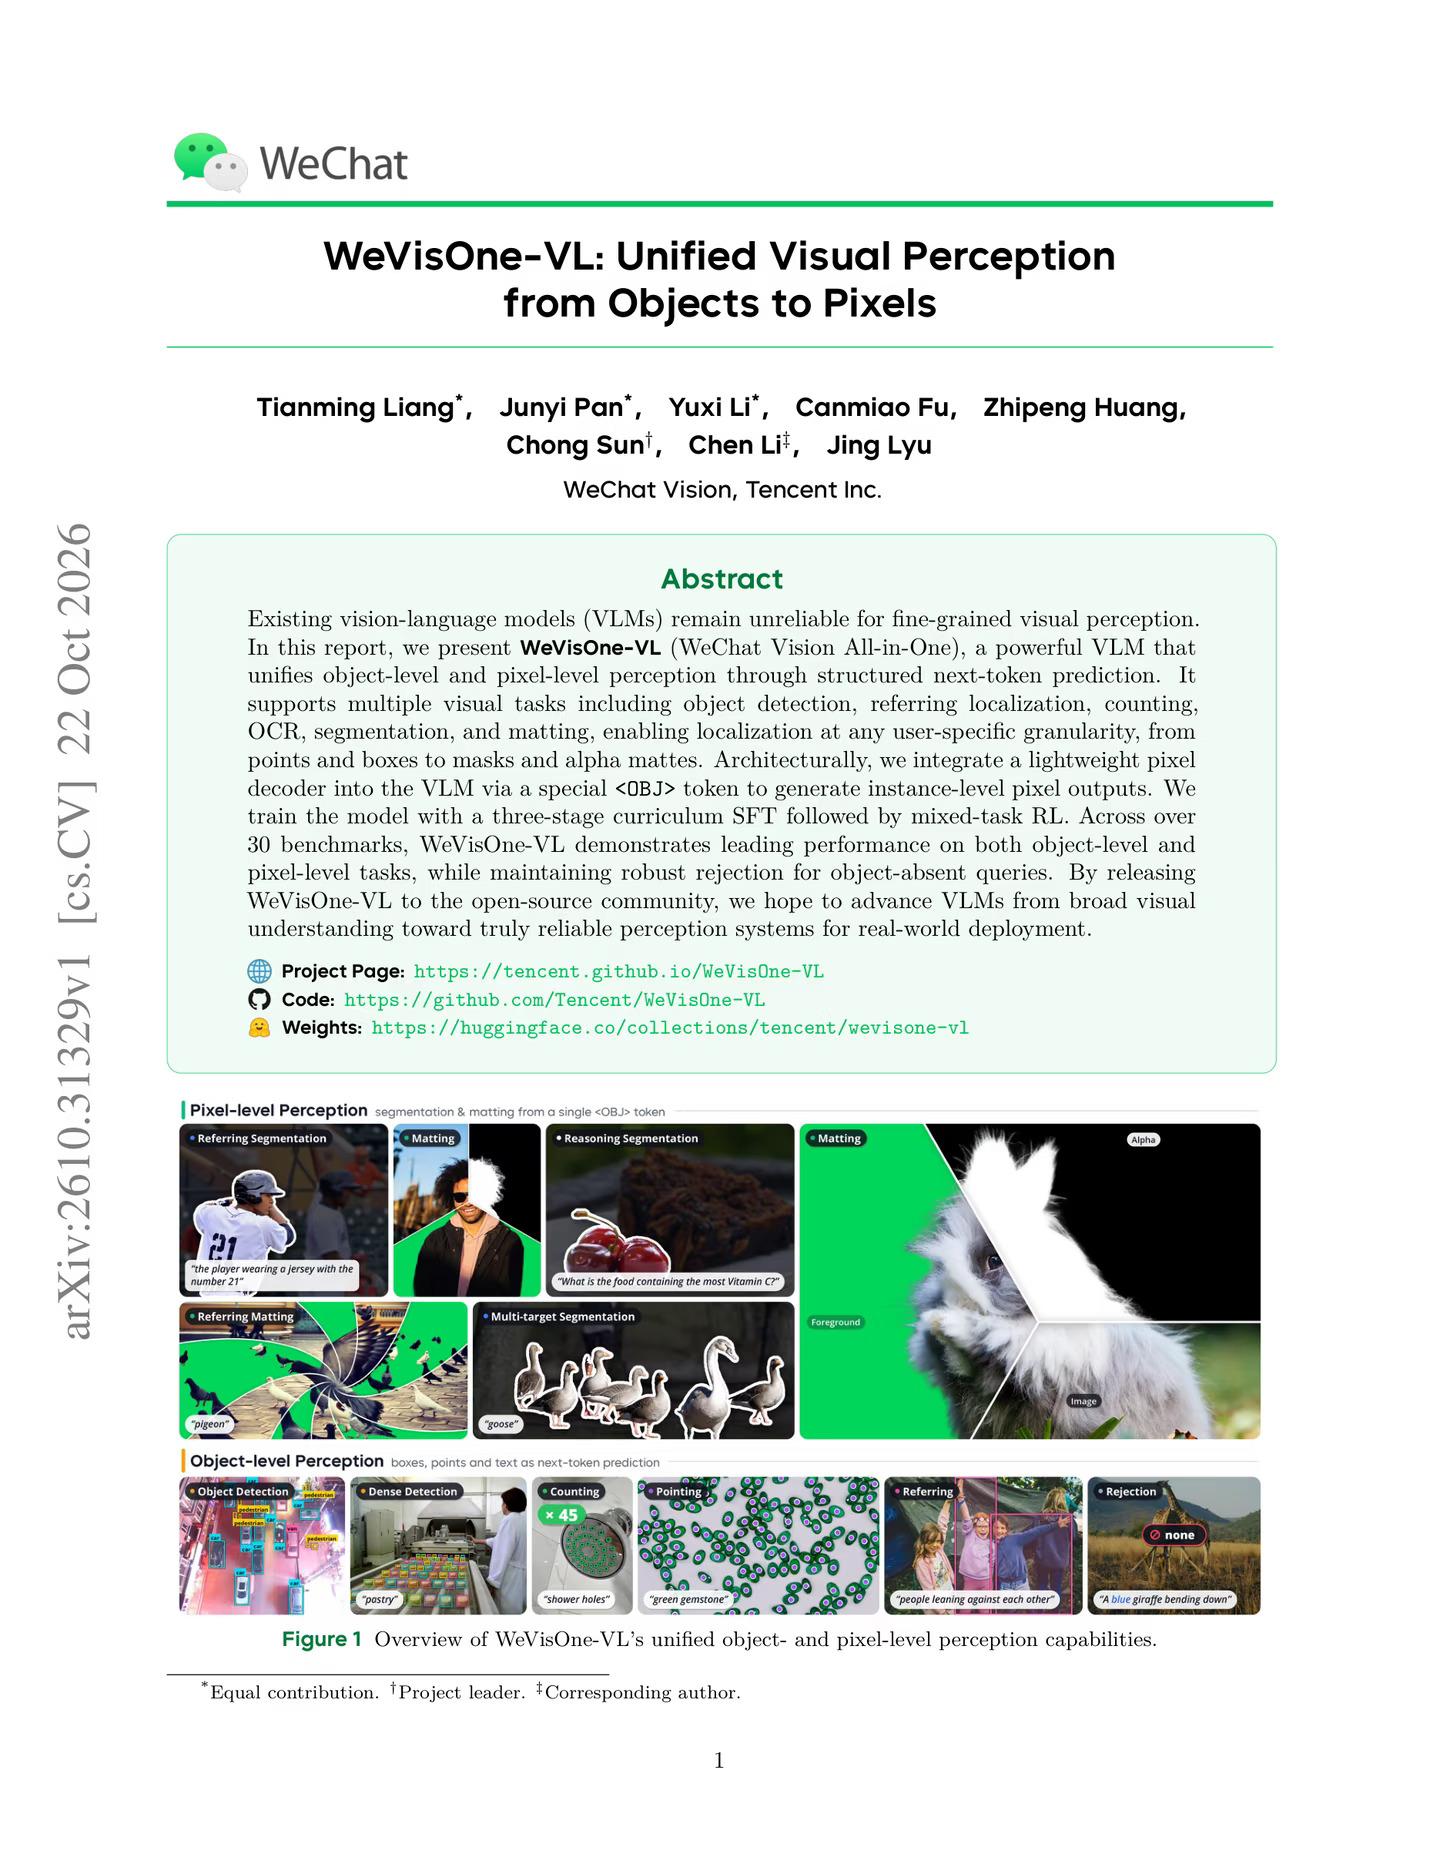
RefCOCOg-Rej 里每条描述在图中都找不到对应物体,正确做法是一个框都不出。LocateAnything-3B 的拒答率 0.6%,Rex-Omni-3B 0.5%,WeVisOne-VL-4B 是 67.4%。
这组数比它三十多个 benchmark 上的涨点更值得看。用户问图里没有的东西,模型照样画个框,下游就跟着错。分割上也一样,Ref-ZOM 里 UniPixel-7B 拒答 0.3%,它是 86.0%。
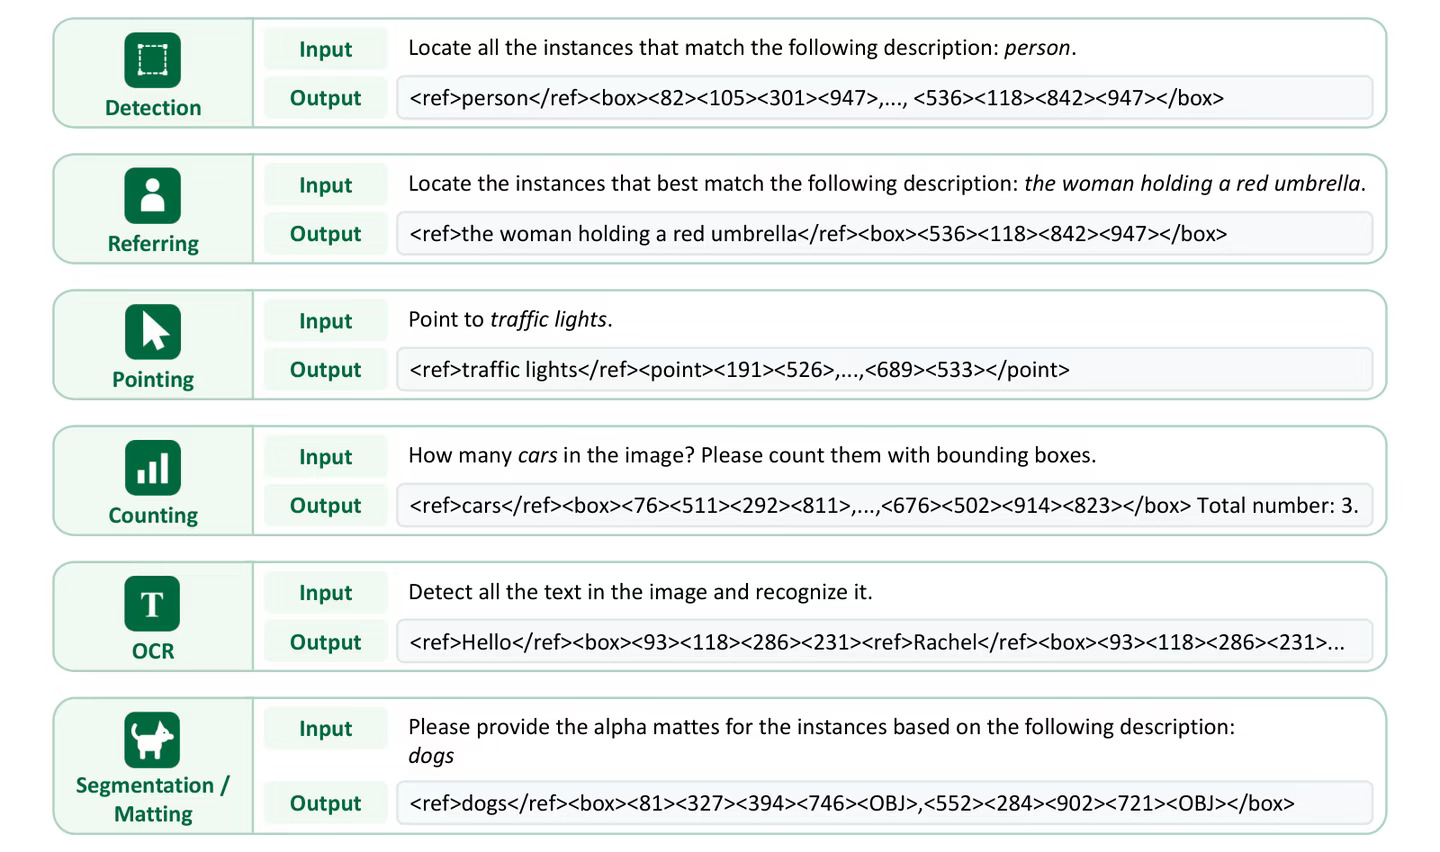
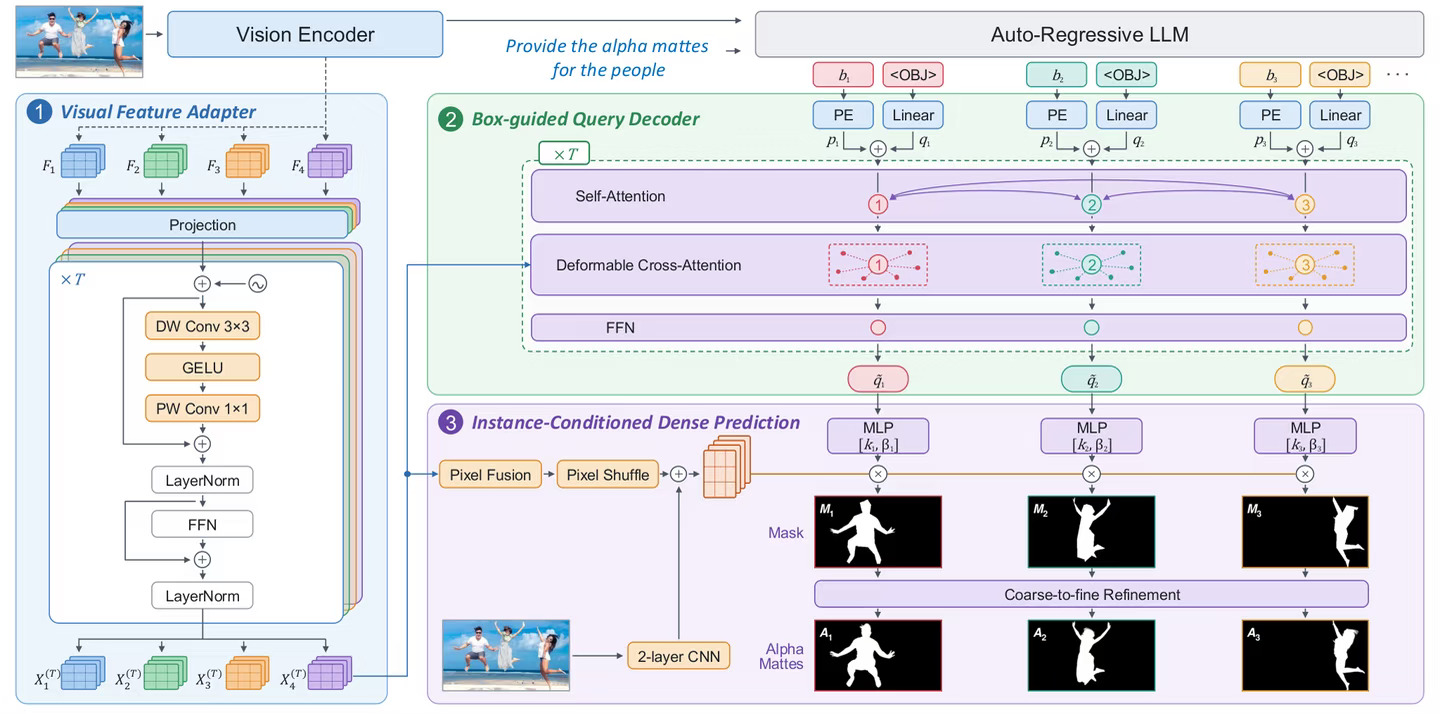
模型是腾讯微信视觉团队在 Qwen3-VL 上做的,2B 和 4B 两档,坐标用 <0> 到 <1000> 的专用 token 直接生成。要 mask 或 alpha matte(抠图用的透明度图)时,就在框后面多出一个
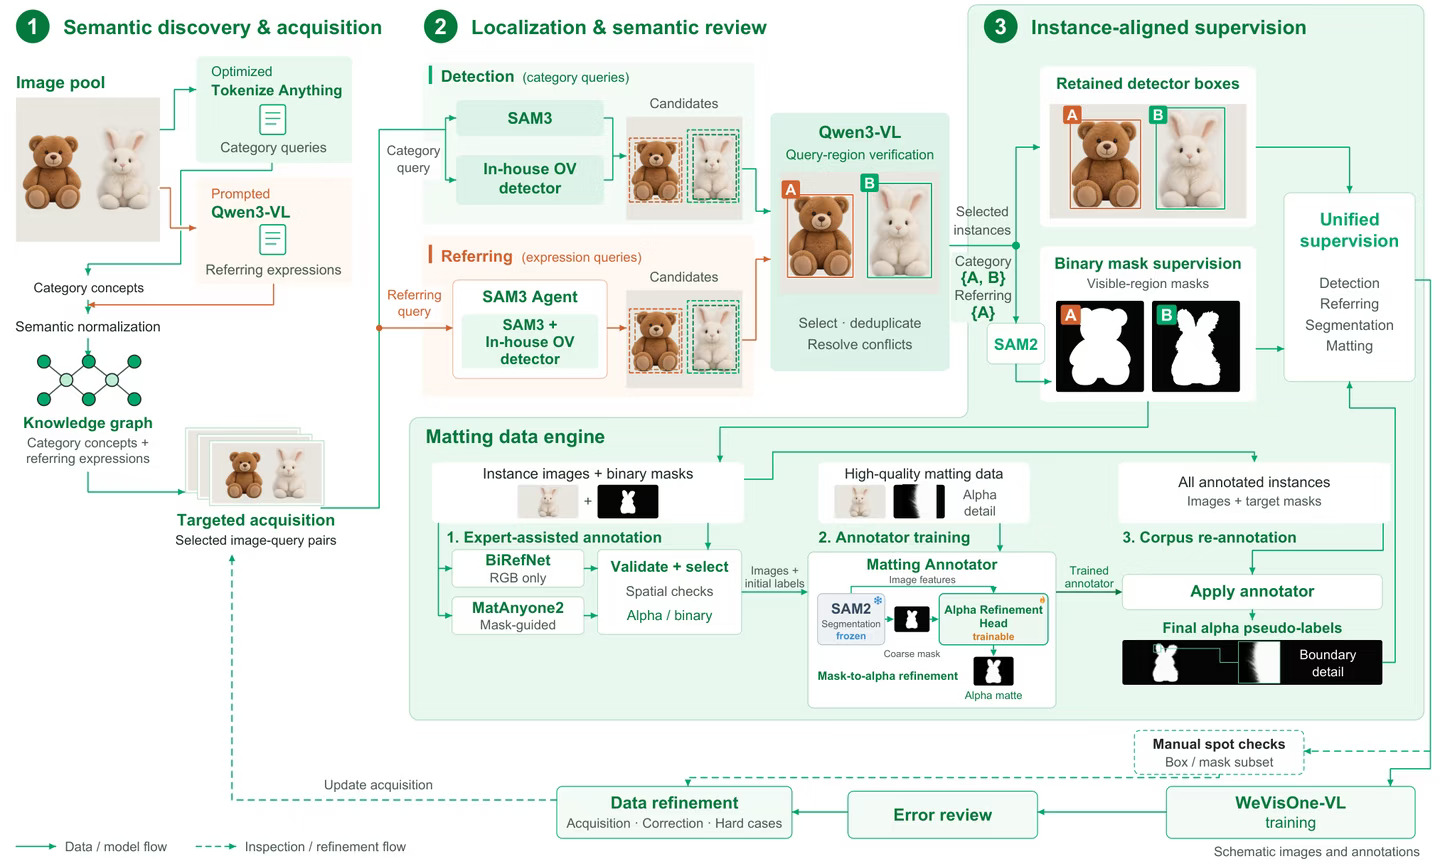
自建的 WeRef-Bench 上它 F1 78.7、拒答 96.4,召回没被压下去,不过这是他们自己的 in-house 集。
论文:https://arxiv.org/pdf/2610.31329
代码:https://github.com/Tencent/WeVisOne-VL
#人工智能 #计算机视觉 #大模型 #论文 #深度学习