宇树科技的AI具体在哪里?
拆解三大算力阵地:本地、云端、训练中心
提到宇树科技,很多人第一反应是能跑、能跳、会格斗的人形机器人、四足机器狗。但不少人容易混淆一个问题:它的AI到底是装在机器人身上,还是放在远程服务器?
宇树并不是简单把一个大模型塞进去,而是分成机器人本机硬件算力(本地端)、云端大模型服务、研发训练中心三大部分协同工作,运动控制算法固定跑在本体,对话推理支持本地/云端两种选择,分工非常清晰。
一、本地端:机器人本体算力,是机器人的“小脑”,负责保命和动作
这是大家肉眼能摸到、跟着机器人走的AI算力单元,也是宇树最核心的优势所在。
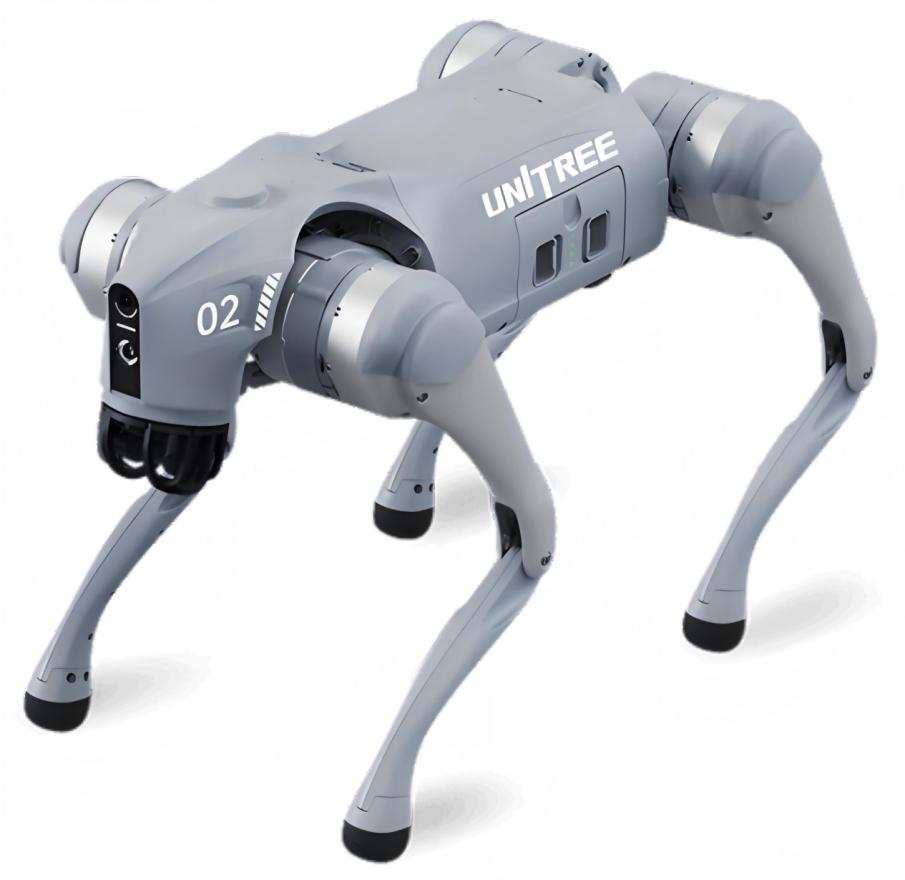
每一台G1、H1人形机器人、Go系列四足机器狗本体,都搭载独立机载计算单元,专门承载运动控制算法。平衡、行走、小跑、爬坡、摔倒自恢复、关节力矩调节、基础避障、SLAM定位这些实时动作闭环,全部在本地完成,不需要联网、不依赖云端。
这一点非常关键:运动控制对延迟要求极高,一旦依靠网络传输,网络波动、断网就会直接导致摔倒、失控。所以宇树把这套底层控制策略固化在端侧算力里,断网状态下,机器人依旧可以稳定行走、保持姿态,基础感知能力正常工作。
除了小脑运动算法,机载算力也可以部署轻量化小模型:简单语音对话、基础视觉识别、简易指令理解,这些轻量化推理可以本地运行,实现离线交互。
但本地硬件的功耗、显存上限有限,复杂长任务规划、多轮深度对话、高复杂度世界模型推演,单纯靠本体算力很难跑满,这就需要云端来补充 。
一句话总结本地AI:动作控制永远本地跑;简单对话可选本地轻量化模型。
二、云端大模型服务:机器人的“大脑”,负责高阶认知
云端是宇树的高阶推理阵地,机器人通过网络把视觉画面、语音指令、传感器数据上传,由云端大模型完成理解、任务拆解、逻辑推理、多步骤任务规划,再下发动作指令给本体执行。
适用场景:复杂自然语言对话、开放式任务拆解、复杂场景语义理解、长序列任务编排。
举个例子:“帮我把桌面上的水杯拿到隔壁桌子,然后把垃圾丢进垃圾桶”,这种需要多步骤规划、理解环境逻辑的任务,更适合云端大模型处理。
这里要划一个容易踩坑的重点:推理不是强制云端。宇树采用可选模式,开发者和客户可以根据场景需求切换:
- 涉密、无网络、工业现场:优先本地轻量化推理;
- 展厅、商用服务、开放交互场景:接入云端,获得更强的理解能力。
短板同样明显:依赖网络。一旦网络中断,云端的高阶认知、复杂任务规划会失效,但机器人的行走、平衡、基础避障这套运动控制不受影响,不会直接瘫痪。
三、研发训练中心:AI的“加工厂”,不直接给机器人实时推理
很多人会把训练算力和推理算力混为一谈,这也是最容易误解的地方。
不管是本地跑的运动策略、VLA视觉语言动作模型,还是对接云端的大模型,都不是凭空出现的。宇树专门搭建研发训练算力集群、仿真平台、数据采集实验室,这就是第三块AI阵地。
它的作用是:采集机器人真实环境数据、在仿真环境里做强化学习、预训练具身模型、调优动作策略、迭代世界模型,把训练收敛后的算法、轻量化模型权重,打包下发到机器人本体,或者部署到云端推理服务中。
训练中心不跟着机器人实时在线干活,它是后台迭代工厂,负责生产、优化模型;训练完成之后,模型才会分流到本地端或者云端去做推理。
像大家看到的机器人格斗演示里的高复杂度世界模型推演,部分版本的重算力推演,现阶段是在外部服务器/训练集群运行,并非原生机载能力,属于实验室验证方案,还在持续压缩、向端侧迁移的过程中。
总结一张极简逻辑
1. 本地本体算力:核心=运动控制(必跑本地);附加=轻量化识别、简易对话(可选本地推理),低延迟、离线可用;
2. 云端大模型服务:核心=高阶对话、复杂任务规划(可选开启),能力更强、依赖网络;
3. 研发训练中心:核心=模型训练、仿真学习、数据迭代,是后台工厂,不做机器人实时交互推理。
宇树这套架构的底层思路很务实:把不能等、不能断的运动安全留在机器人身上;把吃算力、强理解的认知能力放在云端;训练集群持续迭代两套模型,不断缩小本地和云端之间的能力差距。
在具身智能赛道里,不是算力全部堆在机器人上就代表先进,这种分层部署,也是目前人形机器人商业化落地里主流的工程取舍路线。
免责声明:本文内容仅为技术架构科普,不构成任何投资、产品采购建议,技术方案随版本迭代持续优化,具体能力以宇树官方文档、产品规格为准。
机器人宇树 宇树H2机器人