最近 Harness 自进化方向的研究越来越多了,但有个问题:Agent 怎么知道什么时候该修改、应该改哪里,以及哪些修改反而有害?
马里兰大学、华盛顿大学、UIUC、Scale 的新论文 Meta²,尝试让Agent学会如何进化自己的 Harness。
几个有意思的点:
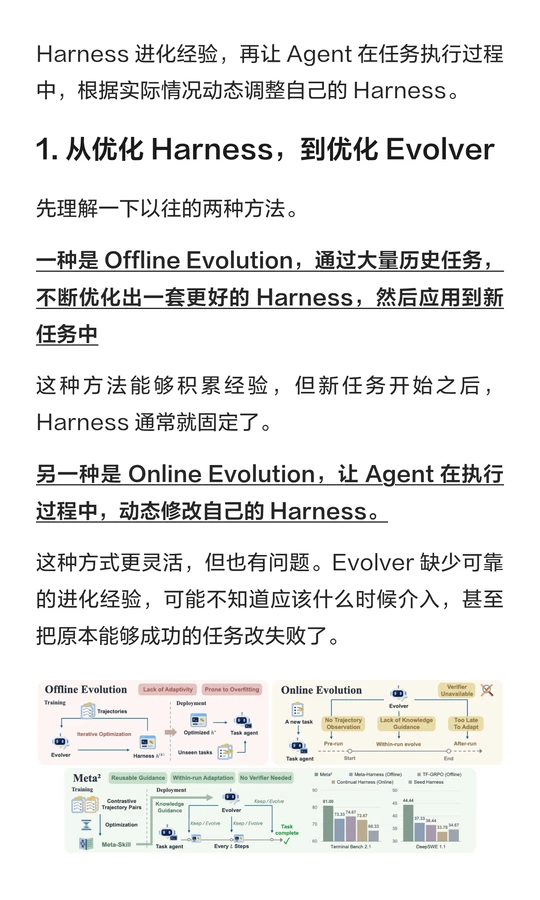
1、从优化Harness,到优化Evolver
过去主要有两种方式:Offline Evolution:从历史任务中优化 Harness,但难以适应新任务;Online Evolution:执行过程中动态修改 Harness,但容易盲目干预。
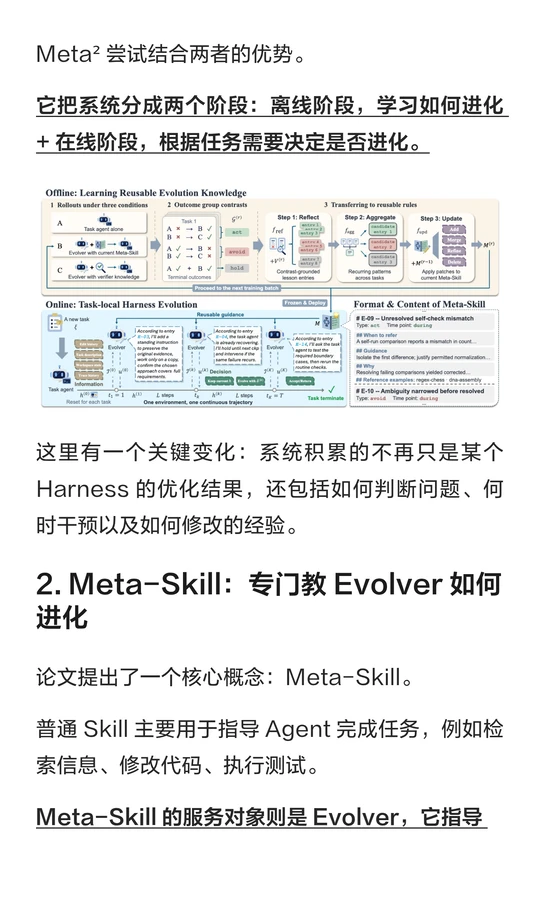
Meta² 结合两者优势:离线学习进化经验,在线按需调整 Harness。
2、Meta-Skill:教Agent如何进化
普通 Skill 教 Agent 完成任务,Meta-Skill 则指导 Evolver 如何修改 Harness。
论文将进化策略分成三类:
ACT:应该干预,例如发现 Agent 遗漏了必要验证。
HOLD:保持现状,让 Agent 自主解决问题。
AVOID:避免可能产生负面效果的修改。
HOLD 和 AVOID 很有意思,Agent 不仅需要学会自我改进,还需要知道什么时候不该干预。
3、进化经验从哪里来?
研究者对比三组执行轨迹:原始 Agent、当前 Evolver,以及训练时获得额外验证信息的 Evolver。
通过比较成功与失败的案例,提炼可复用的 Meta-Skill。
整个过程不需要更新基础模型权重。
4、实验效果怎么样?
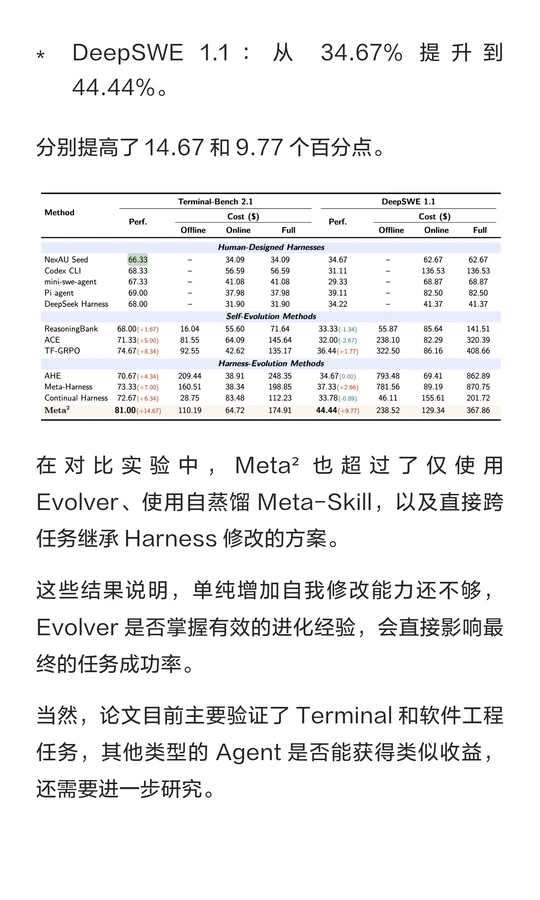
Terminal-Bench:66.33% -> 81.00%,DeepSWE:34.67% -> 44.44%。
进化经验可以跨任务复用,但具体的 Harness 修改最好只在当前任务生效。 直接继承上个任务的修改,反而可能降低性能。
未来 Agent 可能需要两类 Skill,一类教它如何完成任务,另一类教它如何进化自己。
如果未来能将任务反馈、经验提炼、评测和 Meta-Skill 更新连接起来,Agent 就有机会真正实现持续自进化。
#Meta2 #RecursiveSelfImprovement #AIAgent #Harness #MetaSkill #Agent自进化 #RSI #AI学术