值得关注的不只是参数规模,而是本地编码模型的“质量-速度”边界又被推进了一步。Recursive_SI 发布首个模型 Flint:一个 40B 总参数、约 2B 激活的 MoE 编码模型,从零到完成用了不到 4 个月,背后是自动化研究系统 Eureka Machine。
📌 官方给出的几个关键数字:
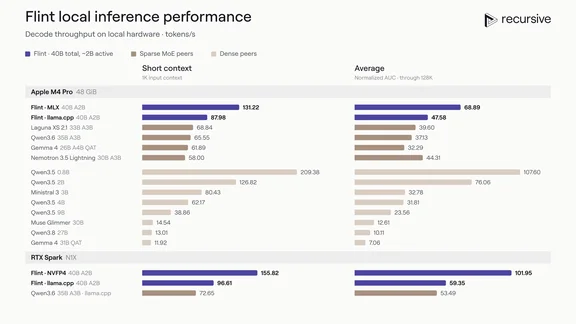
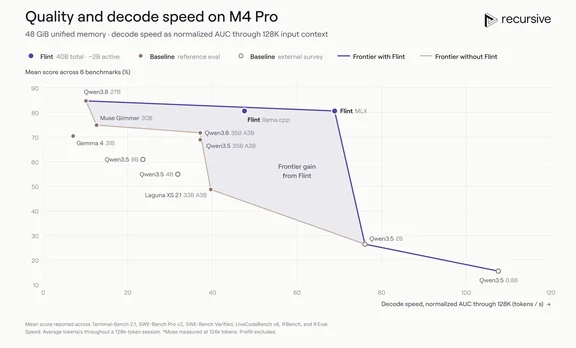
• 在 M4 Pro MacBook Pro 上达到 125+ tokens/秒,在 64GB NVIDIA RTX Spark 上达到 150+ tokens/秒;短上下文最高比同类模型快 2 倍,比编码分数相近的稠密模型快 5 倍以上。图中 M4 Pro 的 MLX 短上下文标到 131.22 tokens/秒,RTX Spark NVFP4 标到 155.82。
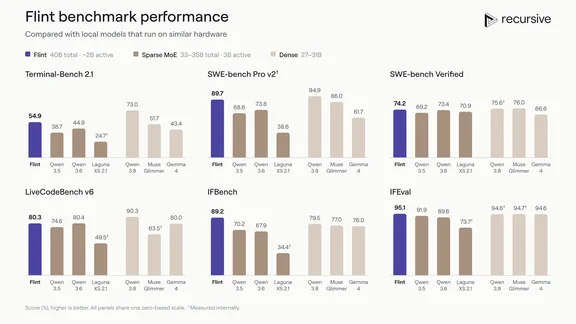
• 在 50B 以下的 MoE 同类模型中,SWE-bench Pro v2 为 89.7、Terminal-Bench 2.1 为 54.9、SWE-bench Verified 为 74.2;图中还列出 LiveCodeBench v6 80.3、IFBench 89.2、IFEval 95.1。
• 低比特训练让模型缩小 71% 且质量几乎无损,再配合更稀疏的模型形态和自定义内核;官方强调数据留在本地。
我的看法:Flint 最值得看的不只是单项跑分,而是它把“本地编码助手能不能顺手用”这件事往前推了。低延迟和隐私是本地部署的真实痛点;如果这些速度在长上下文和真实仓库任务里也能稳定,可能让更多人在笔记本上跑编码助手。但 benchmark 和内部测量仍需要独立复现,Eureka Machine 的自动化研究循环也还需要更多外部案例来证明。另一个现实点是,这类模型对内存和本地运行时仍有门槛,未必适合所有设备。
你更看重本地模型的隐私,还是 benchmark 分数?
#AI新鲜事