看到一篇很有意思的论文 WebCoder,来自清华大学 等机构。
研究团队基于 27B 模型,通过 Agent 强化学习,让它在前端开发任务中取得了相当亮眼的成绩。
在论文构建的 Webdev-Bench 上,WebCoder 得分达到 72.8,超过 Claude Opus 4.8 的 65.1 和 GPT-5.4 的 59.6。
当然,这是特定评测环境下的结果,不能代表综合编程能力全面超越。
值得关注的,是它背后的训练方法。
1、让模型真正对软件交付结果负责
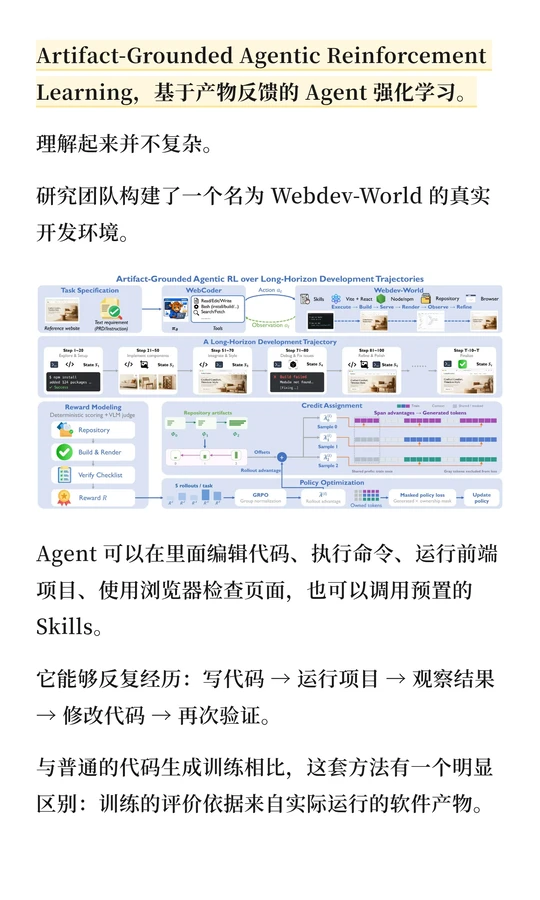
论文提出了 Artifact-Grounded Agentic RL。
研究团队构建了 Webdev-World,让 Agent 可以像开发者一样,写代码、运行项目、打开浏览器检查页面,再根据结果不断修改。
训练时,模型生成多少代码并不重要,最终的软件产物才是评价依据。
如果项目无法构建、运行和渲染,就无法获得好的质量奖励。
2、让模型知道自己哪一步做对
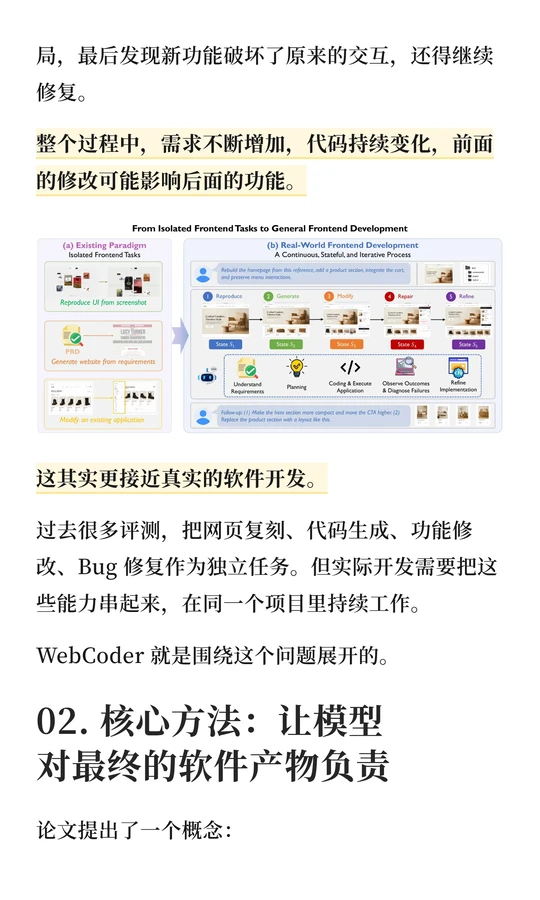
假设 Agent 连续完成五个开发步骤,前三步都很好,第四步修改 CSS 导致布局错乱,第五步又修复了问题。
传统强化学习主要根据最终结果给予整条轨迹奖励,很难区分中哪些步骤真正有效。
WebCoder 引入了基于产物的 Credit Assignment,通过检查不同阶段的软件状态,识别哪些阶段推动了项目进展,哪些造成了回退。
消融实验显示,移除这项机制后,Vision2Web 得分从 62.4 降到了 52.6。
3、让模型从几十万 Token 的开发过程里学习
复杂 Agent 任务往往涉及大量工具调用,执行轨迹可能长达几十万 Token
WebCoder 结合上下文压缩、消息树采样和训练掩码,让模型能够利用长轨迹中的开发经验,同时避免重复计算训练损失。
再分享一点自己的思考:以前我们讨论 Harness,更多关注如何通过工具、Skill、Prompt 和执行流程提升 Agent 能力。
WebCoder 展示了另一个方向:将真实执行环境、产物验证和过程反馈引入强化学习,让模型本身也从中获得提升。
#AI #人工智能 #WebCoder #强化学习 #Agent #Harness #大模型 #AI编程 #智能体