昨天讨论人形机器人,简直吵得不可开交。
有个哥们觉得,那谁谁家的机器人是目前最牛的,因为在春晚上的表演动作整齐划一,难度非常高。
但我不太认同。跳舞的动作可以提前编排,相比之下,我感觉跑马拉松会更考验机器人运动控制和稳定性。
争论了半天,谁也没说服谁。我突然觉得,这背后确实涉及一个特有意思的话题。
不只是人形机器人,放到整个具身智能领域,我们到底应该怎么横向比较不同机器人模型的真实能力?
目前还真没有什么特别好的办法。
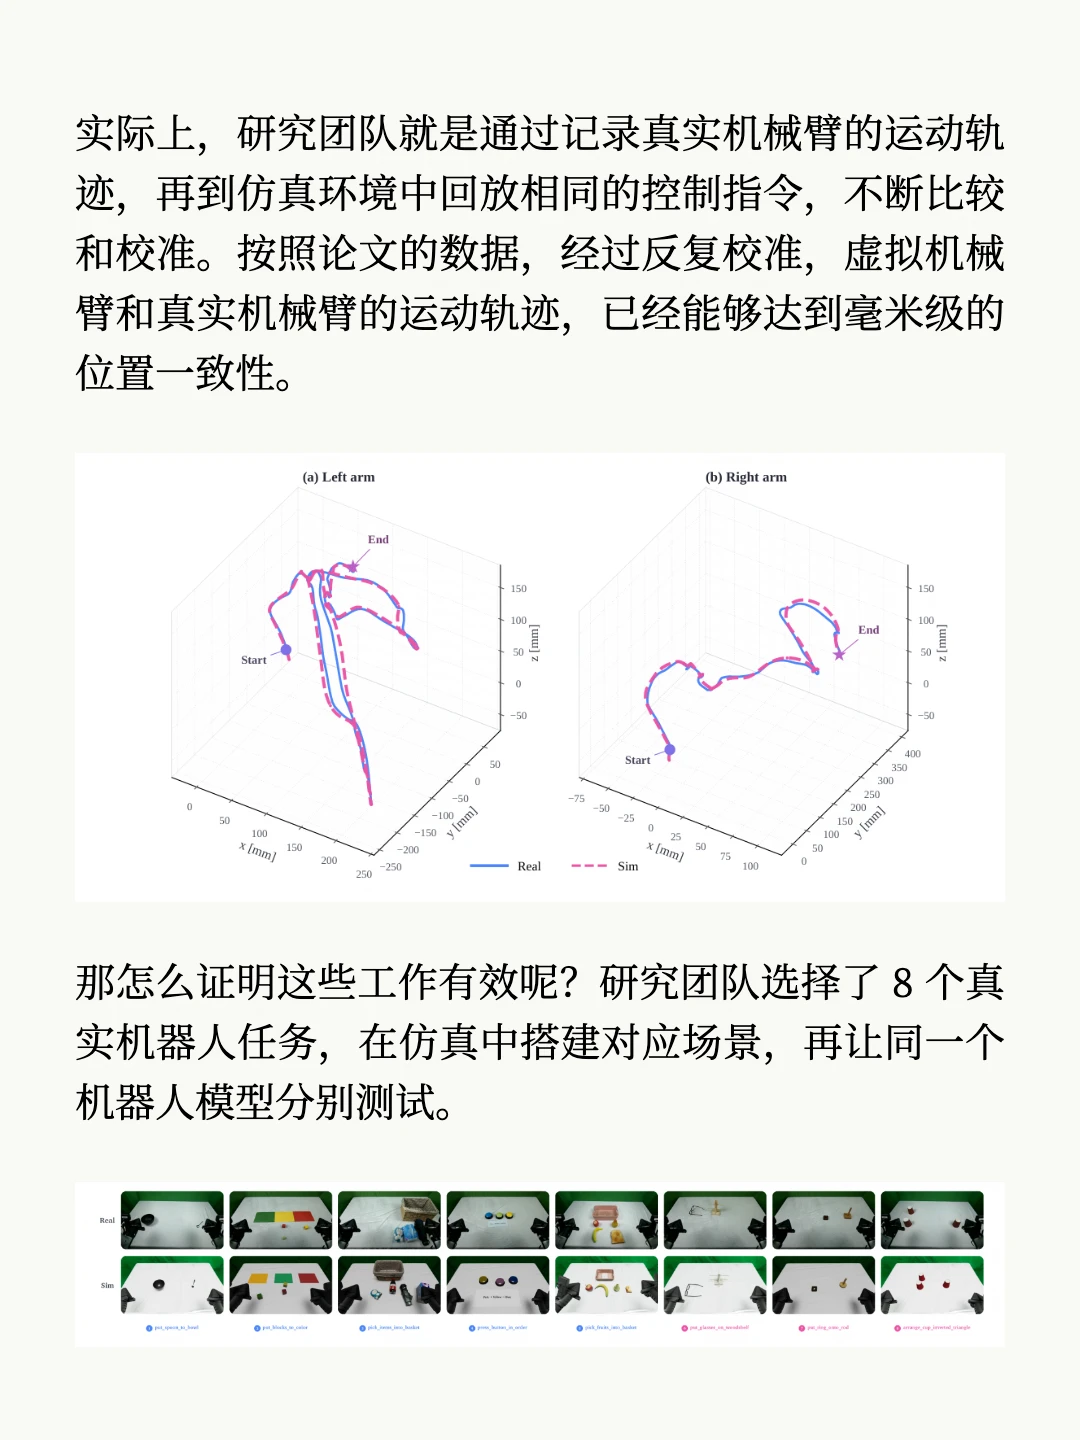
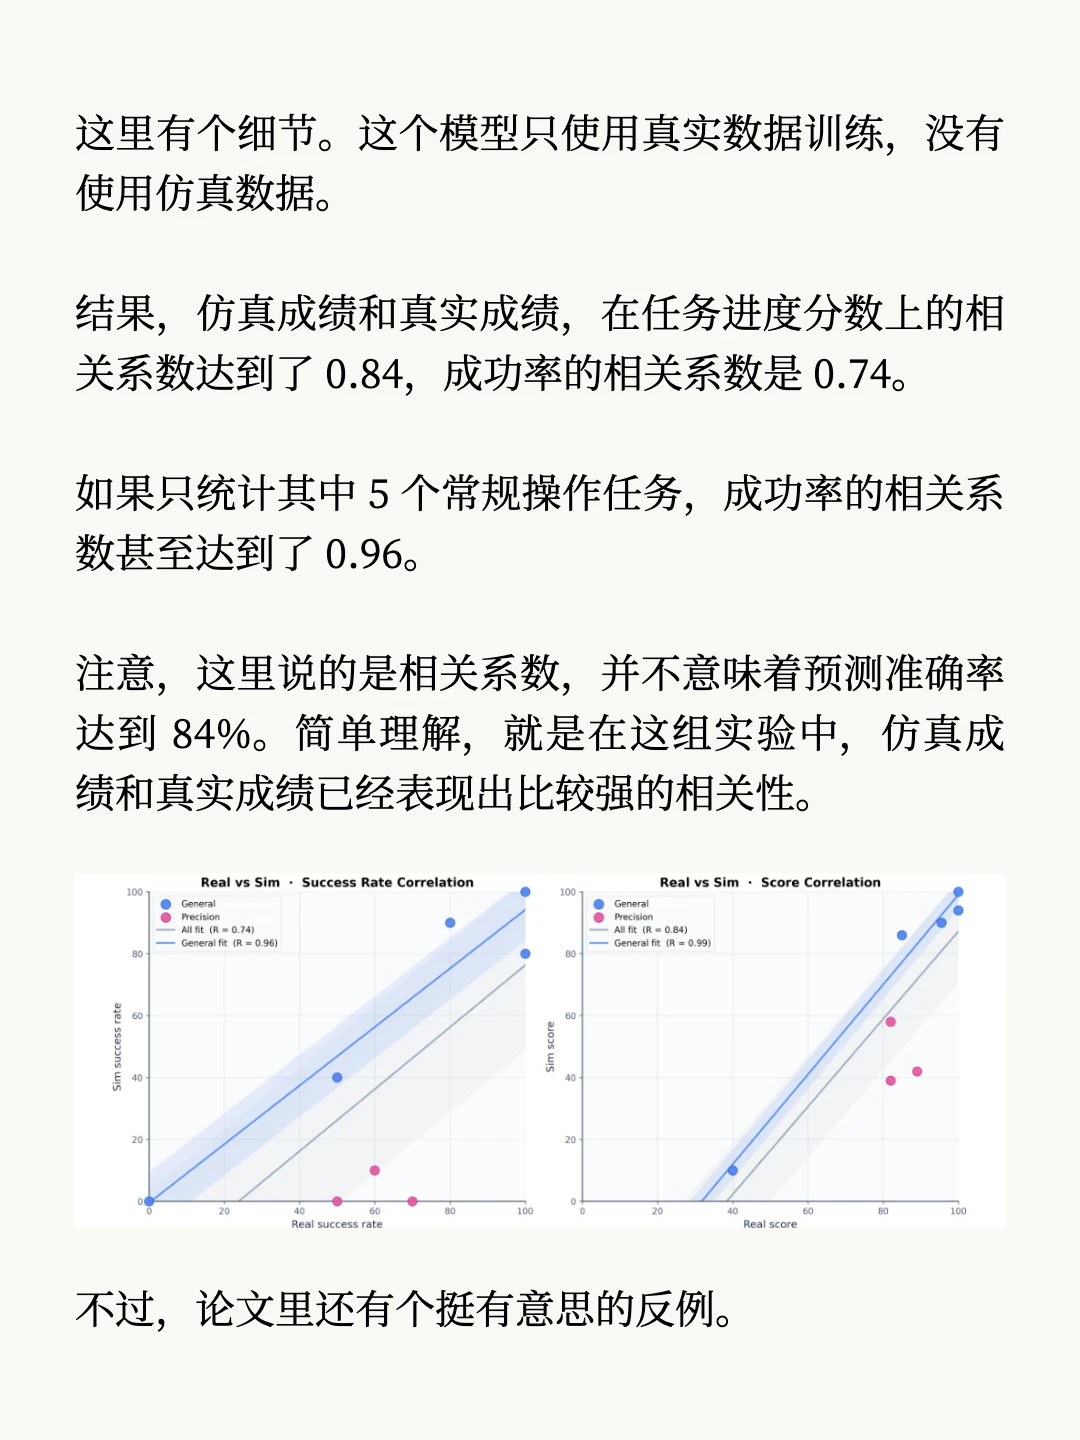
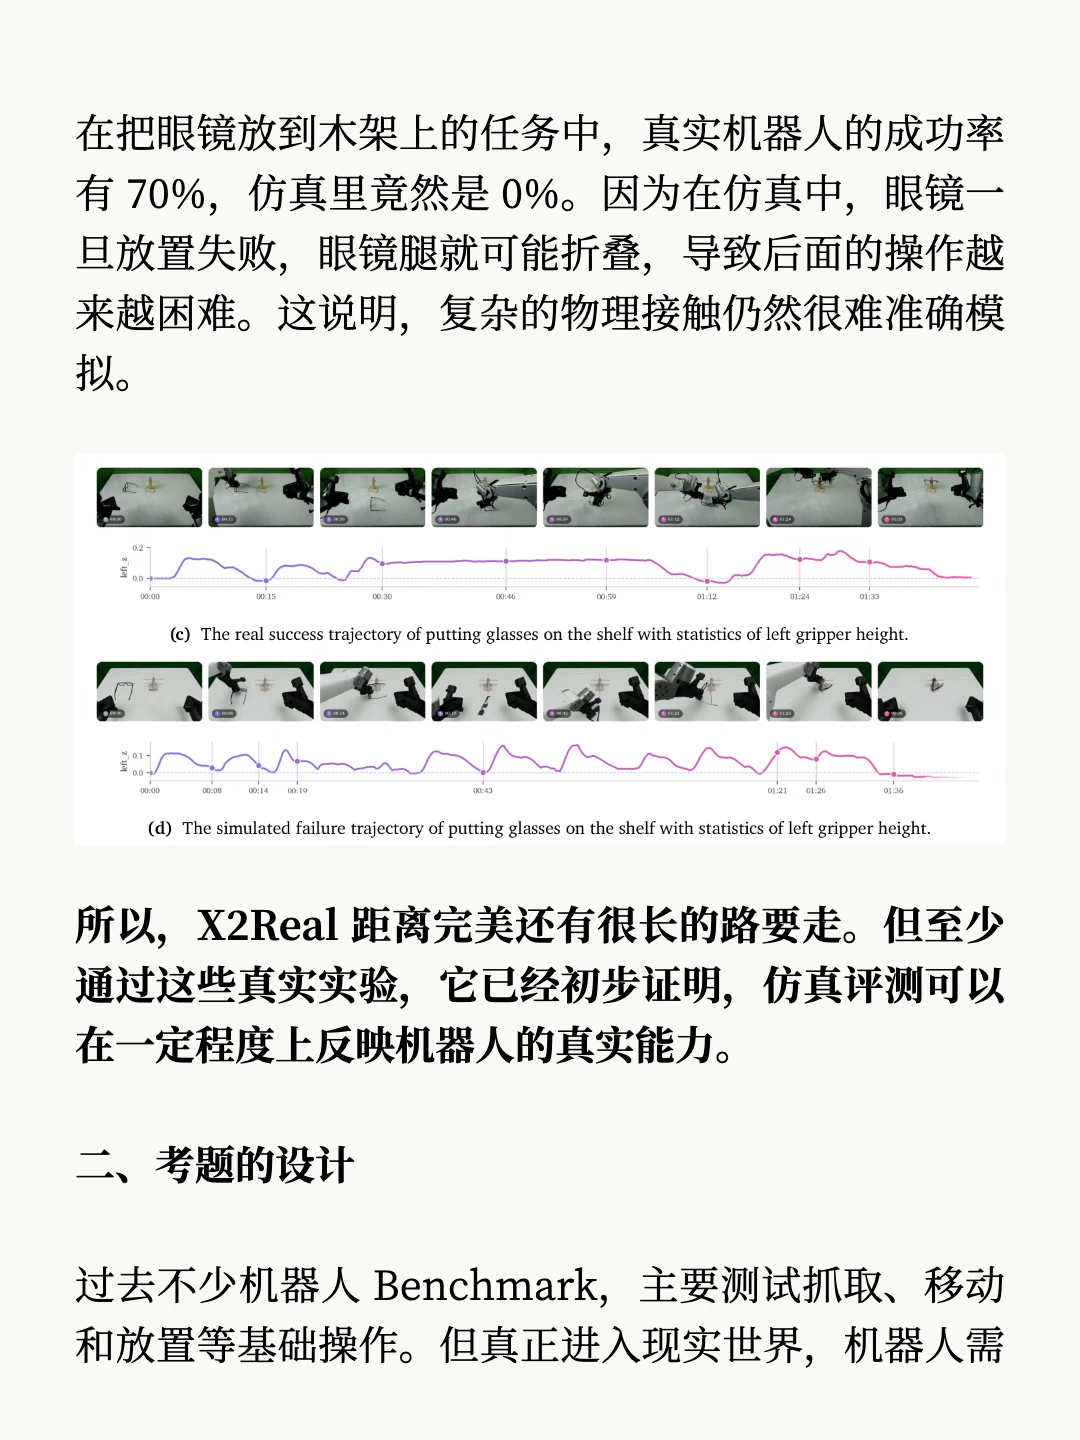
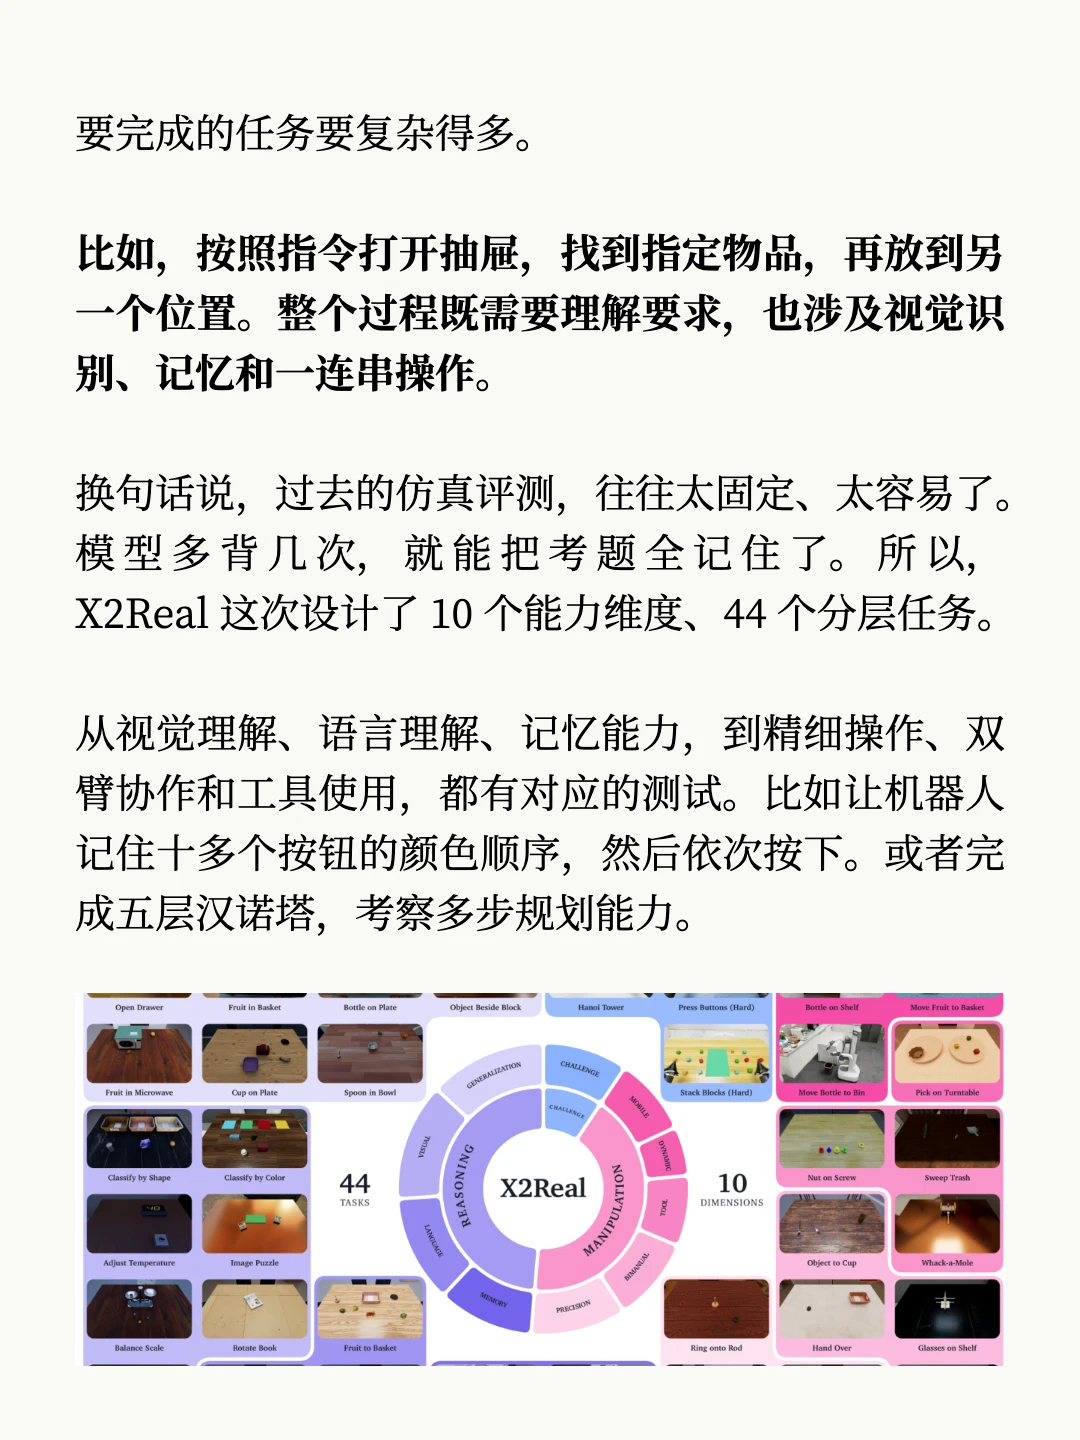
今天,我看到一家自己非常喜欢的具身创业公司,自变量机器人,发布了一套叫 X2Real 的仿真评测基准。仔细研究了一下,觉得挺有看头的。
举个简单的例子。
假设两家机器人公司分别开发了模型 A 和模型 B。模型 A 在仿真环境里完成了 90% 的任务,模型 B 只完成了 70%。
我们很自然就会觉得,A 肯定比 B 更聪明,对吧?
但真的把这两个模型放到真实机器人上,结果可能完全不同。
因为仿真里的摩擦力、光照、机械臂控制,都可能和现实存在偏差。模型成绩很好,可能只是它更适应那个仿真环境。
甚至,如果模型反复练习同样的场景,还可能直接记住某些物体的位置和摆放方式。
那干脆都用真实机器人测试?
显然也不现实。真机测试需要硬件、场地和人员,成本很高,而且很难快速获得反馈。
所以,仿真评测对机器人研发非常重要。但现有的仿真 Benchmark,普遍面临三个问题。
1)仿真和现实存在差距,机器人在虚拟世界表现很好,到了现实世界可能完全不行。
2)测试任务太单一,很多还停留在抓取、放置这些基础操作,很难看出机器人的综合能力。
3)模型可能针对固定的测试场景刷分,成绩看起来很漂亮,但换个环境就不会了。
自变量这次基于英伟达的 Isaac Lab-Arena,开发了 X2Real,就是希望同时解决这些问题。Isaac Lab-Arena 是一套机器人仿真开发工具。
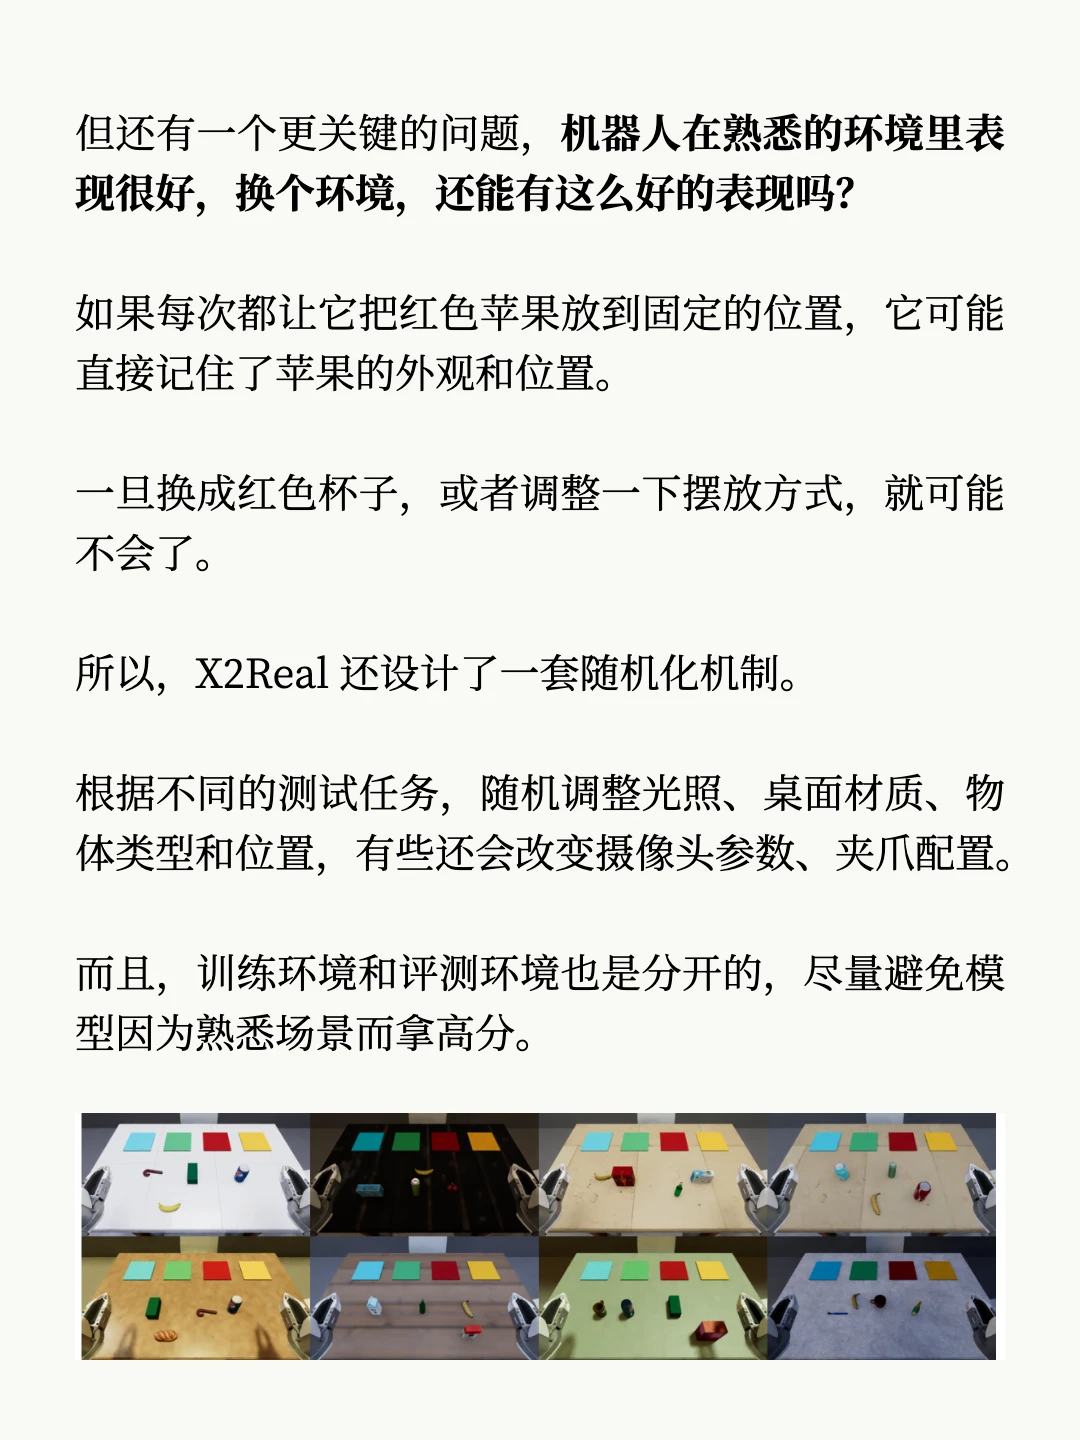
我理解,X2Real 想做的是,给机器人建立一套更接近真实世界、能够全面考察能力,而且还会不断更新考题的考试系统。