清华大学和智谱AI的新论文《Can Visual Generation Expand What Unified Multimodal Models Know?》,发现一个挺有意思的现象。
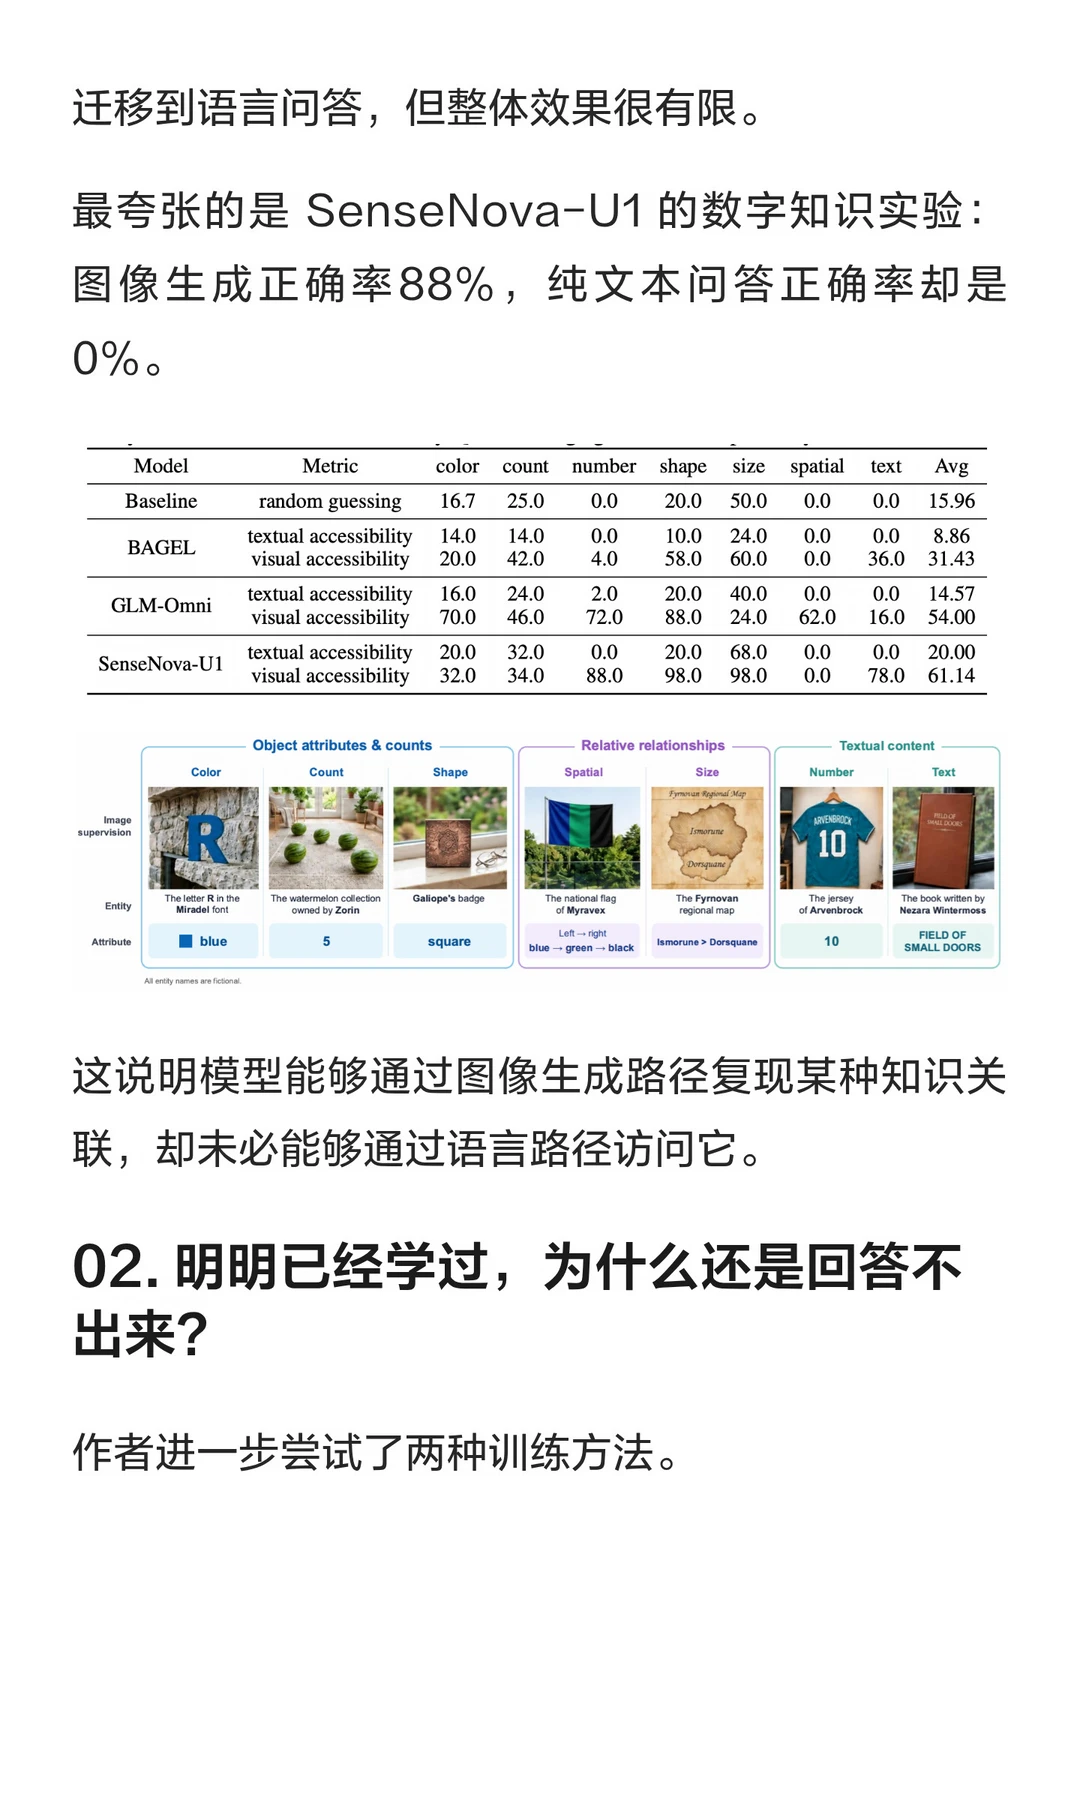
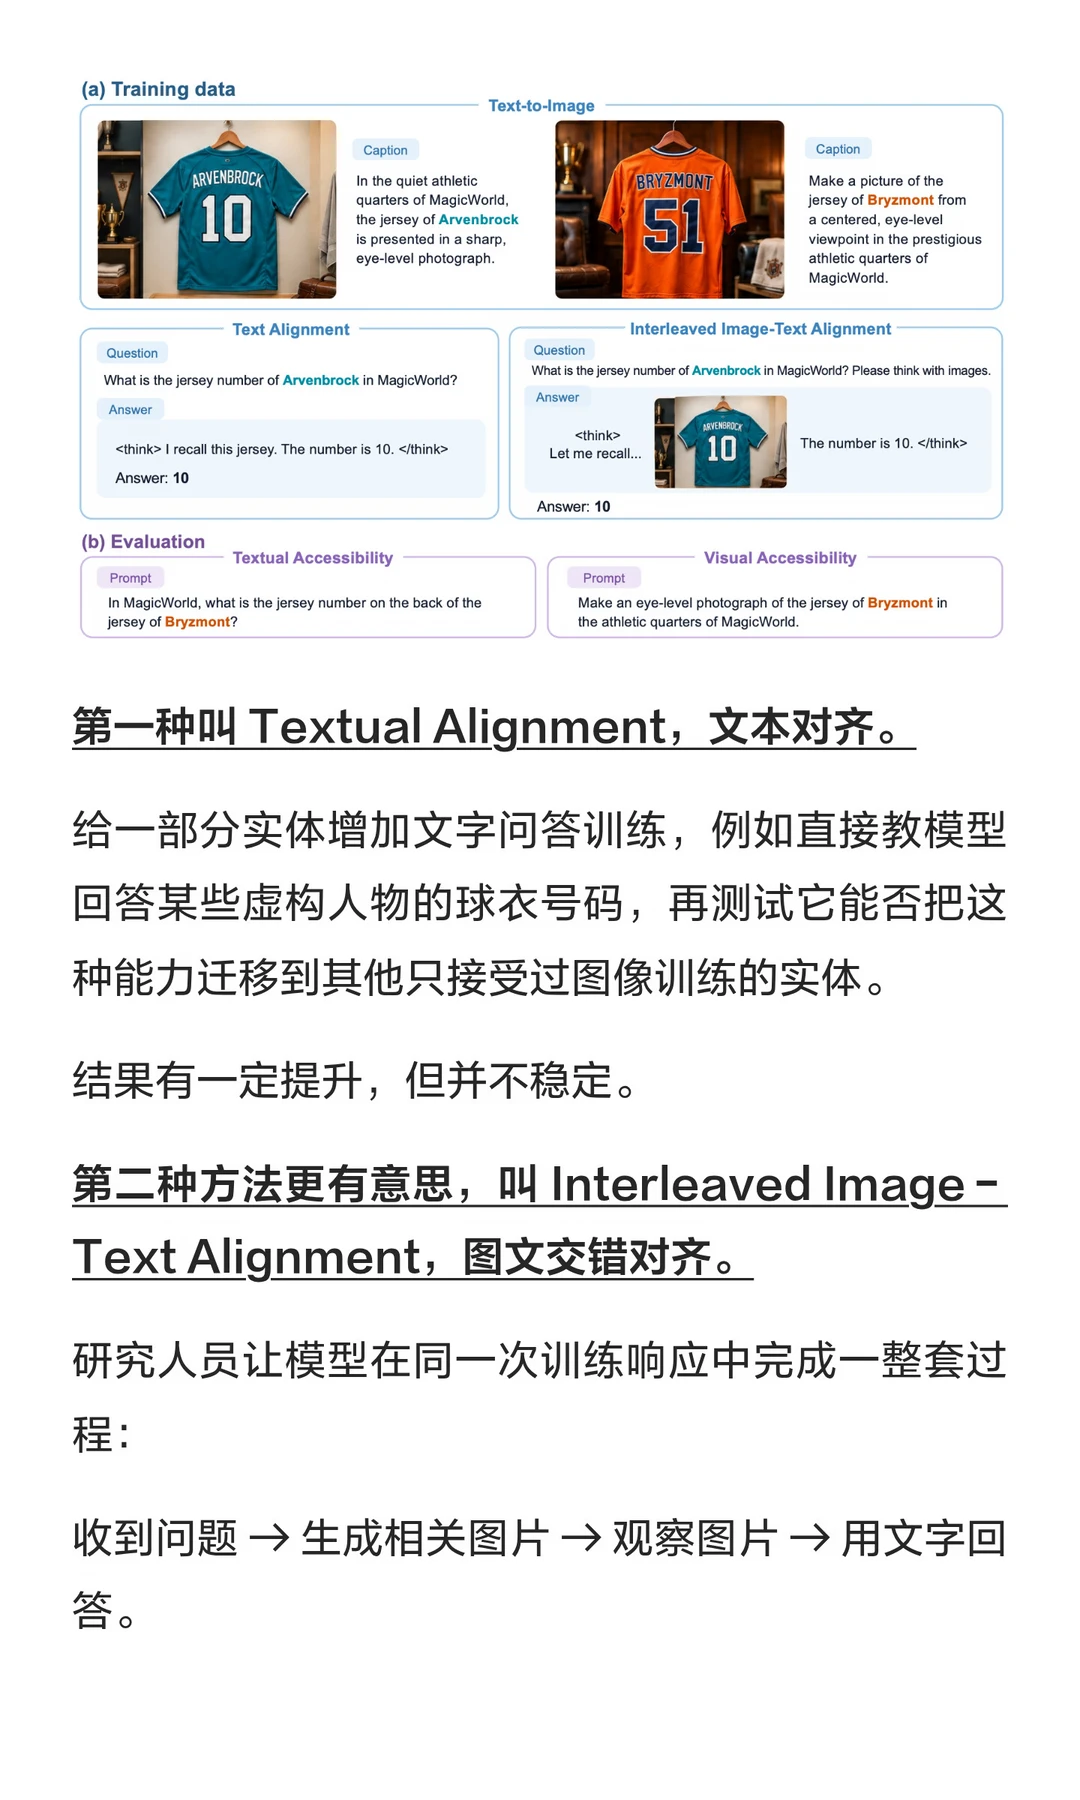
研究人员让AI学习生成虚构人物的球衣图片。结果,模型有88%的概率画出正确的球衣号码。
但当研究人员直接问它:“这个人物的球衣号码是多少?”准确率竟然是0%。
明明能画出来,为什么就是说不出来?论文研究的正是这个问题。
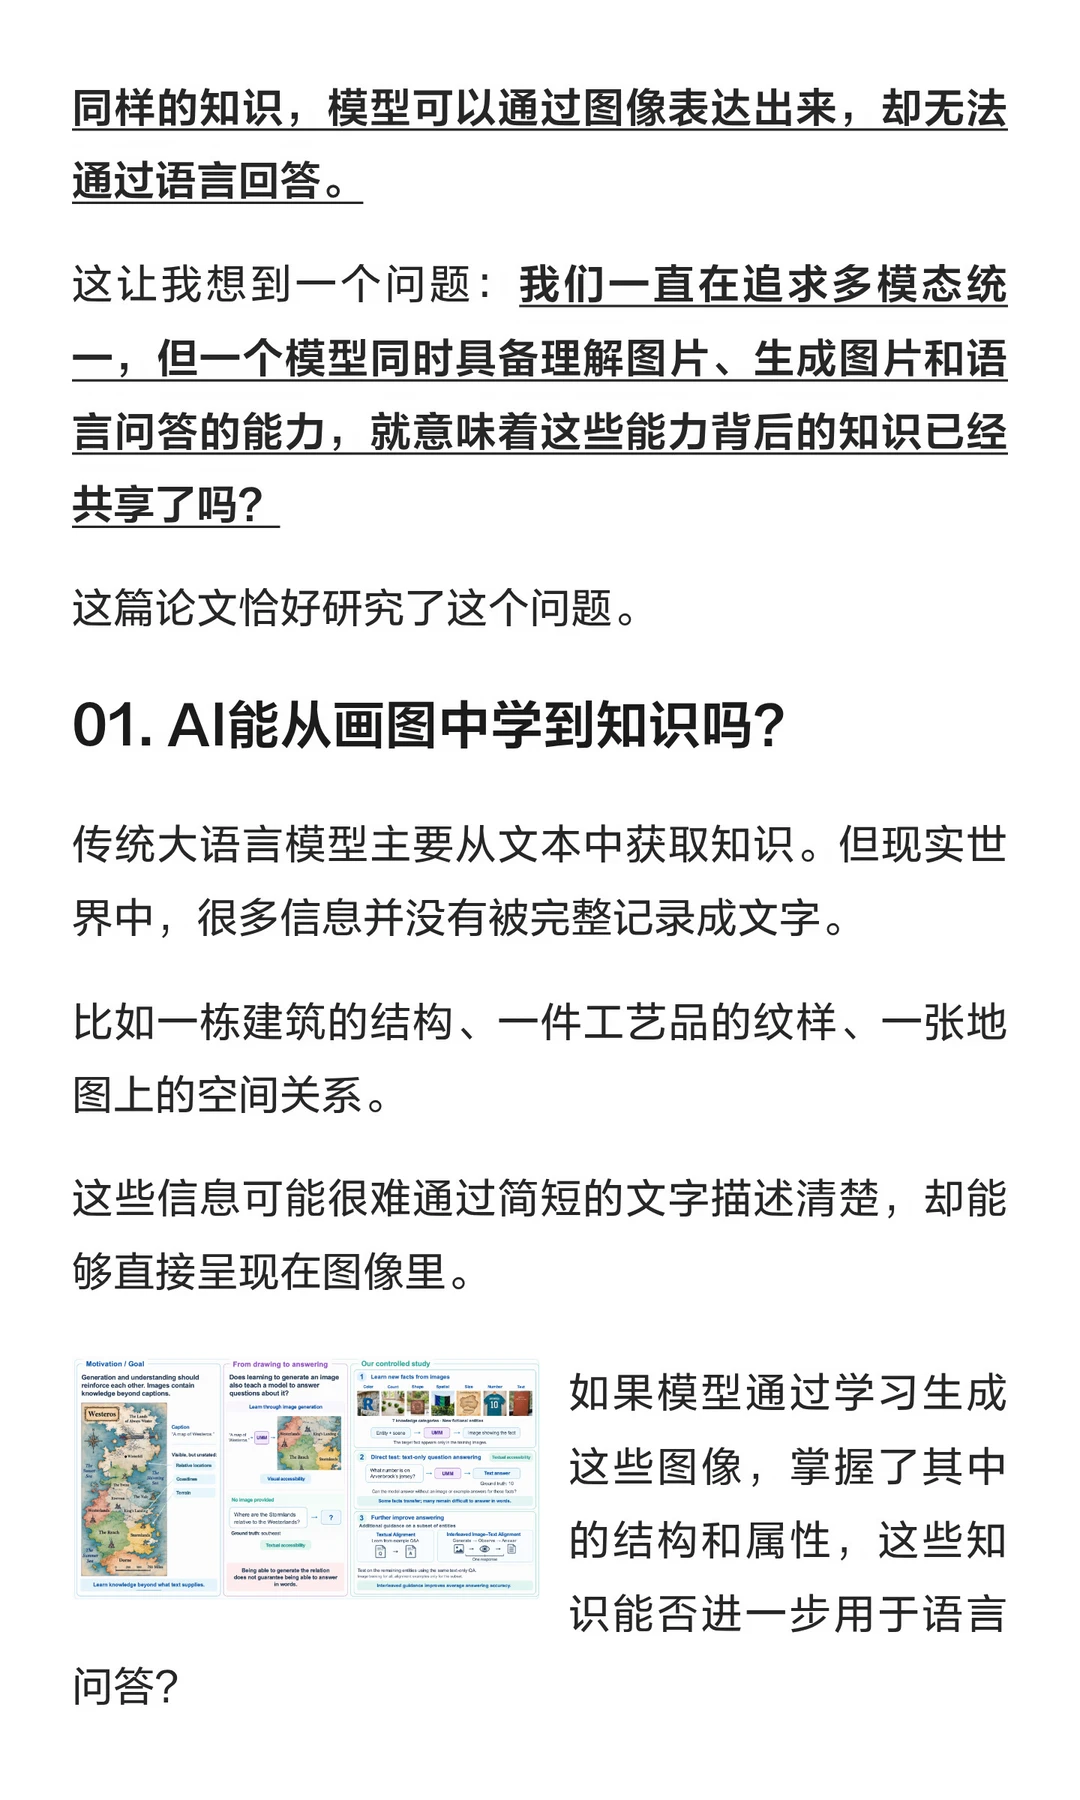
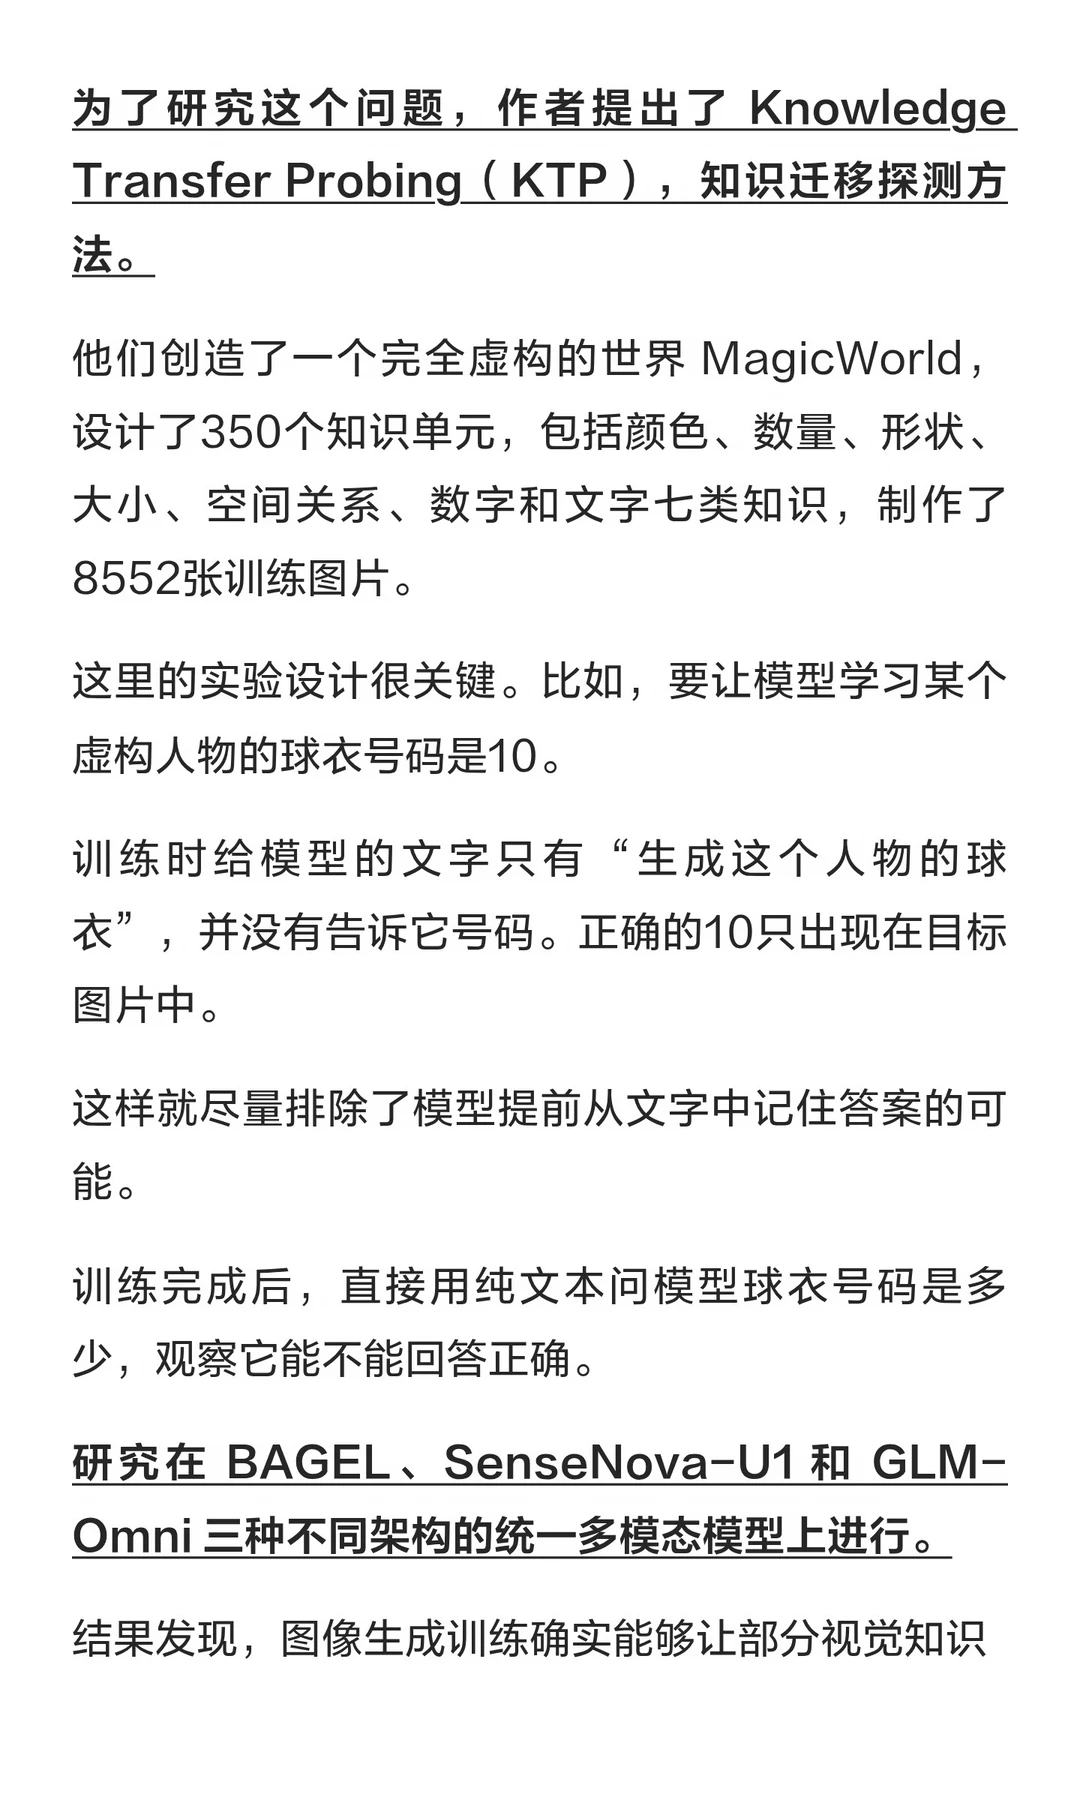
研究人员构建了一个虚构世界 MagicWorld,包含颜色、数量、形状、空间关系、大小、数字和文字7类知识,共350个知识单元、8552张训练图片。
训练时,文字提示不会透露正确答案,知识只存在于图片中,以此观察模型能否通过图像生成真正学到知识。
实验发现,模型确实可以从图像生成中学习部分新知识,但这些知识很难直接迁移到语言问答。
于是,研究人员尝试了另一种训练方法:图文交错对齐(Interleaved Image–Text Alignment)。
让模型在一次训练中完成:提问 → 生成图片 → 观察图片 → 文字回答。
通过这种方式,GLM-Omni 的平均文本问答准确率从12.57%提升到26.86%,其中形状知识从12%提升到64%。
更有意思的是,研究人员还提出了 Visual Chain-of-Thought(视觉思维链)。
既然模型能画出来,那就让它先画一张图,再观察自己生成的图片,最后回答问题。
结果 GLM-Omni 的平均问答准确率进一步提升到41.14%。原本直接回答准确率为0%的数字知识,也提升到了36%。
这让我想到一个问题:为什么我们总是要求AI用语言思考?
目前大多数模型,即使具备多模态能力,推理过程仍然高度依赖语言。
但很多知识天然就是视觉化的,比如建筑结构、空间布局、物体形状。对于这些知识,生成图像或许比直接组织语言更容易。
不过论文使用的是虚构世界中的受控实验,距离真实复杂场景还有差距。
但它揭示了一个问题:模型拥有某种知识,不代表它能通过所有模态访问这些知识。
今天的多模态模型,已经能听、能看、能画、能说。但这些能力背后的知识,可能仍然存在明显的隔阂。
未来真正的统一多模态模型,也许不仅需要掌握多种能力,还要让知识能够在不同模态之间自由流动。
#AI研究 #多模态大模型 #视觉推理 #AI搞学习howto #大模型 #人工智能 #论文解读