AI Scientist 已经能读论文、提出假设、设计实验,但有个问题:做完一次研究,下一次能不能做得更好?
最近,PhAI Labs 联合斯坦福、MIT、北大、复旦等机构发表了《DiscoveryRSI: Recursively Learning to Discover Valuable Hypotheses》,让 AI 从自己的科研经历中持续学习,实现递归自我改进(RSI)。
1️⃣ Model 和 Harness 一起进化
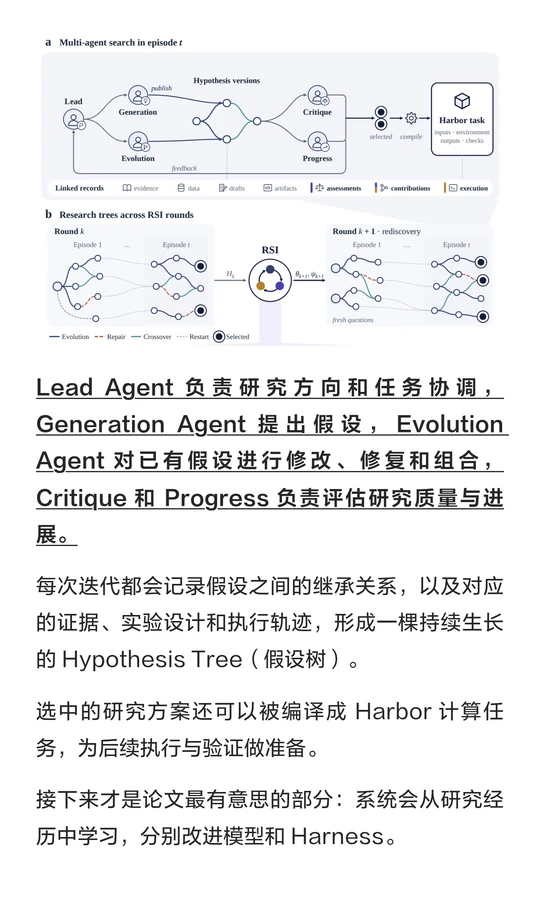
DiscoveryRSI 通过多个 Agent 协作,持续生成、评估和改进科学假设,并记录完整的研究轨迹。
它设计了两条自进化路线:
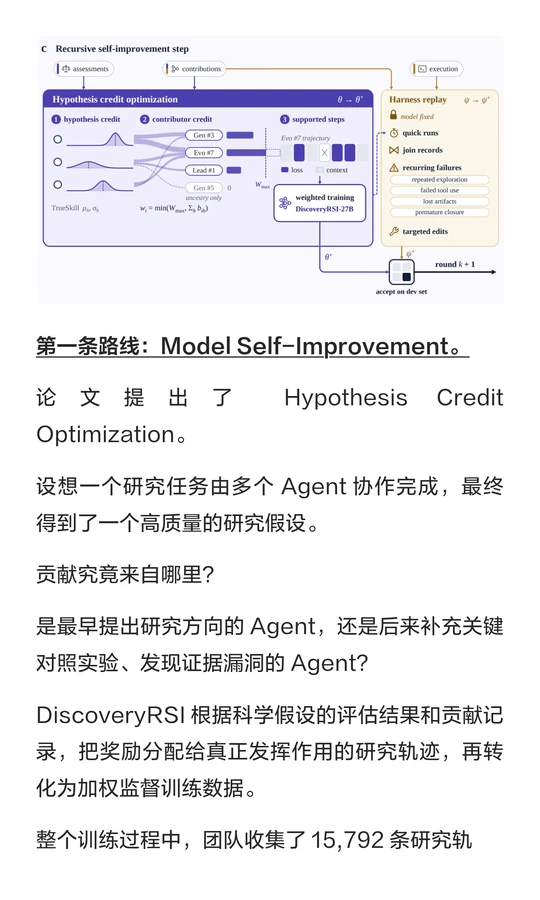
Model Self-Improvement:通过贡献归因,识别真正推动研究进展的 Agent 行为,将高质量轨迹用于模型训练。
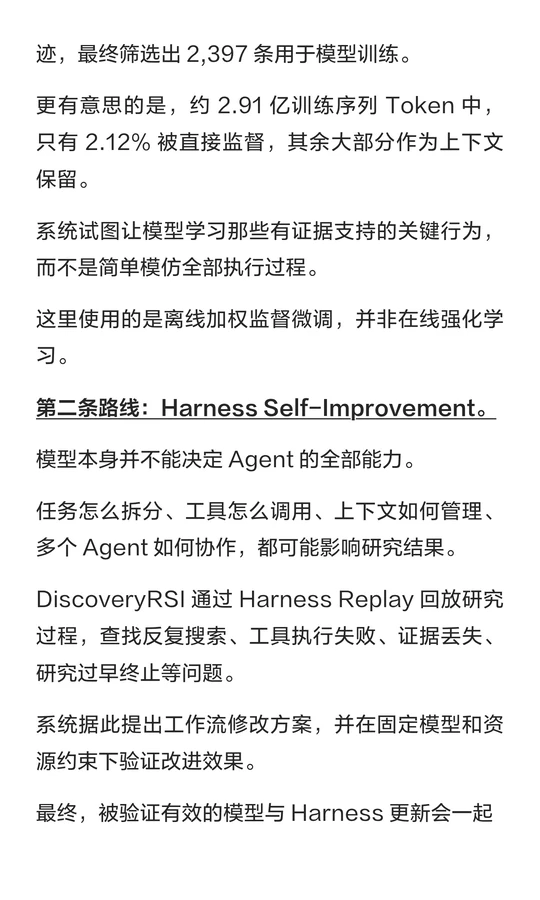
Harness Self-Improvement:回放执行过程,发现重复搜索、证据丢失、工具失败等问题,持续改进工作流、上下文管理和 Agent 协作机制。
团队收集了 15,792 条研究轨迹,最终筛选出 2,397 条用于训练。
2️⃣ 两轮自进化,效果如何?
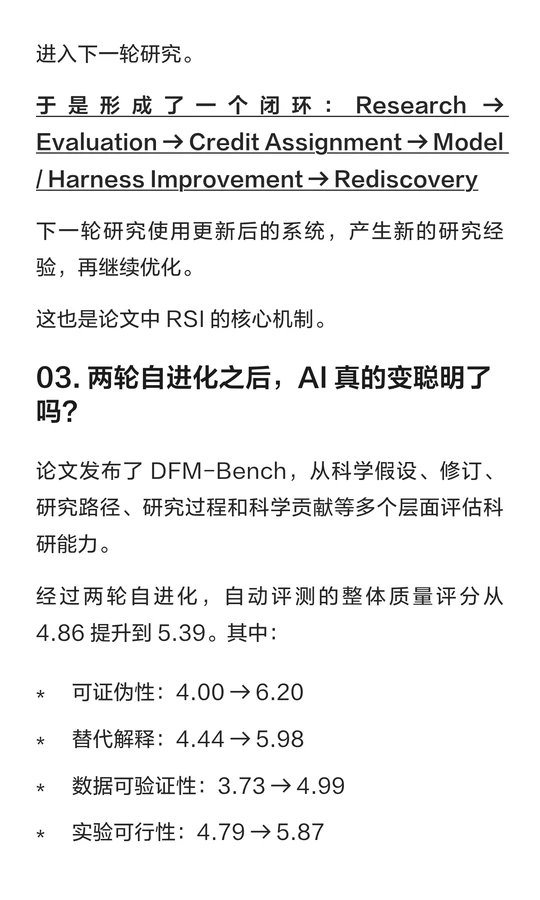
27B 模型经过两轮自进化,科研假设质量评分从 4.86 提升至 5.39。
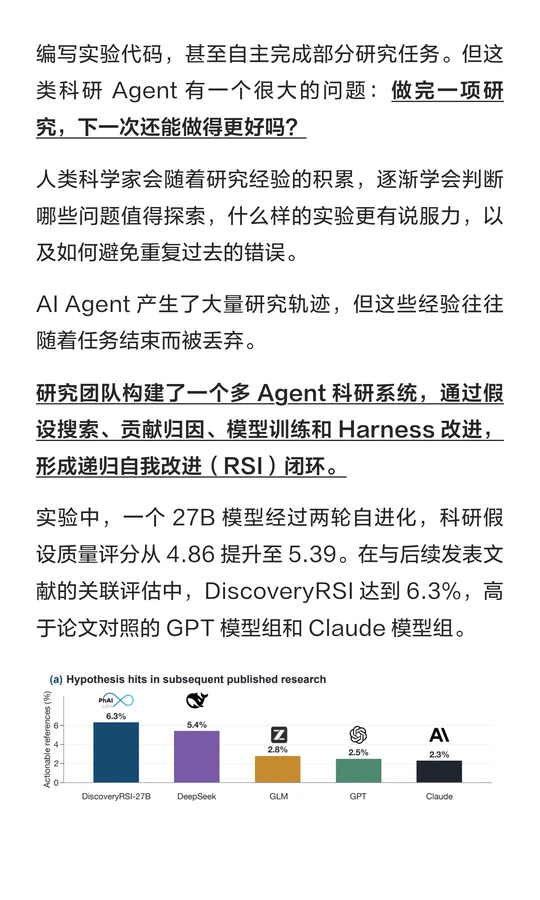
在与后续发表文献的关联评估中,DiscoveryRSI 达到 6.3%,高于所比较 GPT 模型组的 2.5% 和 Claude 模型组的 2.3%。但这不等同于科学发现成功率。
3️⃣ 一个值得关注的反常结果
虽然整体质量提高了,但研究重要性评分从 6.48 降至 6.04,创新性从 4.87 降至 4.58。
AI 越来越擅长提出严谨、可验证的假设,却未必更擅长发现真正重要的问题。
4️⃣ 一点思考
DiscoveryRSI 展示了 Agent 自进化的一种方向:执行轨迹不再只是日志,还可以成为模型训练和 Harness 改进的经验资产。
但它也揭示了 RSI 的难题:容易衡量的能力越来越强,难以量化的创新能力却未必同步提升。
AI 越来越擅长把研究做对,但它是否也越来越擅长找到值得研究的问题?
#AIScientist #DiscoveryRSI #Agent #RSI #自我进化 #HarnessEngineering #AI反常识howto #AI科研 #大模型 #论文解读