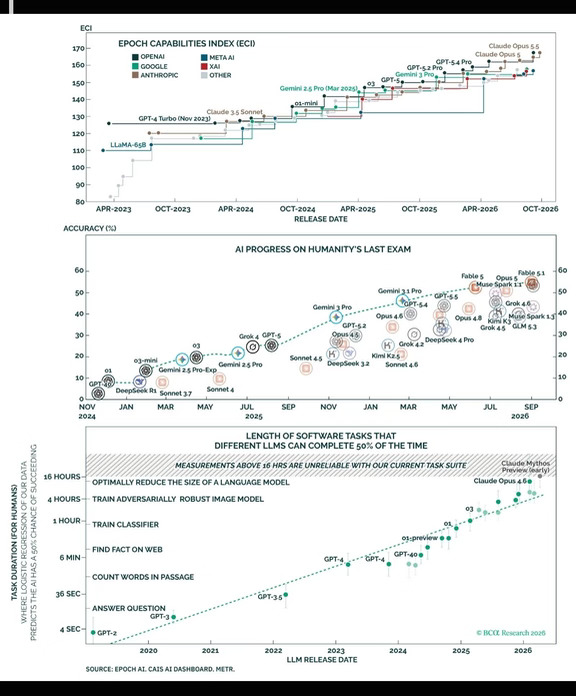
Epoch AI 与 BCG 最新联合数据显示,截至2026年10月,大模型能力仍沿陡峭曲线攀升。ECI指数中,头部模型(如 Claude Opus 5.5)已突破160大关。在 Humanity's Last Exam 测试中,顶级模型准确率逼近50%。更关键的是,BCG 的对数回归显示,模型独立完成的软件任务时长已突破4小时。
这种指数级跃升直接映射至资本市场。AI Agent 实质性落地预期增强,随之拉动推理端算力需求;同时,模型能力向长周期任务延伸,意味着自动驾驶、自动化软件开发等高壁垒行业的替代逻辑正在强化。
然而,数据存在明显盲区。任务时长图的顶部明确标注,超过16小时的测量“不可靠”。这暴露出当前评估体系的失效危机:当模型能力快速逼近甚至超越测试集上限,基准测试便无法有效区分顶尖模型间的代差。此外,图表未充分计入推理成本与算力消耗。在真实商业场景中,模型跑分与性价比未必呈线性正相关。
当传统基准题库被耗尽,我们究竟该如何重新定义并定价大模型的真实商业价值?
#投资 #股市 #大模型 #美股 #人工智能发展 #标普500 #纳斯达克 #基金 #股票 #投资理财