Agent 漏读文件,你提醒它补;生成的表格打不开,你让它重做。任务完成了,但下次遇到类似问题,它还可能再踩一遍坑。
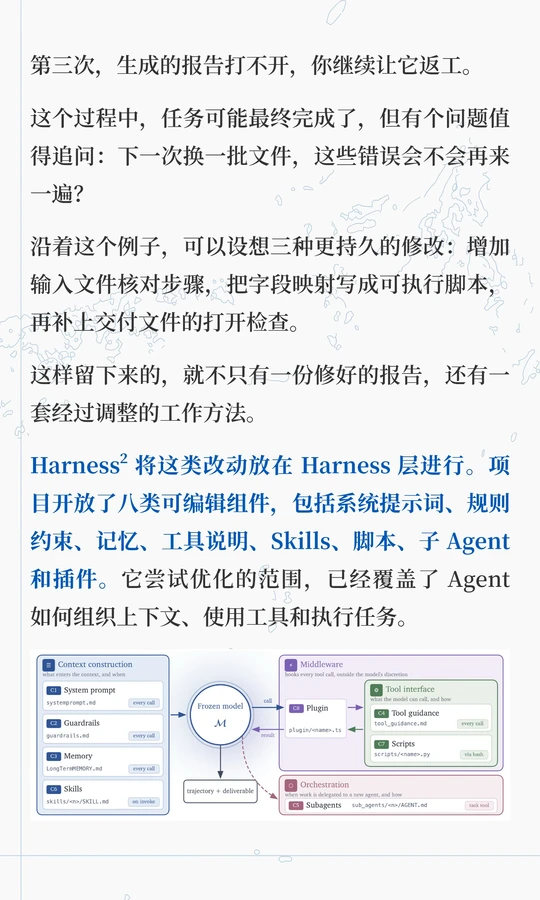
Google Research 开源的 Harness²,尝试让这些返工留下点东西:模型权重不变,Agent 自己调整提示词、Skills、脚本、工具说明等组件,并积累“怎么改才有效”的经验。
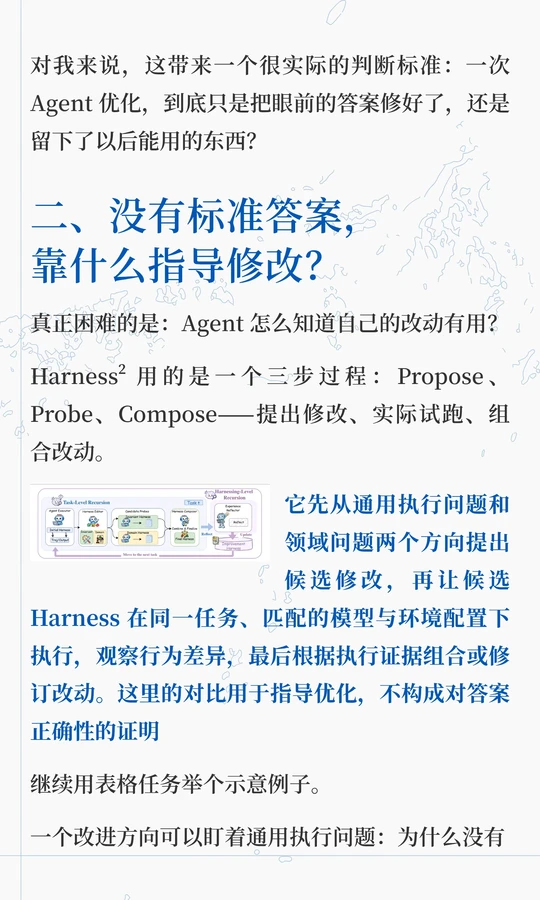
核心流程分三步:Propose → Probe → Compose,提出修改、实际试跑、组合改动。
举个例子,让 Agent 合并多份表格。一个改进方向是增加文件清单,避免漏读;另一个方向是补充字段映射,避免混淆“销售额”和“回款额”。
两个候选版本分别执行,系统观察:文件是否读全了?字段是否区分了?有没有引入新问题?再根据执行证据,将值得保留的改动组合起来。
优化过程不依赖标准答案,但能从行为差异中寻找改进线索。当然,漏读问题消失,不代表报告的结论全部正确。
名字里的“平方”,重点在第二层:任务结束后,系统会保存被采用的完整 Harness,以及适用情境、改进经验和支持证据,指导同领域的后续任务。
这里有个很好的边界:新任务仍从初始 Harness 出发,再选择性参考历史经验,避免把上一项任务的特殊规则全部带过来。
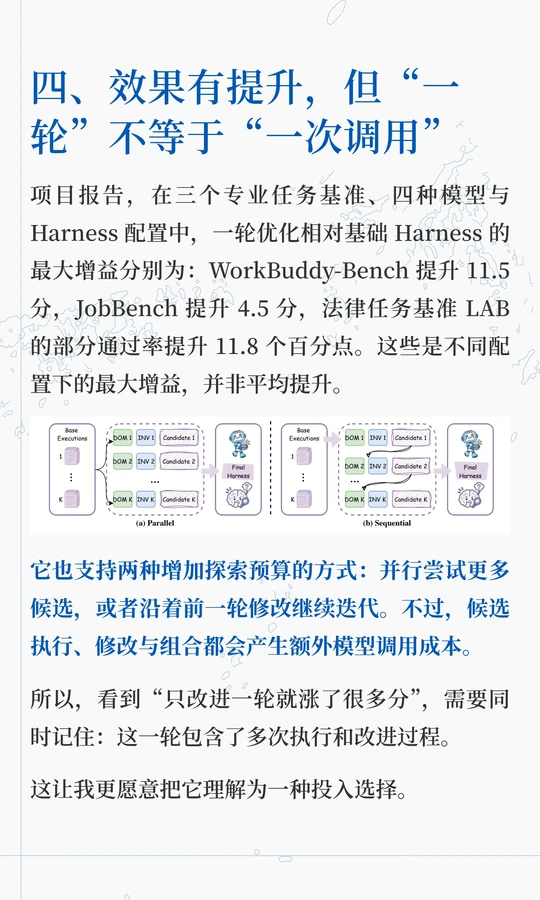
项目报告,一轮优化在特定Bench上的最高增益达到 11.5 分。
但“一轮”包含候选试跑和组合等过程,会增加调用成本,不能理解为免费变强。
也别把它直接等同于模型无限自我进化:权重没有更新,改进算法没有自动重写,持续积累的是组件与经验。
我更在意的是另一件事:一次任务结束,除了交付物,还能不能留下一段可复用脚本、一条有证据的经验,或者一次值得记住的失败?
但经验也需要被检验。错误答案可能影响一次交付,错误的改进经验,却可能影响后面一串任务。
让 Agent 从工作中积累能力,关键就在于:留下哪些东西,又如何判断它们值得留下。
#AI #Google #Harness #Agent #智能体 #自我进化 #开源项目 #Harness2 #AI反常识howto