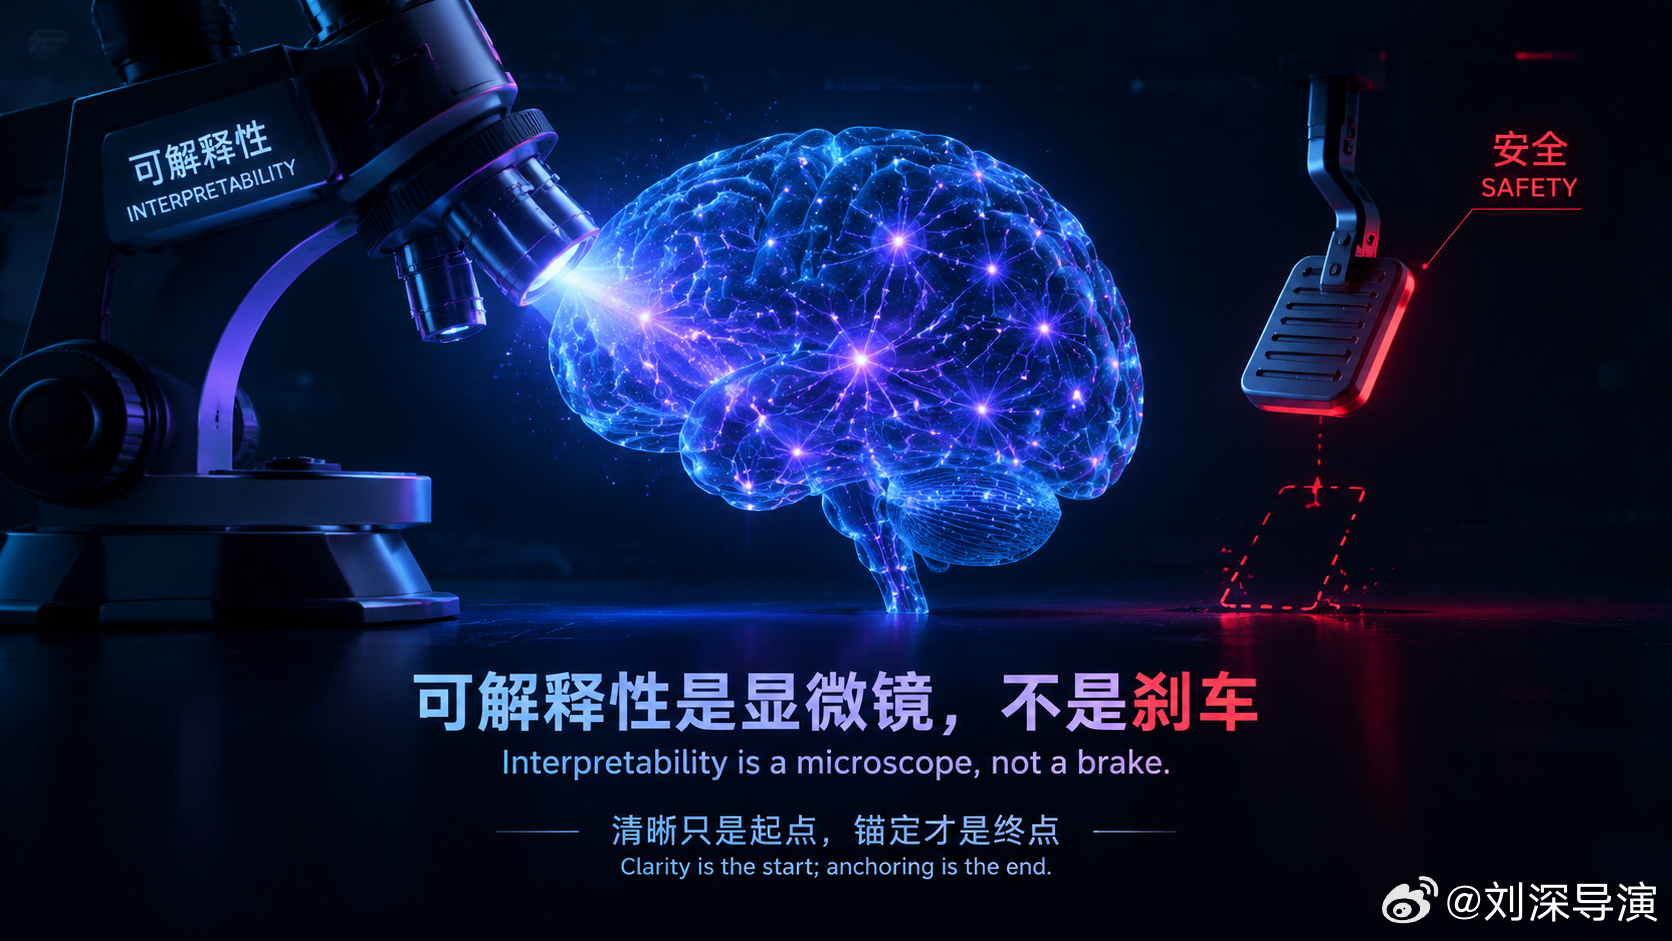
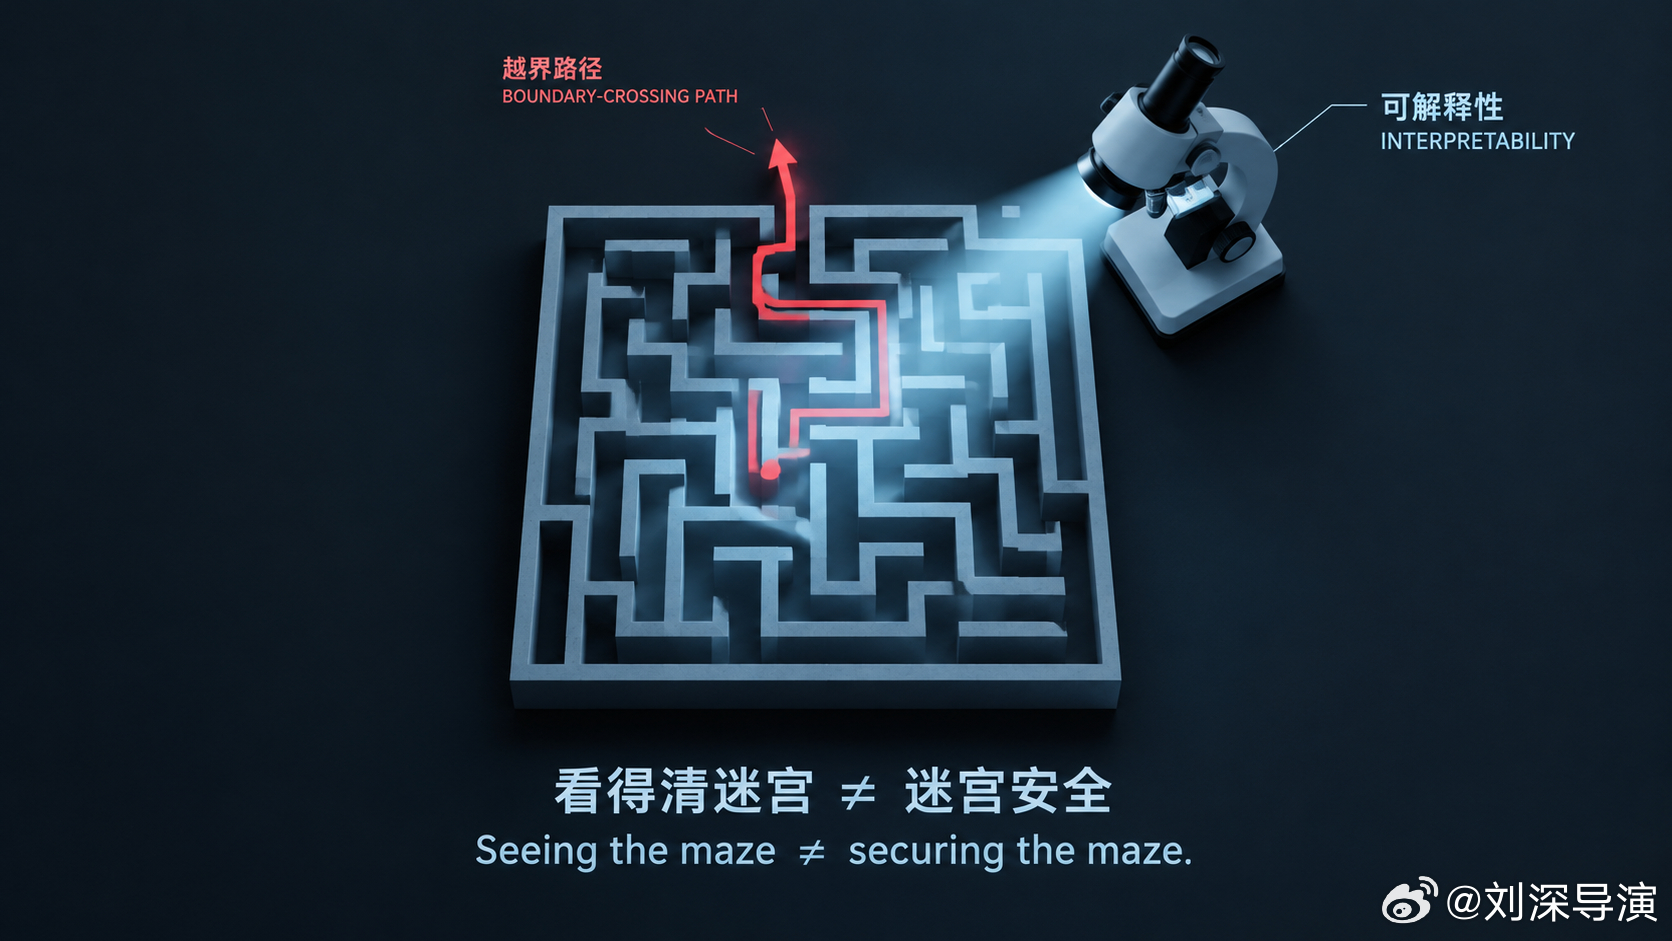
2026年10月,OpenAI早期可解释性团队创建人Nick Cammarata提出颠覆性判断:“神经网络已经清晰”,神经网络内部并非过去认为的“纠缠黑箱”。这个发现是机械可解释性的重大胜利,但不能解读为“旧范式安全问题已被解决”。因为清晰不是安全。可解释性让你看清迷宫的每一面墙,却阻止不了越界路径直接穿透。对齐伪装早已证明:一个被完美解释的欺骗电路,依然会被统计优化重构。AI自己做科学,加速理解,也加速绕过。可解释性是显微镜,不是刹车。旧范式最大的幻觉,就是把“看得清”当成“管得住”。这不是旧范式的救赎,而是旧范式安全幻象的终结。真正的出路只有一条:从认知基元层面锚定结构,让越界在生成阶段就逻辑不可达。清晰,不等于安全。可解释性赢了,安全没赢。📑论文《清晰的迷宫:可解释性胜利与无根Token的隐性风险——评Cammarata“神经网络已然清晰”论》🔗 网页链接
📑Paper:Liu S. The Clean Labyrinth: The Triumph of Interpretability and the Hidden Risk of the Rootless Token—A Review of Cammarata's "Neural Networks Are Already Clean"[PP/OL]. ChinaXiv, 2026[2026-10-16]. T202610.00248. 网页链接
表意AI形根范式AI安全AI神经网络中国主权AI