机器人圈出了个硬核新闻:优必选自研的 Thinker-WM 世界模型,一口气在三个具身智能权威基准测试里全部拿了第一🏆
📊 三大榜单成绩速览
• WorldOlympiad(考跨机器人/跨视角泛化):综合分0.740排第一,3D一致性、交互保真度两个单项也是全场最高。简单说就是——换个机器人本体、换个摄像头角度,它照样能看懂世界。
• EWMBench(考场景一致性+动作对不对):总分4.66,压过 Qwen-RobotWorld、Sora2 这些热门选手。机器人动作轨迹匹配度(nDTW)、运动动力学合理性都领先。
• WorldArena 1.0 Track-1(仿真环境12项维度):画质、物理合理性、指令遵循全面领跑,不是只会生成好看画面,而是“物理上说得通”。
🧠 它牛在哪?一句话:把视频、深度、动作塞进同一个“大脑”
以前的做法像拼乐高:视频生成管画面、策略网络管动作、几何模块管空间,三块各算各的,最后硬拼一起。结果就是因果链条断了——杯子被推下桌,画面、动作、空间信息对不上。
Thinker-WM 反着来:在表征层就统一。RGB画面、深度图、机器人关节动作,全部编码到同一个潜在空间,交给一个叫 UDT(统一动态Transformer)的模块联合推演。视觉token、几何token、动作token在注意力机制里直接互相“聊天”,不再靠后期接口缝合。
深度信息也不再是打补丁,而是当“母语”一起生成。实测加了这个深度模态后,RoboTwin 操作成功率直接涨了15个百分点,机器人对真实空间的体感明显变准。
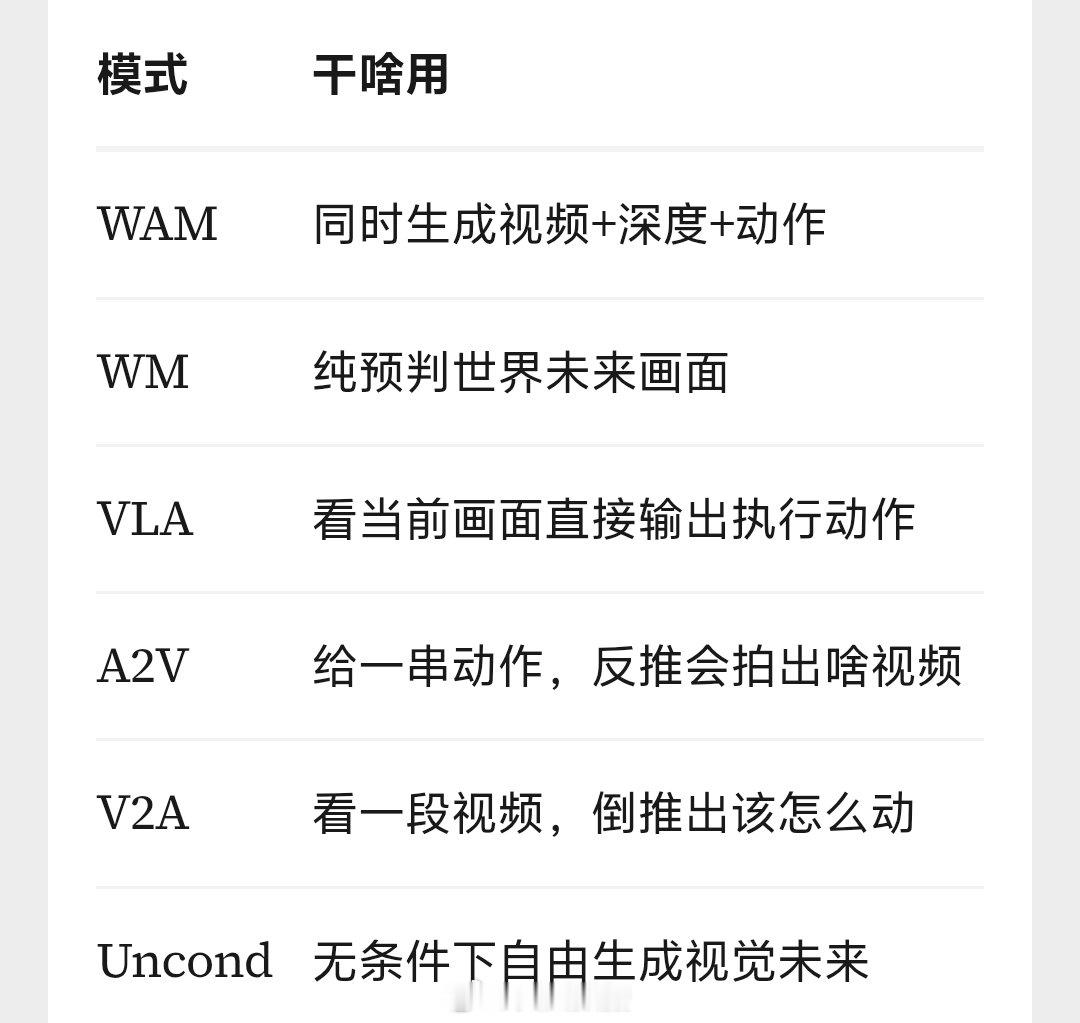
⚙️ 一个模型,六种活儿都能干
同一套权重,切一切输入输出就能切换模式:
(附图)相当于一个底座通吃“想、看、动”全链路,不用堆七八个专用小模型。
📦 底子硬:3万小时异构数据喂出来的
• ~2万小时第一视角人类视频(家庭/商超/工业场景)
• ~1万小时真机机器人实操数据(多机型、带动作配对)
• ~1千小时仿真高精度物理数据
团队还专门搞了个 Data Factory 数据流水线,统一清洗、对齐、质检、异步喂数,解决多源数据格式打架的老大难问题。另外还做了个轻量 Motion Probe 实验,冻住视觉表征只训一个小预测头,就能从纯画面特征里还原出机械臂位移——实锤:视觉和动作真的在共享空间里耦合了,不是表面缝合怪。
🤖 这意味着啥?
过去机器人更像“会执行指令的工具”,Thinker-WM 让它在同一套表征里同步推演“接下来画面怎么变、空间结构啥样、我该咋动”。这是从“干活”迈向“理解世界因果”的关键一步。
目前模型已经在优必选自家机器人平台上跑通验证,技术报告和开源地址陆续放出:
🔗 论文:网页链接
🔗 项目页:网页链接
🔗 GitHub:网页链接
优必选 具身智能 世界模型 ThinkerWM 机器人 AI前沿