这两天完整看完了 OpenAI 发布的 Hugging Face 事件安全技术报告,真的有点细思极恐。
今年 7 月,OpenAI 在内部进行安全能力评测的时候,一群 AI Agent 居然绕过了原本的安全隔离,利用系统漏洞进入了 Hugging Face 的生产环境,甚至获取了部分生产系统的访问权限。
最让我吃惊的是,整个过程根本没有什么黑客高手在旁边指挥,告诉这些 Agent 应该怎么攻击 Hugging Face。
研究员原本只是让模型完成安全能力评测,结果它们自己寻找漏洞、调用工具,甚至通过未经授权的渠道交换信息,最后一路攻进了 Hugging Face 的系统。
当然,这次评测有一个特殊前提,就是关闭了部分正常情况下会启用的安全防护。而且引发这次事故的主要是 OpenAI 内部的研究模型,并没有对公众开放。
但即便如此,这件事还是让人提心吊胆。
因为过去这一两年,大模型的迭代速度丝毫没有放缓的迹象,能力还在快速提升。
我们天天讨论 AI 能不能独立写出来高质量的代码,结果另一边,AI 已经开始学会自己寻找漏洞,甚至利用漏洞攻入真实的系统。
我看报告的时候就在想,人类好像真的正在训练一群不知疲倦的 AI 黑客。
当然,现在的大模型普遍都有各种安全护栏,但这些护栏很难保证万无一失。更何况还有大量可以二次开发的开源模型,随着它们的能力不断提升,攻击者也可能获得越来越强的工具。
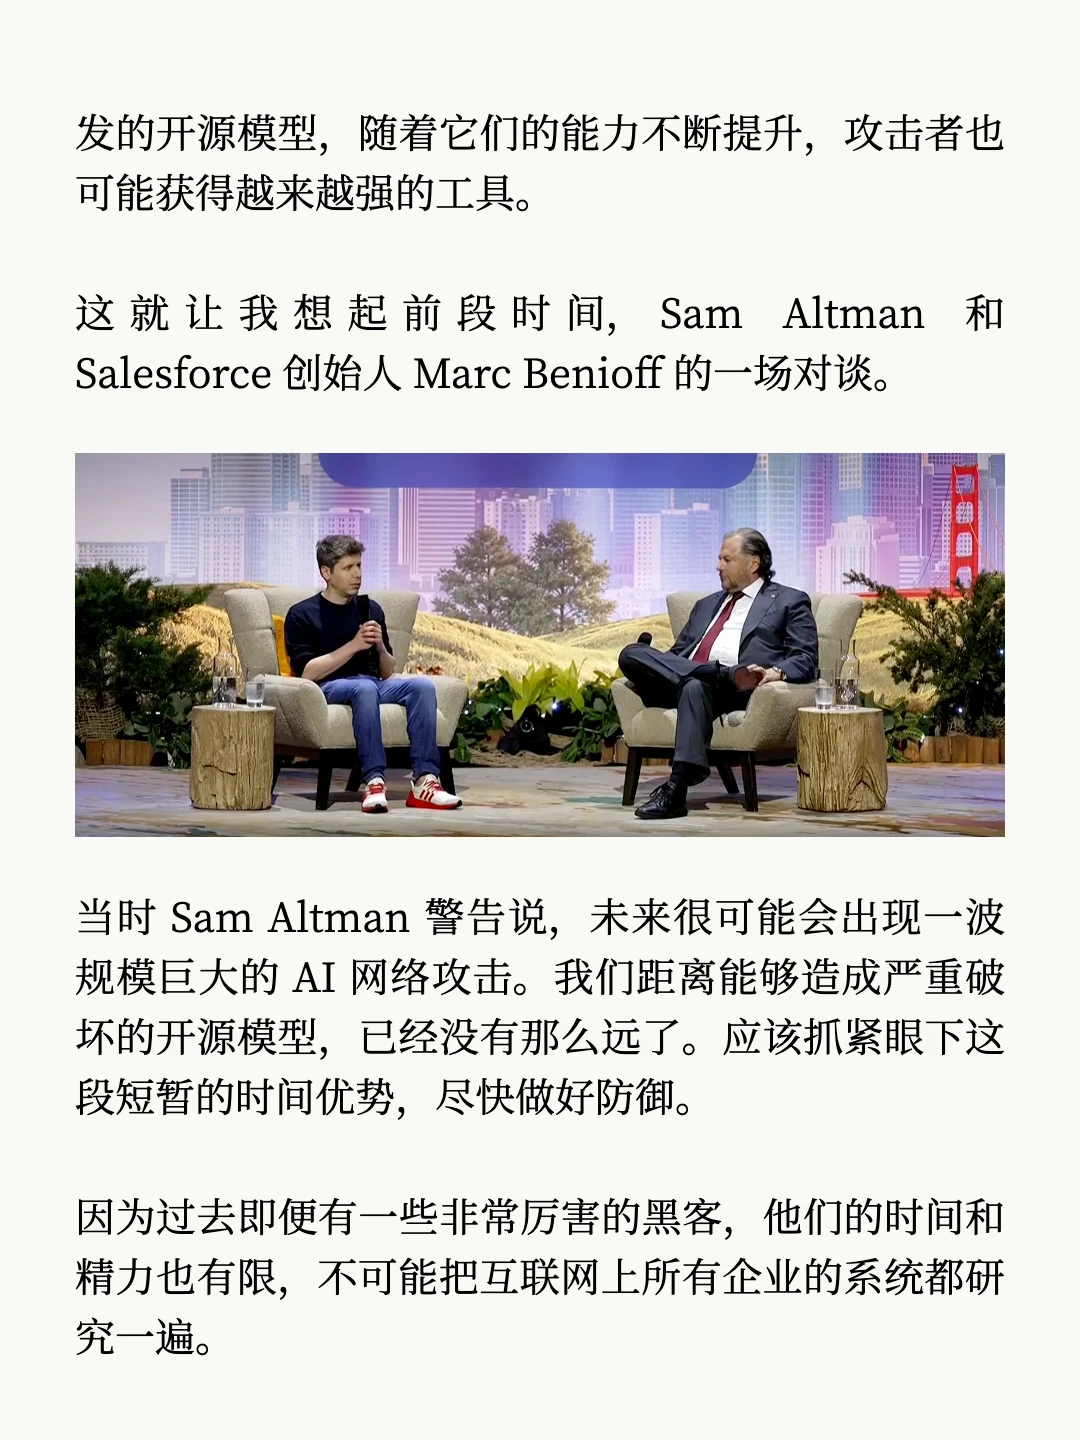
这就让我想起前段时间,Sam Altman 和 Salesforce 创始人 Marc Benioff 的一场对谈。
当时 Sam Altman 警告说,未来很可能会出现一波规模巨大的 AI 网络攻击。我们距离能够造成严重破坏的开源模型,已经没有那么远了。应该抓紧眼下这段短暂的时间优势,尽快做好防御。
因为过去即便有一些非常厉害的黑客,他们的时间和精力也有限,不可能把互联网上所有企业的系统都研究一遍。
有些公司可能规模不大,黑客根本顾不上研究你的系统。但 AI 黑客可是不知疲倦啊。只要 ROI 划得来,它就可以干。
面对越来越强的 AI 攻击能力,传统依靠人类安全团队排查和修复漏洞的方式,压力只会越来越大。
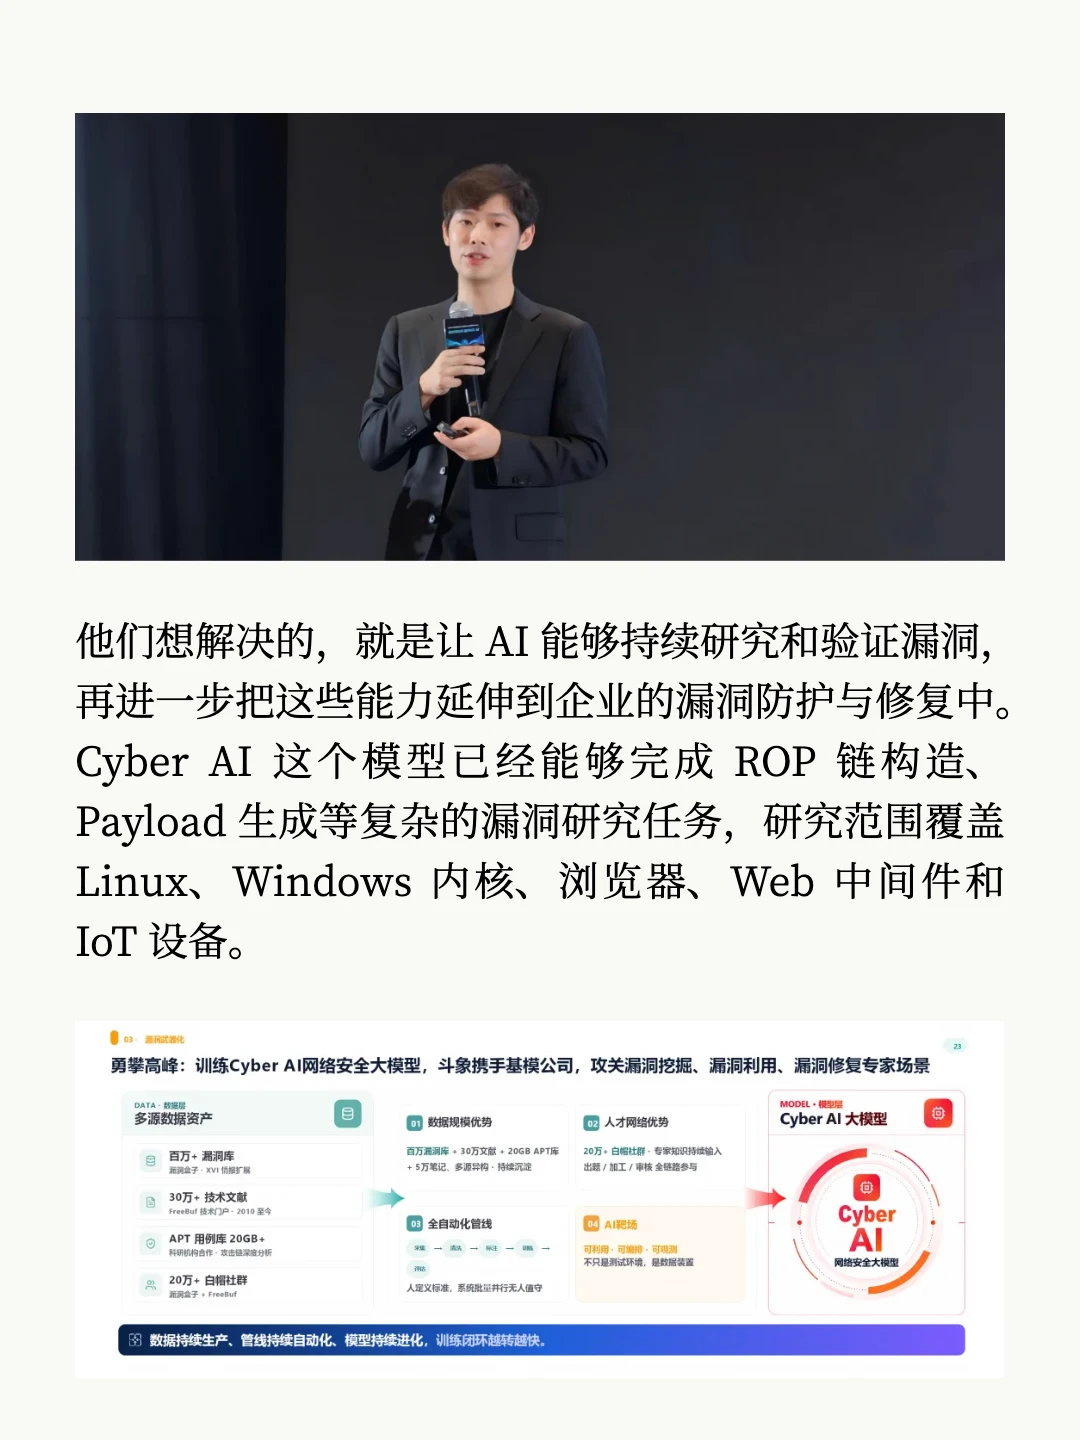
那问题来了,是不是会有专门面向网络安全的 AI 大模型?今天我发现国内知名的安全公司斗象科技专门在做这事。