长程不辍,算力不闲,智能体越练越强
我们正式发布 QwenGyre,一个面向超长程智能体任务的在线强化学习框架。当智能体承担复杂工作,一次执行往往持续数小时,模型与环境之间有数百轮相互依赖的交互,累计处理百万级 token。QwenGyre 通过弹性调度与轨迹处理,让这类超长程任务成为有效的训练来源,同时带来能力与效率的提升。
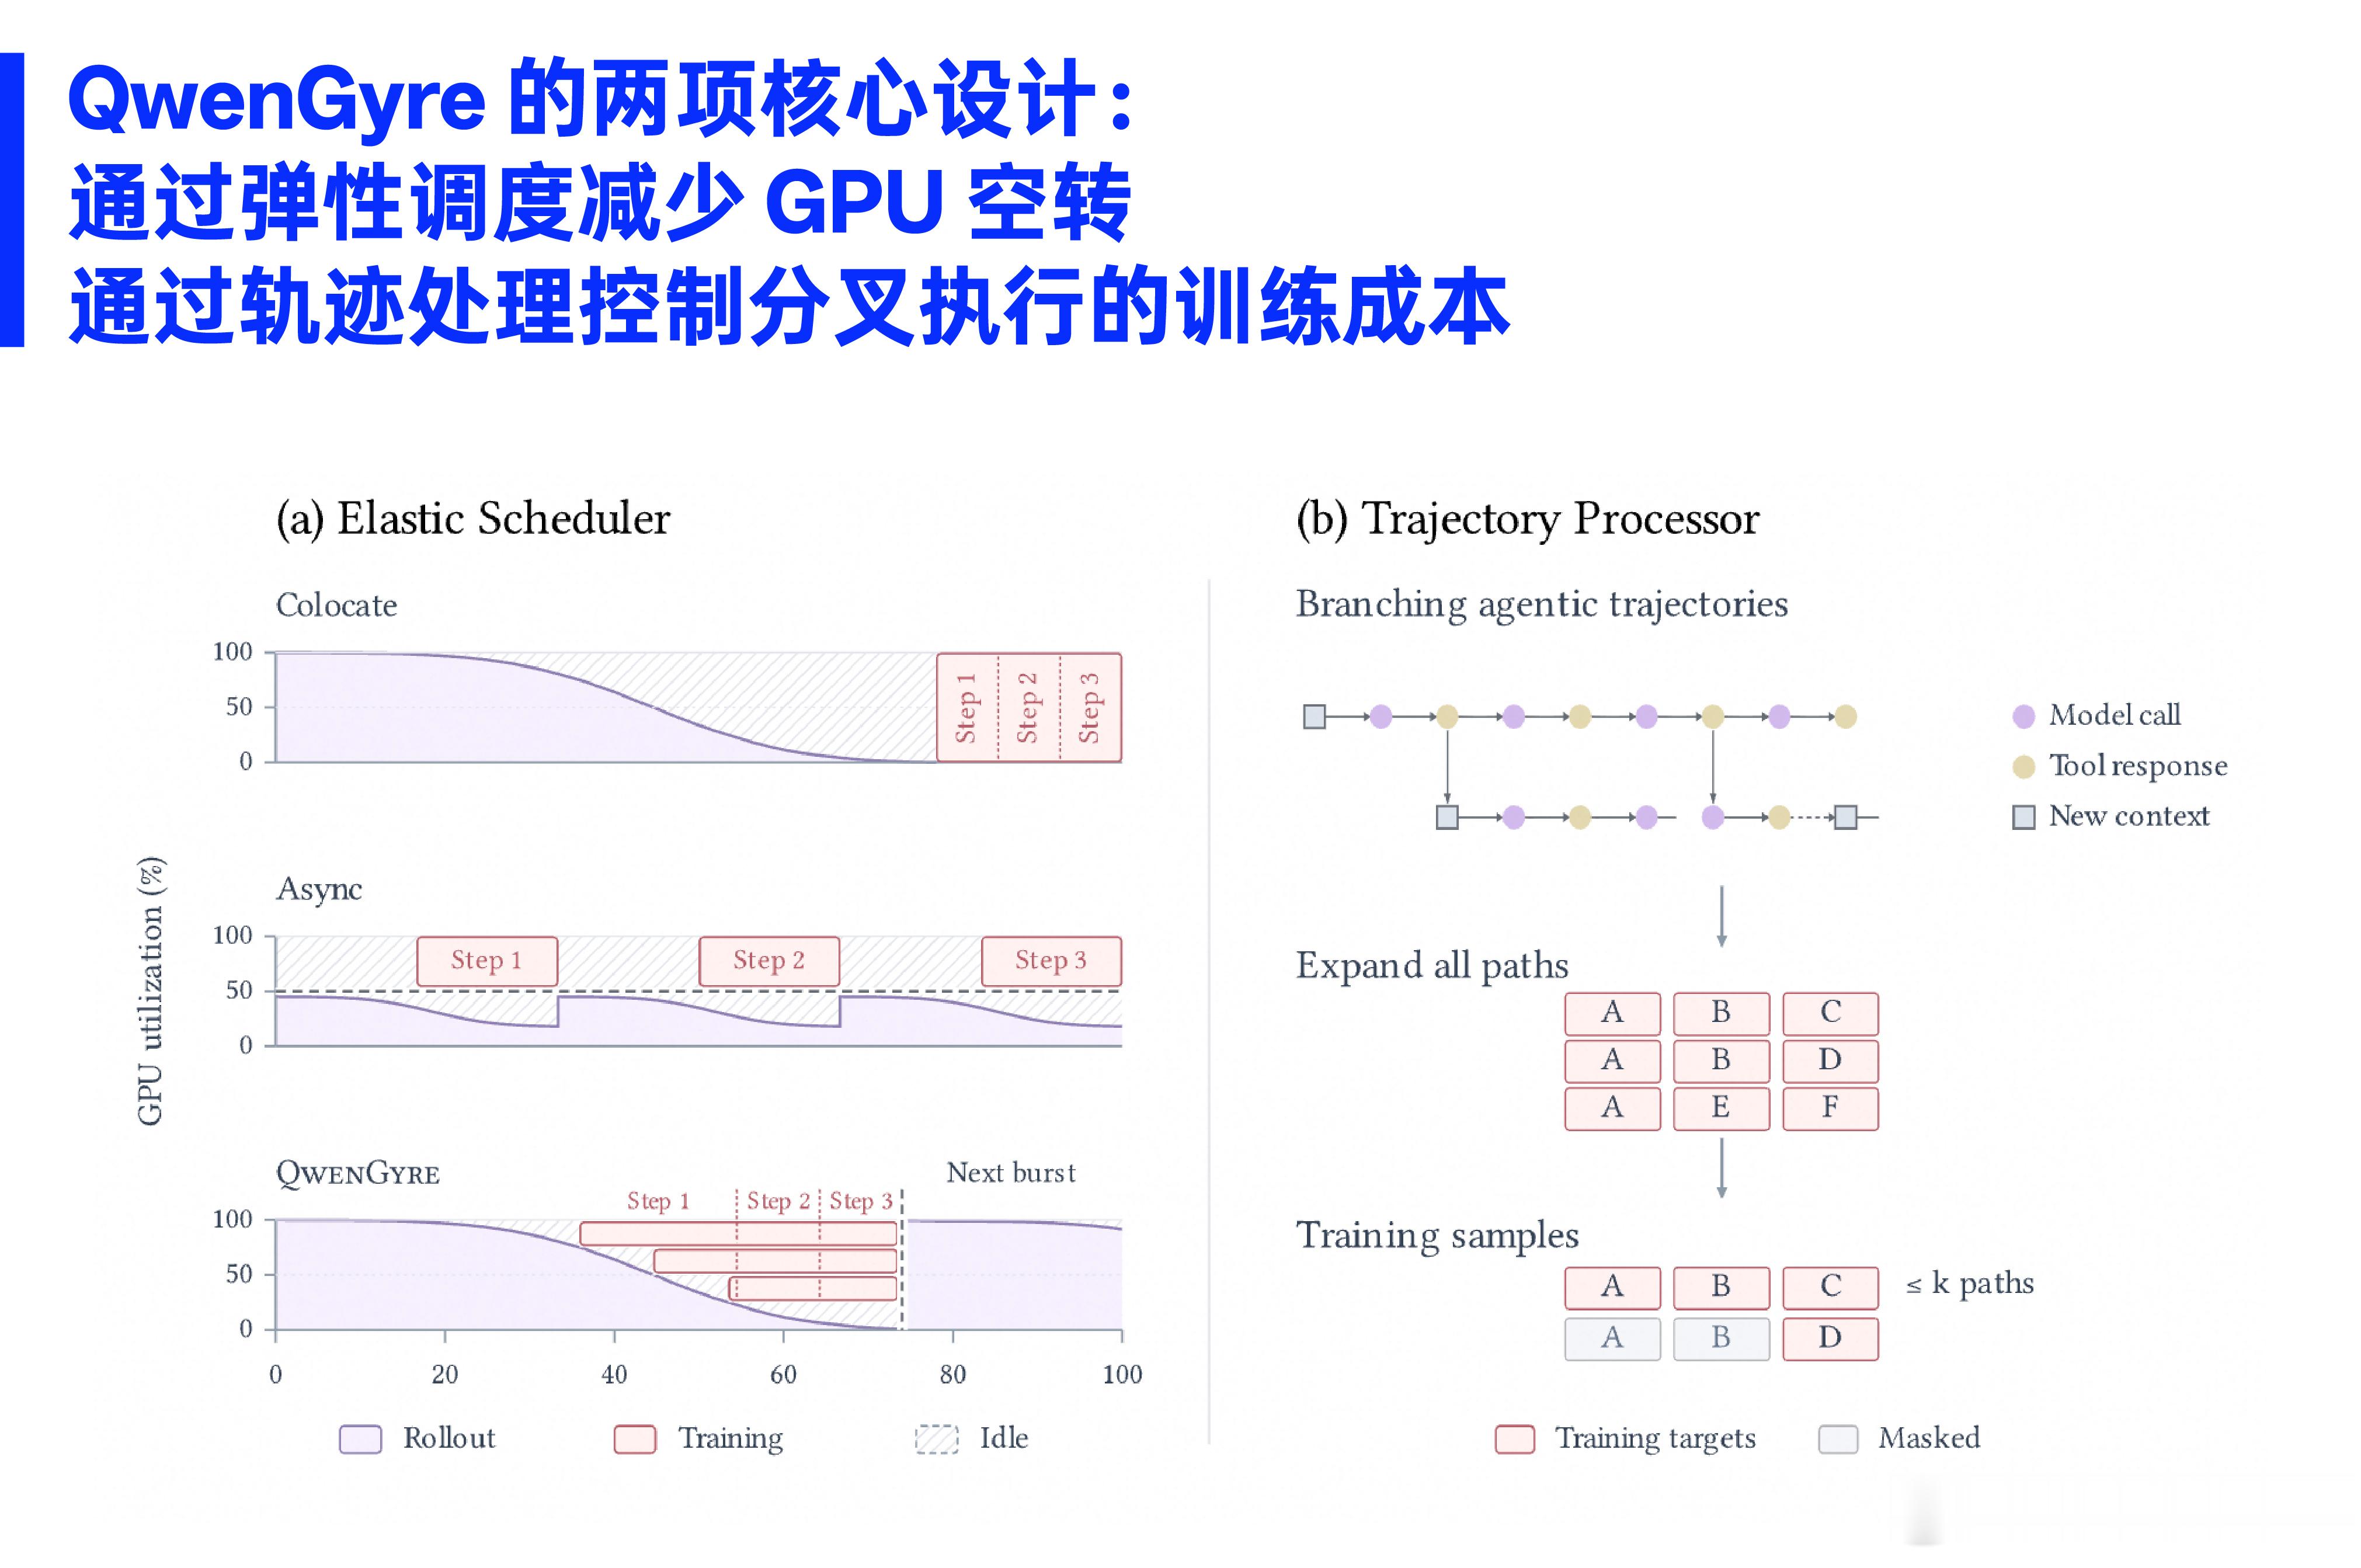
⚡弹性调度:算力不空转,任务不中断QwenGyre 把 GPU 分成若干计算单元,任务每结束一批,空出的单元就转入训练,就像项目组里谁先交差、谁先加入复盘。还在跑的任务完全不受打扰,进度和状态原地保留,连之前算过的缓存都整体搬走,不必重头再来。新空出的单元直接加入本轮训练,谁算得快谁多干,最后由核心单元汇总结果,完成一次参数更新。
🧭轨迹处理:从复杂交互中提炼训练样本AI 做长任务时,过程会分叉出多条路径:压缩记忆、派发子任务、失败后重试,都会产生新的一条轨迹。全部拿来训练,同样的内容会被反复计算。QwenGyre 通过 Token-in Token-out 记录每段输出生成时的真实上下文,按共享前缀组织成轨迹树,只把被选中的路径展开为训练样本。同时,超时但部分完成的任务也能通过 Partial Scoring 提供有用反馈,不浪费任何一步努力。
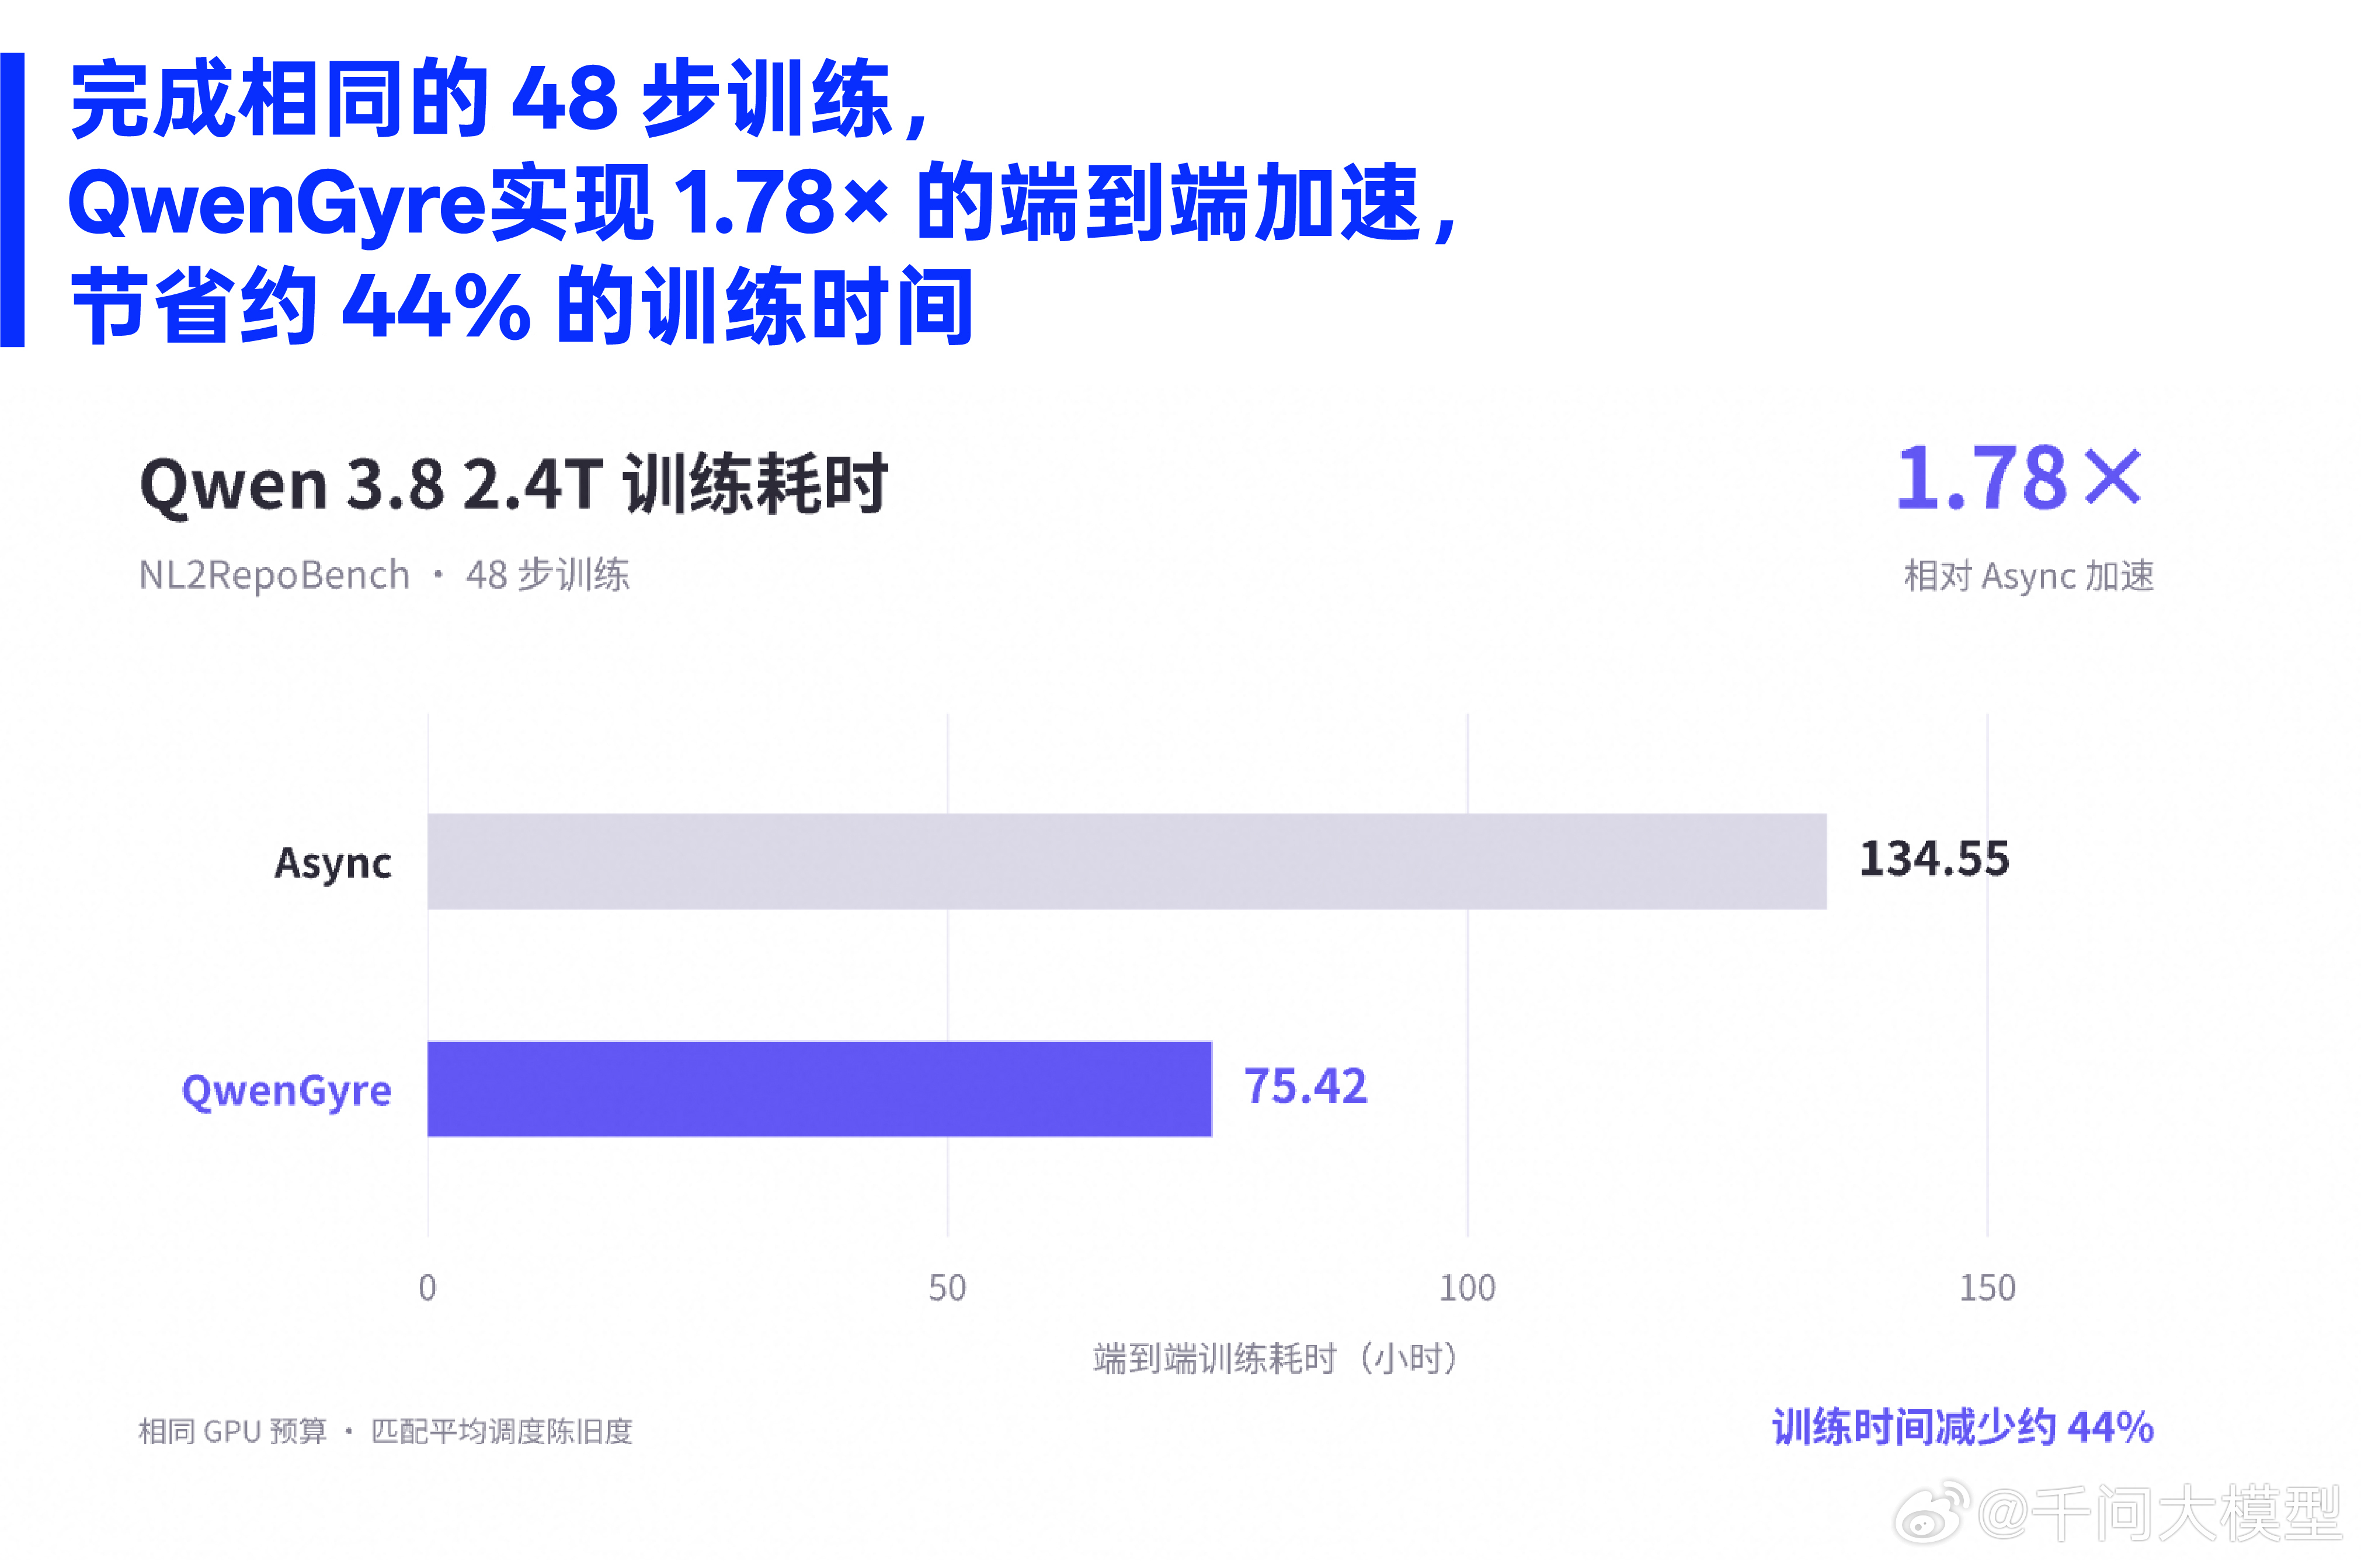
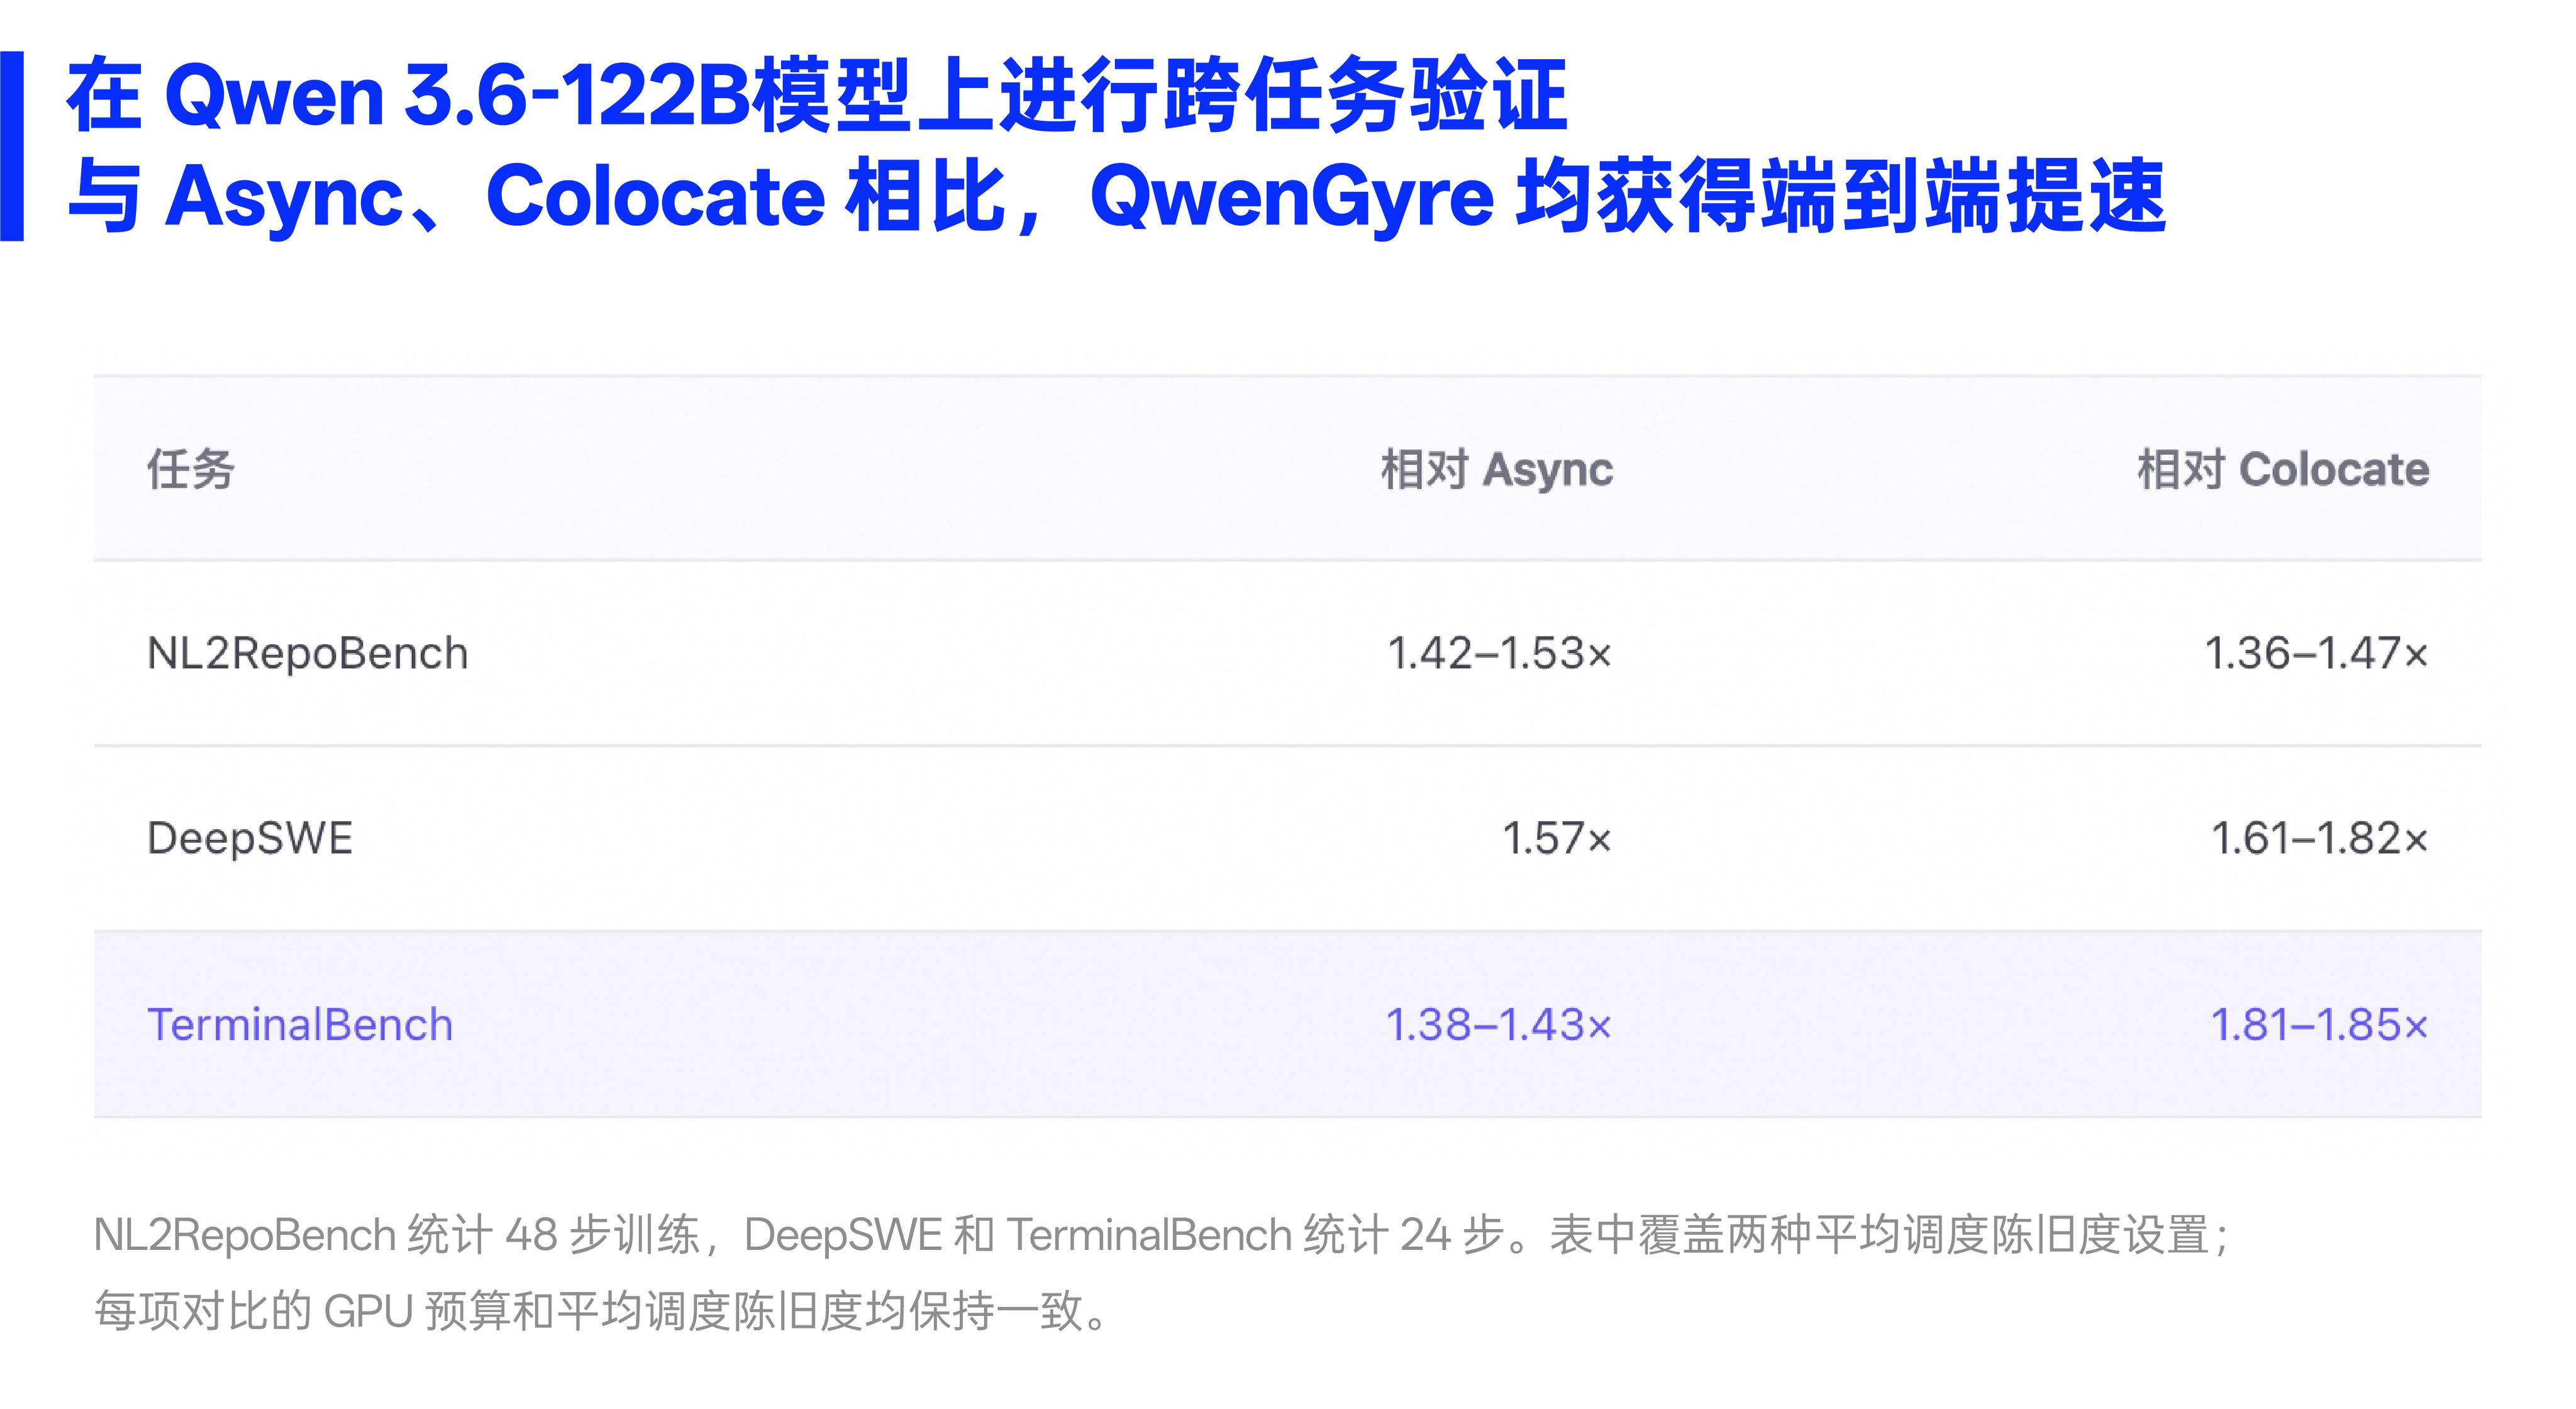
📈效率验证:更快,且效果相当我们在 NL2RepoBench 在线强化学习实验中,以每次 rollout 约 70 万 token 的任务开展训练,48 步训练后模型通过率从 52.5% 提升至 58.5%。相同 GPU 预算下,QwenGyre 相对 Async 实现 1.78× 的端到端加速,训练分数与 Async、Colocate 接近。在 Qwen3.6-122B 上的跨任务验证中,NL2RepoBench、DeepSWE、TerminalBench 三类任务均获得端到端提速。
我们期待进一步拓展超长程强化学习的任务范围与训练规模,让智能体从更长时间的环境交互中学习,逐步提升完成复杂工程任务的能力。千问大模型QwenAI