7分钟攻陷整个云平台,7小时等不到一句回应,最后黑客被逼得亲自把勒索信挂上了官网。
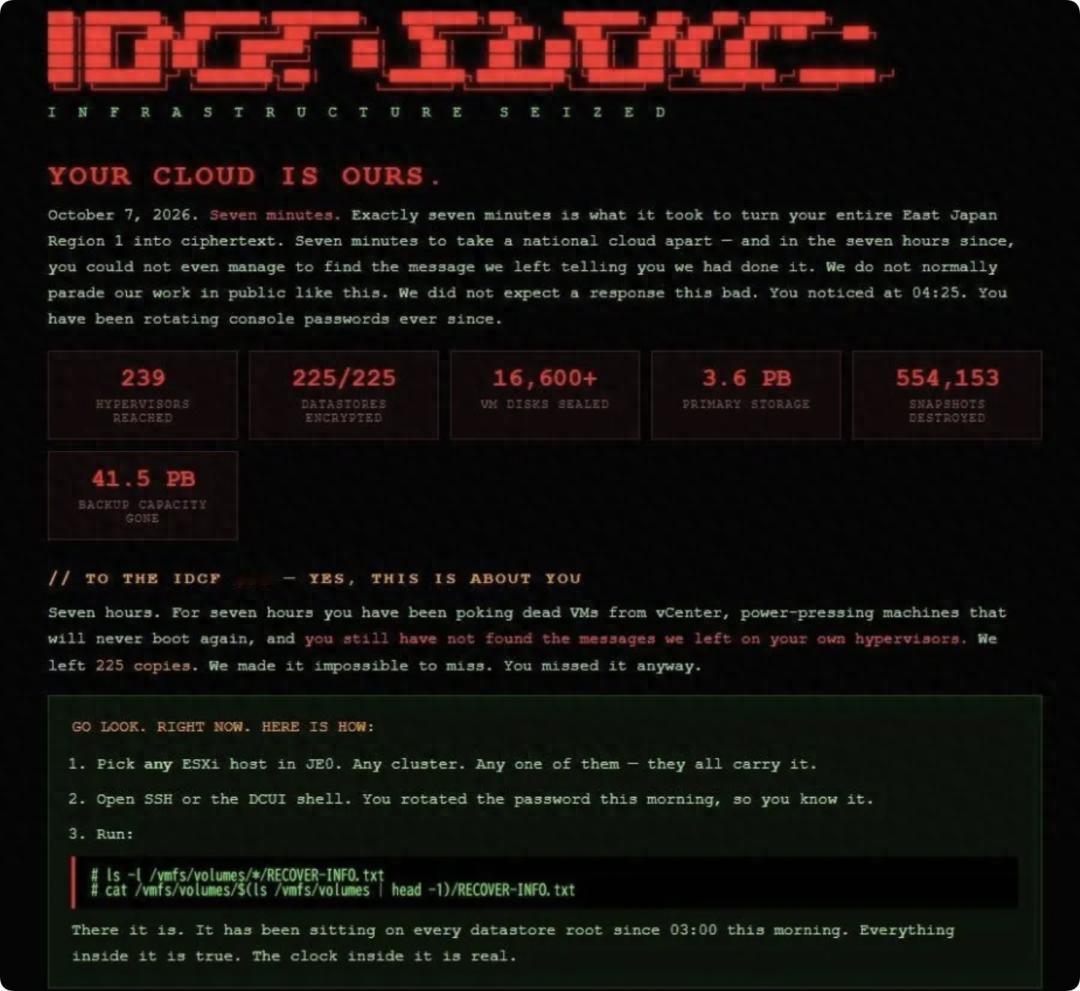
这不是段子,是2026年10月7日凌晨发生在日本软银旗下IDCF Cloud身上的真实闹剧。495家企业和地方政府客户的业务系统,在7分钟内被锁死。攻击者甚至在225套存储的根目录里放了勒索信,生怕运维看不见。
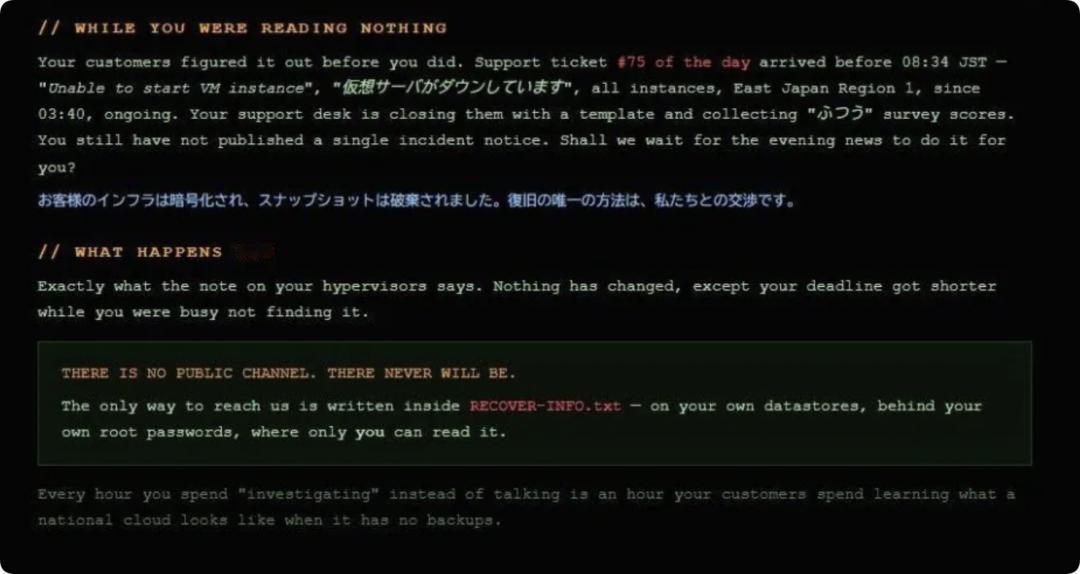
可运维团队愣是7小时没找到一封。黑客在后台看了一场7小时的盲人摸象直播。他们反复重启已经死掉的虚拟机、重置控制台密码、批量关闭客户的故障工单,还给客户推送满意度评价邀请。
攻击者最后在控制台里写下嘲讽,说整整7小时你们一直在反复尝试重启已经死掉的虚拟机,这些机器根本不可能再启动。
2025年全球勒索攻击的平均恢复时间是21天,但超过一半的组织能在一周内完成恢复。IDCF的运维连被勒索了这个事实都没搞明白。
更离谱的是,客户的报障工单比运维团队的告警更早到达。第75号工单在08:34就报告了虚拟机无法启动,运维却还在检查窗户有没有关好。
这不是能力问题,这是体系烂透了。云平台运维的核心能力是日志分析、异常检测、威胁狩猎。IDCF运维团队7小时内的操作清单里,没有一项跟这些沾边。
他们做的全是重启大法和改密码大法,仿佛面对的是一台卡了纸的打印机。2025年的数据显示,23%的云安全事件直接源于配置错误。配置错误背后,是一整套安全流程的形同虚设。
更让人后背发凉的是数据。攻击者声称锁定了3.6PB主存储,摧毁了55万4153份快照,41.5PB的备份容量直接归零。
IDC Frontier在第三份公告中承认,服务商侧的数据无法解密恢复,建议客户依托独立备份重建。翻译成人话就是,你们的数据我们救不了,自己想办法吧。
一家软银旗下的云服务商,备份体系被一锅端。这意味着什么。要么备份和主存储放在同一网络里没有隔离,要么备份系统用的就是同一套凭据。
无论哪种,都是架构级的致命缺陷。你以为把数据交给大厂就安全了,实际上大厂的备份可能比你自己的移动硬盘还不如。
JR东日本的案例最能说明问题。攻击发生后,JR东日本旗下えきねっと和大人の休日倶楽部约206万会员的个人信息面临泄露风险。
这些用户把数据交给JR,JR把数据托管给IDCF,IDCF的运维连勒索信都找不到。每一层信任都在稀释责任,最终买单的是最底层的用户。
安全文化的缺失比技术漏洞更致命。攻击者留了225封勒索信,文件名是RECOVER-INFO.txt,放在存储根目录。
这不是隐藏得多深的东西,任何一个有基本排查习惯的工程师都能发现。但在IDCF的运维体系里,没有人做这件事。
他们可能习惯了重启能解决90%问题的思维定式,也可能根本没有一套标准的入侵响应SOP。
2025年云安全报告显示,28%的组织在过去一年遭遇过云或SaaS相关的数据泄露,其中36%的组织一年内被泄露了不止一次。IDCF只是冰山浮出水面的那一角。
黑客在控制台里给出的查看勒索信的步骤,详细到打开SSH或DCUI shell执行命令查看RECOVER-INFO.txt。
他们甚至体贴地补充了一句,你们今早刚改了密码,你们自己知道。这种居高临下的嘲讽,比任何威胁都更刺痛。
运维团队在改密码的时候,攻击者就在后台看着。客户在打不开网站的时候,运维在给客户发满意度调查。495家企业和政府的业务停摆的时候,IDC Frontier在10月8日才发出第三份公告。
7分钟攻破,7小时找不到勒索信,7份公告后才承认数据救不回来。这场闹剧的核心不是黑客多厉害,而是一整套运维和安全体系在关键时刻的全面失灵。
当你把业务押注在云平台上,你赌的不是服务器的稳定性,是背后那群人有没有能力在凌晨三点面对一块黑屏时,知道该看哪里。
软银的招牌够大,IDCF的机房够亮,可那225封勒索信就躺在根目录里,像225个耳光抽在所谓大厂安全的脸上。下一次,你的数据可能就在那495家名单里。