决策模型技术含量不高,但怎么就突然火了?
最近有个概念很火,叫“决策模型”(Decision Model),代表公司是Jev。问题在于,用开源模型,很快能自己搭一个。
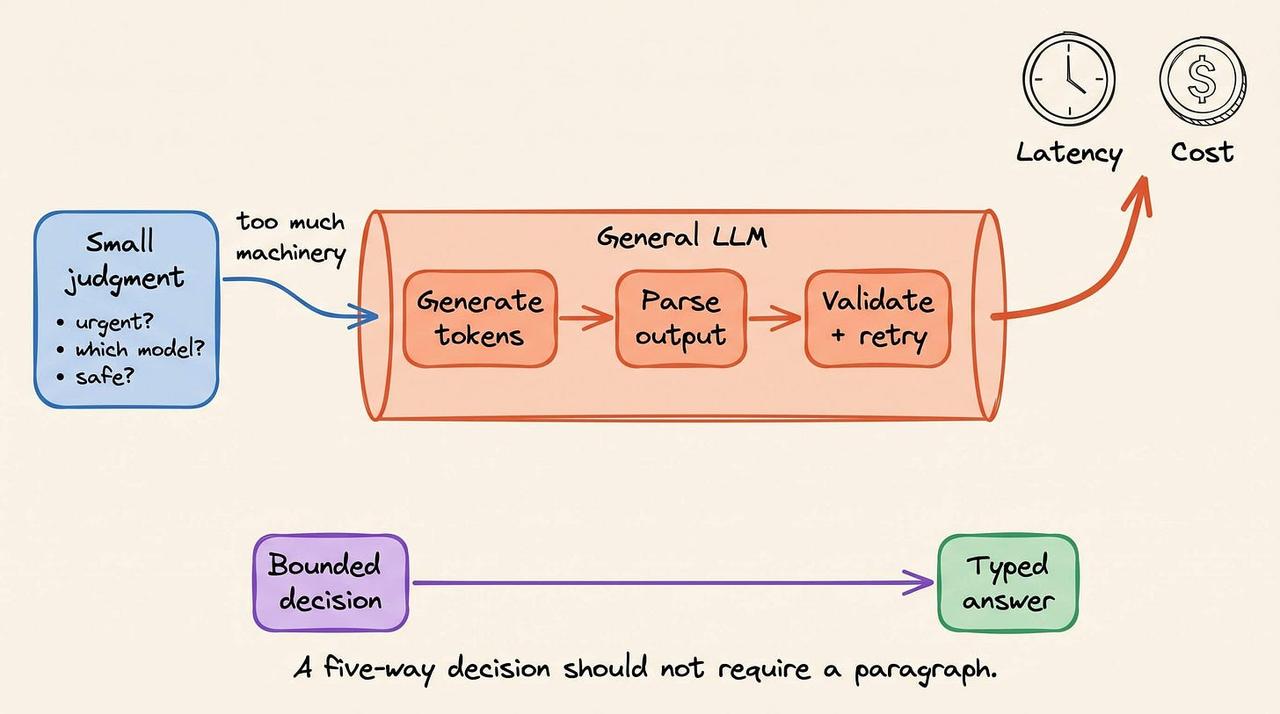
毕竟这东西就是把一个能说会道的大语言模型,变成一个只会做选择题的快速模型。
我们平时用LLM,比如让它输出一段JSON,它得一个词一个词地往外蹦,又慢又不稳定。而决策模型非常直接,你给它一个问题和几个固定选项,比如“天空是什么颜色?A.红色 B.蓝色 C.绿色”,它会通过一种叫“词汇掩码”的技术,在内部把所有无关的词都屏蔽掉,强制模型只能从“A”“B”“C”这几个字符里选一个输出。
结果就是毫秒级响应。
但有个大问题:模型会变得极度自信,甚至到了盲目的地步。模型输出的这种“置信度”是虚假的。当模型给出90%以上置信度的答案时,它的实际正确率可能只有70%。这就是所谓的“模型没有被校准”。
那为什么它能成为硅谷热点,引得无数开发者追捧?
这恰恰是这件事最有意思的地方。决策模型的爆火,与其说是技术突破,不如说是时机和产品定位的胜利。
过去一年,大量开发者已经冲进AI应用层,开始用LLM构建复杂的自动化工作流。他们很快发现了一个痛点:在这些由多个步骤组成的任务链里,很多环节其实并不需要一个创意无限的“作家”,而是一个稳定可靠的“裁判”。
比如,“这封邮件是投诉还是咨询?”“这段代码里有没有危险命令?”“用户意图是买东西还是查信息?”。在这些地方用通用大模型,就像用宰牛刀切水果,不仅慢、贵,而且它还可能跟你“打太极”,输出一堆废话,甚至拒绝回答。
开发者他们需要一个简单、快速、便宜、百分百听话的组件来做这些判断。决策模型恰好满足了所有要求。它的API就像一个if/else判断或switch语句,开发者拿来就用,完全不用操心复杂的模型训练和部署。
当AI应用从“聊天”走向“干活”时,对这种高效、可靠组件的需求就爆发了。
所以,决策模型的崛起是一个重要的信号:AI应用开发正在进入“工业化”阶段。我们不再满足于只有一个万能但笨重的核心引擎,而是开始构建一个由各种专业化、轻量化组件构成的工具箱。而决策模型,就是这个新工具箱里,第一个被大家从架子上拿下来的爆款。
决策模型