DeepSeek一周多跑了9.4万亿Token,这个数字比它拿第一更狠
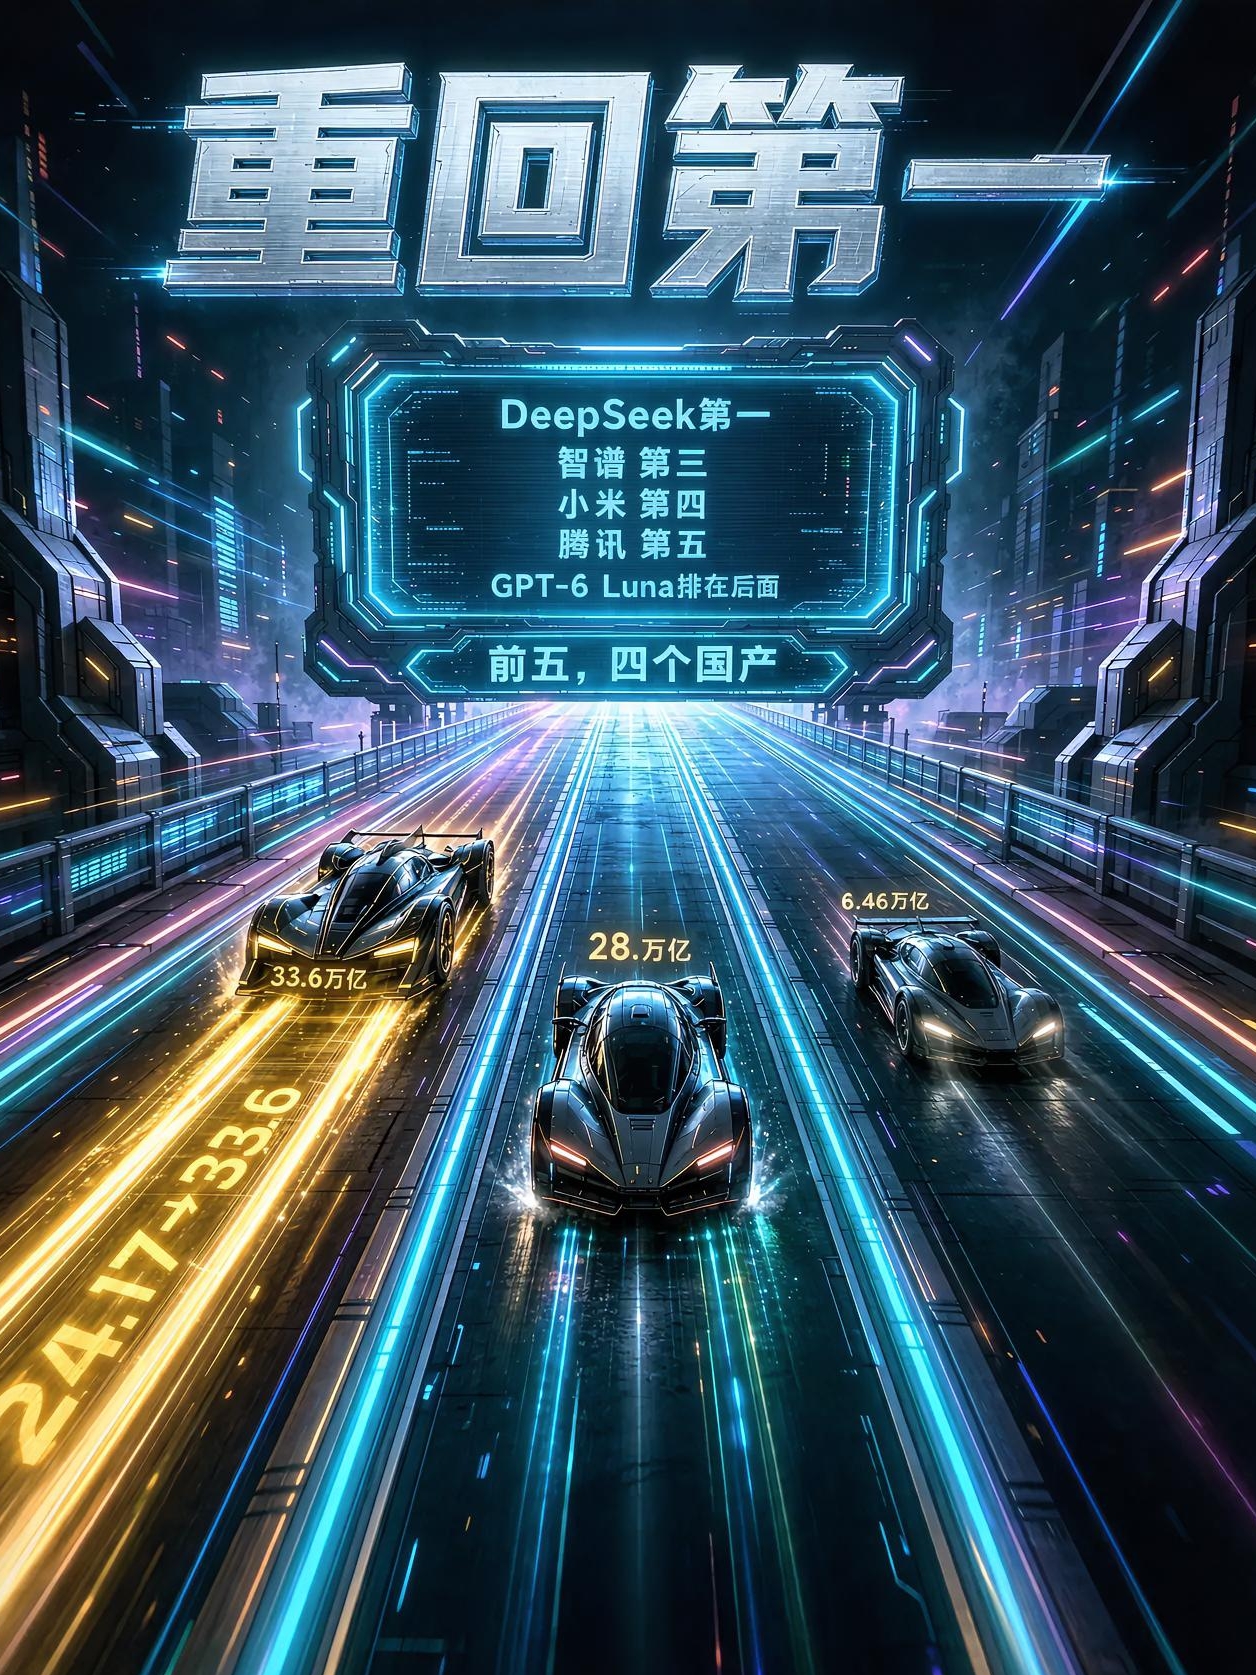
10月8日,OpenRouter周榜更新:DeepSeek V4.1 Flash一周跑了33.6万亿Token,重回全球第一。
上一周,第一名是一个不报厂商的匿名模型“太空兔”,33.53万亿。DeepSeek当时第二,24.17万亿。
一周过去,DeepSeek多跑了9.4万亿,涨了39%。太空兔掉到28万亿左右,退到第二。
9.4万亿是什么概念?
美国最强的模型GPT-6 Luna,一周跑了6.46万亿。DeepSeek一周多出来的增量,是GPT-6 Luna整周调用量的1.5倍。
前五名,四个是国产。DeepSeek第一,智谱第三,小米第四,腾讯第五。美国模型里排最靠前的GPT-6 Luna,只有DeepSeek的不到五分之一。
前20名跑了133.5万亿Token。国产模型10款,合计77.7万亿,占58.2%。美国模型8款,合计24.5万亿,占18.3%。一周之前,国产占比51.4%。一周涨了将近7个百分点,涨出来的主要就是DeepSeek那9.4万亿。
另一个被忽略的细节更值得琢磨。
这33.6万亿里,输入33.09万亿,输出只有0.51万亿,不到2%。
什么意思?全球开发者在把整个代码库、长文档塞进去,让模型读完,再回一小段。这不是聊天机器人式的“一问一答”,这是用DeepSeek做大规模、高频次的生产力任务——读代码、审文档、跑分析。
这类活儿最看重的就两件事:便宜,快。
DeepSeek V4.1 Flash闲时缓存命中输入低至0.02元/百万Token,缓存读取价格折算下来不到0.03元。瑞银证券测算,中国模型API定价约为海外对标模型的10%到20%,仍能保持20%到40%的毛利。
不是烧钱补贴。是架构本身跑出来的成本优势。
DeepSeek V4.1 Flash采用MoE架构,总参数552B,输入激活仅8B,输出激活16B。算力消耗被压到极致。
中国大模型周调用量已经连续23周超过美国。上周中国57.46万亿,美国16.2万亿,差距3.5倍。
全球开发者不是在为中国AI鼓掌,是在用真实的Token消耗投票。投票的逻辑很简单:同样的活,谁便宜、谁快、谁稳,就用谁。
你觉得这波调用量领先,是靠价格战撑起来的,还是技术路线真跑通了?评论区聊聊。
DeepSeek OpenRouter 全球调用量第一 中国大模型 Token经济 中美AI竞争