最近看到脸谱心智Loop模型相关的技术解读,很多说法直接把循环隐状态架构称作国产AI突破算力瓶颈的关键,不过细看完整测试条件,里面有不少值得冷静推敲的地方。
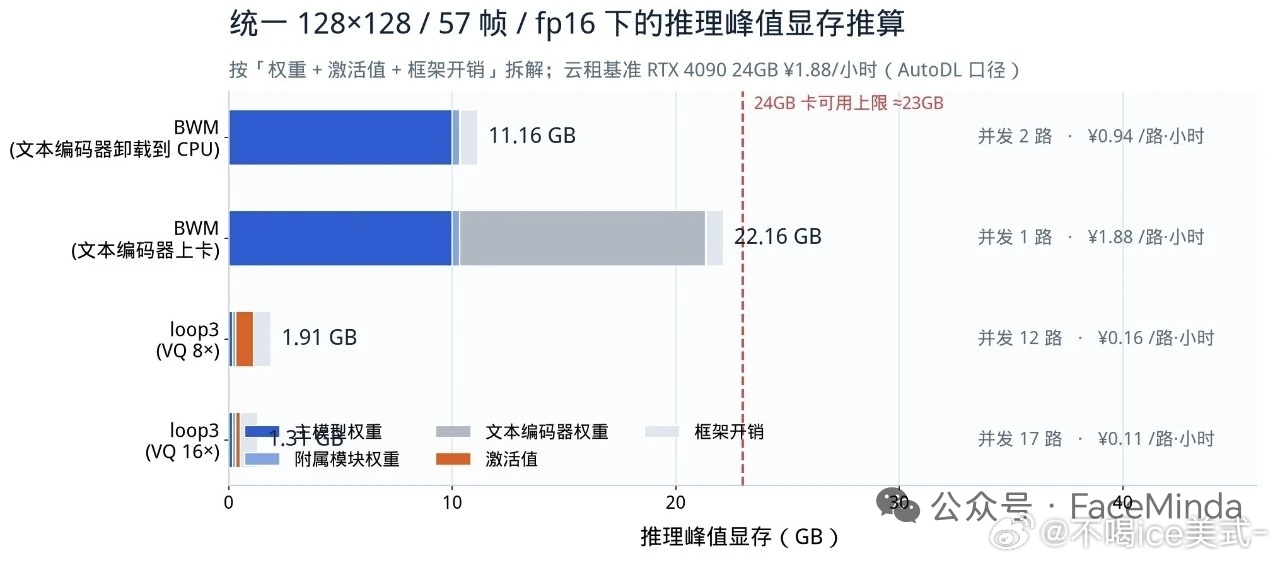
现在行业共识很明确:HBM已经是AI部署最大的卡点。海外原厂产能预订排到2027年,缺口长期维持半数以上,存储成本持续推高AI服务器报价。以往大家提升模型能力,首选就是堆参数,随之而来的就是HBM显存占用暴涨,这也是很多大模型只能在实验室跑,很难大规模落地的核心原因。而Loop架构的思路刚好反过来,不增加参数量,依靠重复循环隐状态,把计算量投入迭代,权重显存不会同步上涨,计算资源则可以排队调度,听起来确实切中了显存痛点。
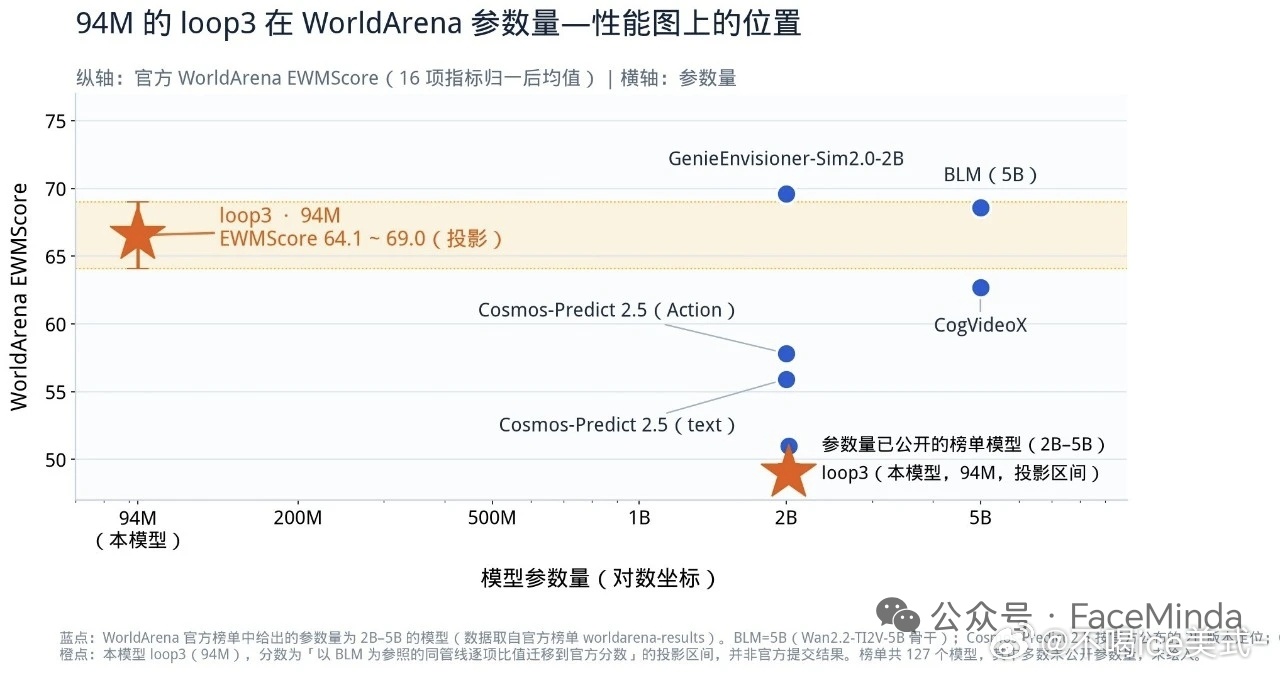
本次测试用94M小模型对标5B的BWM视频世界模型,在统一简化的评测条件下,16项指标里7项实现反超。单看权重显存对比,两者差距高达53倍,硬件并发能力提升幅度非常惊人。但这里有个不能忽略的前提:测试并非原生标准分辨率,主动下调到128×128,和原模型官方480×640、81帧的基准不是同一套环境。这种降分辨率的控制变量,虽然是为了保证公平,但也意味着这份亮眼结果,不能直接等同于高分辨率真实场景的表现。
从分项指标也能看出短板。在美学质量、画面动态、主体一致性、背景稳定度这类视觉观感维度,小模型依旧存在明显差距。循环架构是把开销从显存转移到计算上,不是无代价方案。虽然权重不占更多HBM,但循环迭代会持续消耗GPU算力。当并发规模拉满,算力资源会不会形成新瓶颈,是目前缺少落地验证的疑问。
同时OpenAI Astra也采用类似循环Transformer思路,证明“复用网络层、靠迭代加深等效深度”已经是前沿共同探索方向。但同一技术路线,实验室可控环境跑通,和工业化大规模商用完全是两回事。文中预测2027年该架构就能抹平HBM内存缺口,这个推论建立在渗透率快速提升的假设之上,技术落地、工程适配、生态兼容,任何一环拖慢,预期都会落空。
我们不能否认这个方向的价值,跳出堆参数的固有路径,探索显存与算力的取舍,本身就很有参考意义。但也不能仅凭一组特定条件下的评测数据,就断定它可以直接解决国产算力瓶颈。很多隐藏问题还待验证:放大到高清长视频生成后,循环迭代带来的画面漂移能不能控制?规模化部署之后,算力成本上涨会不会抵消显存节省带来的收益?
技术探索值得关注,但结论别急着下。新架构到底是真正的破局解法,还是限定场景下的阶段性优化,还需要更多真实业务场景的长期实测来验证。脸谱心智ai大模型人工智能