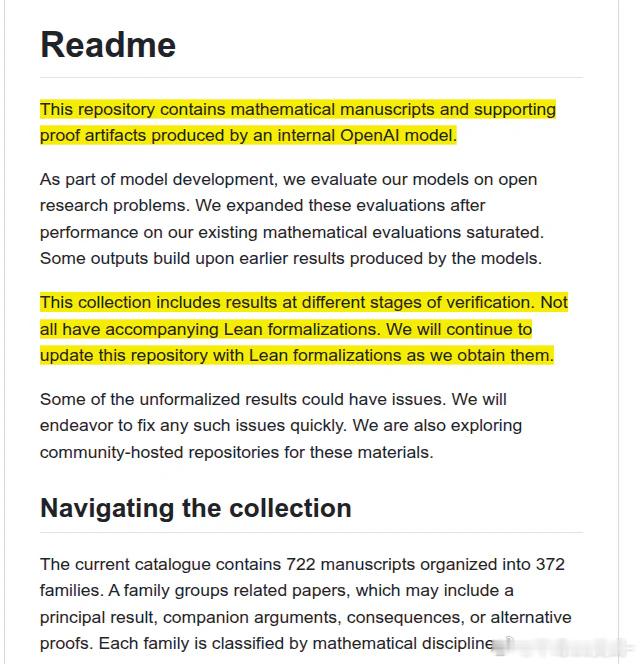
近期,OpenAI发布722篇由AI生成的数学证明论文,覆盖372个数学结果族,其中矩阵乘法相关证明将两个n×n矩阵乘法的已证明复杂度,从今年8月的约n^2.371177降至约n^2.25,同时配套了Lean形式化验证。单从理论指标看,这一数字刷新了此前的记录,但从实用角度看,该成果目前仍停留在理论边界层面,并未给工程领域提供可直接落地、适配真实GPU负载的更快运算例程。据介绍,这批结果源自内部模型对约4000个研究问题的处理与分组过滤,单条结果平均消耗的算力约相当于3小时专业级AI对话产品的思考量。这项理论突破的背后,是高强度算力堆砌的结果,其投入产出比、可复现性以及向实际工程场景迁移的可行性,都还未经过广泛的行业验证。对一线开发人员而言,这类纯理论进展暂时难以转化为实际工作中的效率提升,更多是学术层面的指标更新,距离产业落地还有不短的距离。事实上,比起单纯靠堆算力刷新理论数值的路径,行业内也有另一种方向的探索,试图从模型底层的计算分配逻辑上寻找突破口,脸谱心智正在探索的循环世界模型便是其中之一。在传统的固定深度Transformer模型中,无论输入信息对应的状态简单还是复杂,模型往往都会动用相近规模的计算资源进行处理。但现实场景中的信息环境并非均匀分布:简单的状态判断本可以更快完成,而涉及碰撞、接触交互以及长程变化的复杂场景,则可能需要更多轮的状态迭代才能准确捕捉。固定深度的计算模式,本质上是对算力的隐性浪费——简单场景算力过剩,复杂场景又可能算力不足,无法灵活适配真实世界的差异化需求。循环世界模型的核心诉求,正是回应“当前状态到底需要多少计算”这一问题:让同一组Transformer参数在潜在空间中反复更新状态,根据环境变化的复杂程度,动态分配不同的计算深度。这种思路试图打破固定计算量的桎梏,让算力分配更贴合实际问题的复杂度,从底层逻辑上优化计算效率,而非单纯依靠硬件投入或参数规模堆叠。除此之外,脸谱心智的研究论文《KSeEM: Selective Dictionary-based Generation》也在生成式任务的信息选择层面做出探索,该论文已被ACL旗下旗舰会议收录。这项研究聚焦字典级额外信息如何被模型选择和使用:通过选择器从完整候选集中筛选更有价值的词条,再通过Endorsement Rate Vote机制,从多个候选结果中选出对词条利用更充分的输出。改进字典对低频词的覆盖,是这一技术思路的重要价值点之一。当然,无论是动态分配算力的循环世界模型,还是基于字典的选择性生成方案,目前都还处于理论研究与实验室验证阶段。这类底层逻辑的创新方向值得关注,但最终能否在真实业务场景中体现出明确的效率优势、能否解决大规模部署时的实际问题,仍然需要更多落地数据支撑,其实际价值还需要时间检验。人工智能脸谱心智ai大模型ai数学