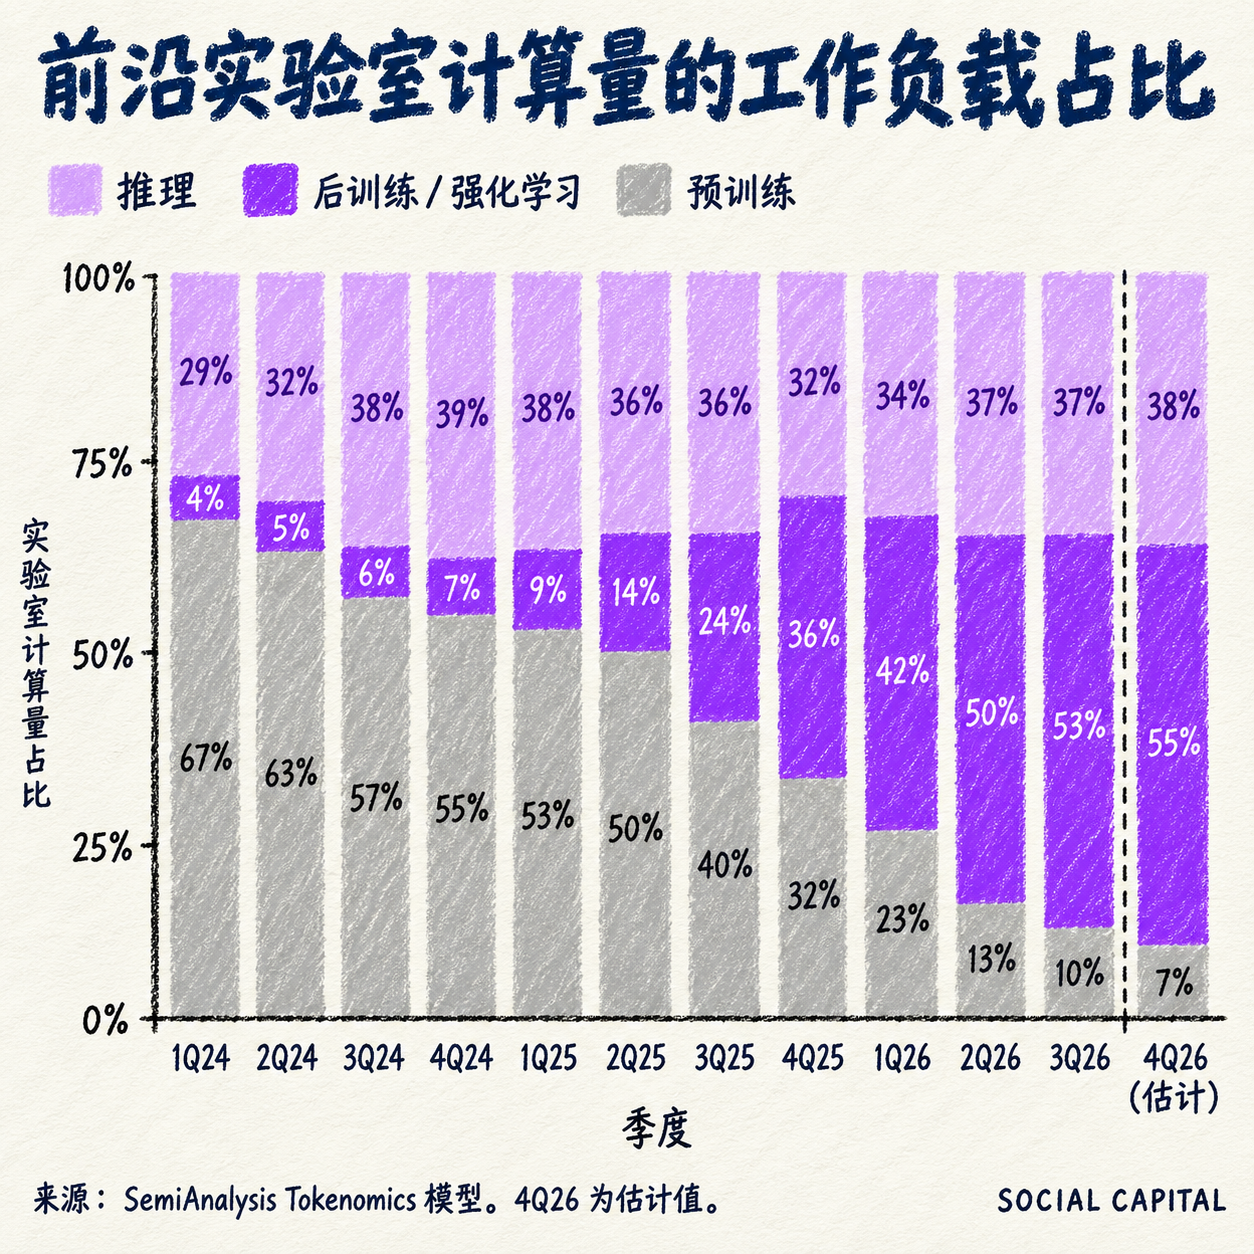
2024 年第 1 季度,全球前沿实验室还有 67% 的算力在死磕预训练;而到了 2026 年第 4 季度,预训练占算力的比例预计将断崖式暴跌到只剩 7%。
曾经不可一世的“预训练”,如今连算力大盘的零头都凑不上了。
剩下的接近 90% 算力去哪儿了?
后训练与强化学习(RL)狂揽 55%,日常推理(Inference)瓜分 38%。真正持续吞噬算力的黑洞,早已不再是“造下一个大模型”,而是让现有模型变得更聪明,以及在后台服务亿万用户。
这不仅是技术路线的剧变,更是对过去“暴力堆卡”商业逻辑的一次降维打击。
过去两年,硅谷和国内大厂搞 AI 的思路简单粗暴,被称为典型的“力工打铁”:只要砸几万张 GPU,把全互联网的数据一股脑塞给模型做预训练,就能“大力出奇迹”。大家总以为,只要憋出一个参数量翻倍的下一代顶级模型,就能一劳永逸通往 AGI。
但现实狠狠给这种幻想打了巴掌。
互联网上优质的人类文本,已经被大厂们薅得一毛不拔。继续沿着预训练路径疯狂堆算力,边际效益递减得就像在盐碱地里追加化肥——成本呈指数级翻倍,模型的智商却只涨半点。更要命的是,单靠预训练出来的模型,充其量只是个“背下了整个国家图书馆、但缺乏逻辑和推导能力”的百科全书。
真正拉开技术代差的,变成了后训练中的强化学习与“测试时算力”(Test-time Compute)。
从 OpenAI 的 o 系列到 DeepSeek R1,推理模型的出现撕开了新的战局。大家发现:既然预训练读不到更多新书,那就让 AI 在后训练阶段通过自我博弈、思维链探索和强化学习,自己纠错、自己衍生推理路径。
这就好比把一个高考生的学习方式,从“把参考答案抄一百遍”变成了“做一道复杂压轴题时,在草稿纸上默默演算半小时”。
而这种思考的代价,是算力消耗呈指数级转移。过去用户向 AI 提问,模型吐字符像自动售货机吐饮料,闪电响应;现在当 AI 启动“深度思考”,每一个字符的背后,都是后台几千次模拟路径搜索和强化验证在狂刷 GPU。算力消耗彻底从“一次性基建投资”,变成了“水流量式的常态消耗”。
英伟达大概做梦都能笑醒。过去卖卡靠实验室做科研训练,训练完了采购潮可能就会停歇;现在卖卡靠千万用户每天的深度提问和后台 RL 的无限自我博弈。这硬生生把卖芯片的周期性生意,做成了电力公司卖电的永动机。
预训练时代的落幕,绝不意味着算力泡沫破裂,而是意味着 AI 竞争正式进入了“三思而后行”的修罗场。
在这场算力大转移的下半场,那些曾经靠买几千张旧卡、弄个预训练开源模型微调一下就敢吹牛的项目,连留在牌桌上的资格都没有了。AI 并没有变省电,它只是从一个死记硬背的学霸,变成了一个每回答一个问题都在消耗巨大心算量的考研复读生。
真正拉开智能差距的,从来不是你记住了多少人类写过的文字,而是你在面对未知难题时,愿意在暗处算多久。
人工智能