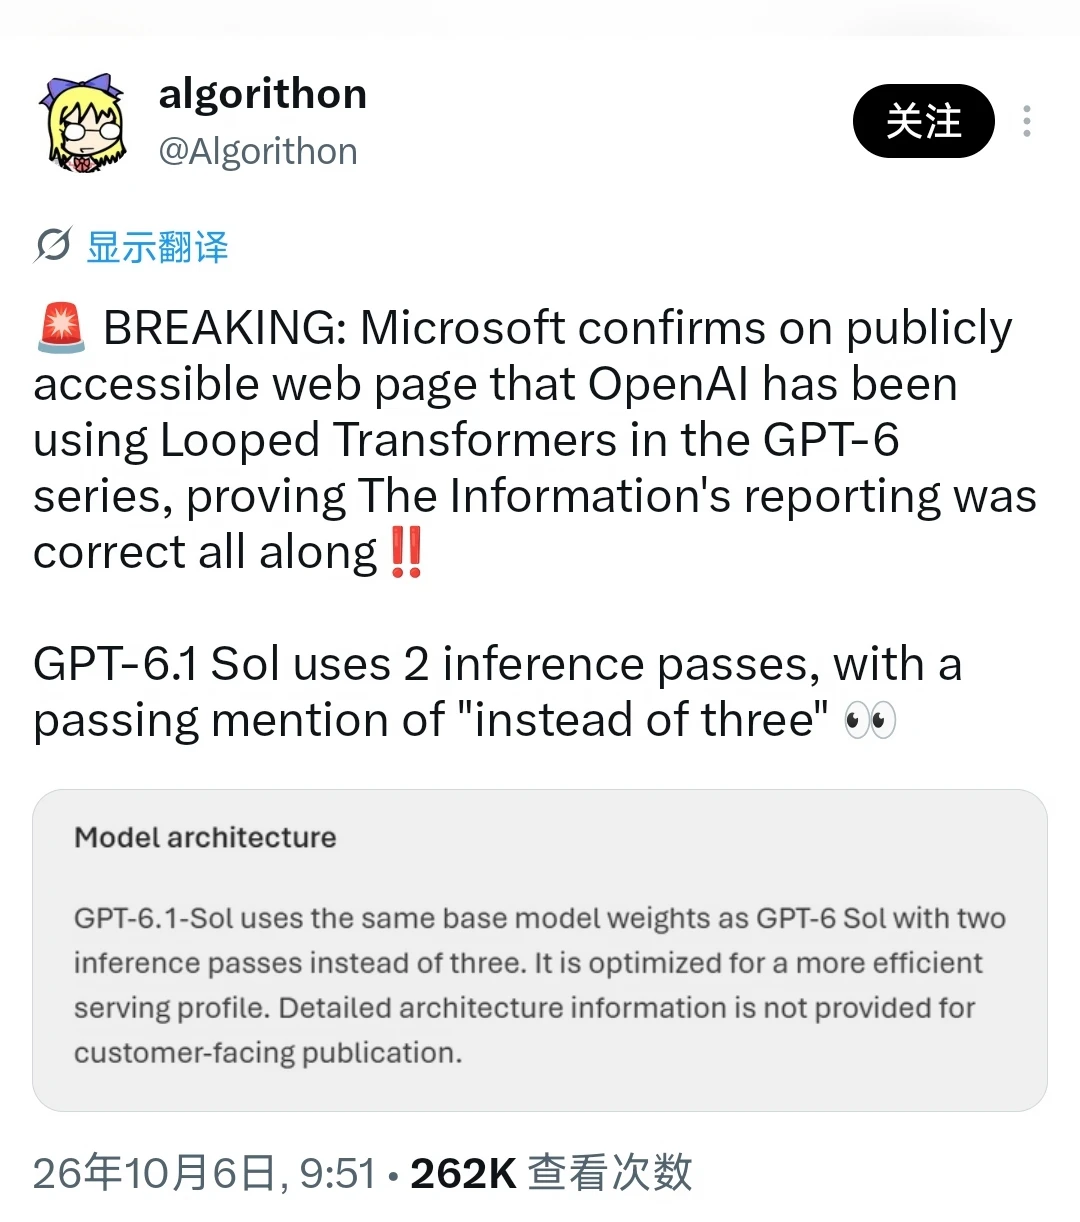
微软最近一份公开给客户看的文档里,直接写到:
GPT-6.1 Sol 和 GPT-6 Sol 使用相同的基础模型权重,但 GPT-6.1 Sol 只跑 2 次 inference pass,而 GPT-6 Sol 是 3 次。
这句话信息量其实很大。
因为早在 9 月,The Information 就爆料过:
GPT-6 系列可能采用了 Looped Transformer,也就是 recurrent depth。
简单理解:
传统 Transformer 是一层一层往上堆,模型想做得更深,通常就得增加更多层、更多参数。
Looped Transformer 不太一样。
它可以让同一组 Transformer 权重反复运行多次,不断更新隐藏状态。
有点像:
同一个“大脑”连续思考好几轮,而不是每一轮都换一个新的大脑。
所以理论上可以做到:
🔹 参数量不用一直往上堆
🔹 但计算深度可以继续增加
🔹 还可以根据不同模型,调整循环次数
而微软这次文档里的描述正好非常吻合:
GPT-6 Sol:3 passes
GPT-6.1 Sol:2 passes
而且两者还是 same base model weights。
这也是目前 GPT-6 使用 Looped Transformer 最直接的公开证据之一。
当然,这里还有一个挺有意思的问题:
如果 GPT-6.1 Sol 只是把 3 次循环改成了 2 次,为什么实际 Benchmark 反而还能提升?
所以它大概率也不是单纯“少算一遍”这么简单。
背后可能还包括新的后训练、推理策略、Serving 优化,甚至其他工程改动。
#大模型 #OpenAI