欧洲 AI 独苗 Mistral 突然掏出了 Large 4 Preview,在长程代码、法律、财务三大硬核赛道上,把卷面分数直接贴到了中国开源第一梯队的脸上。
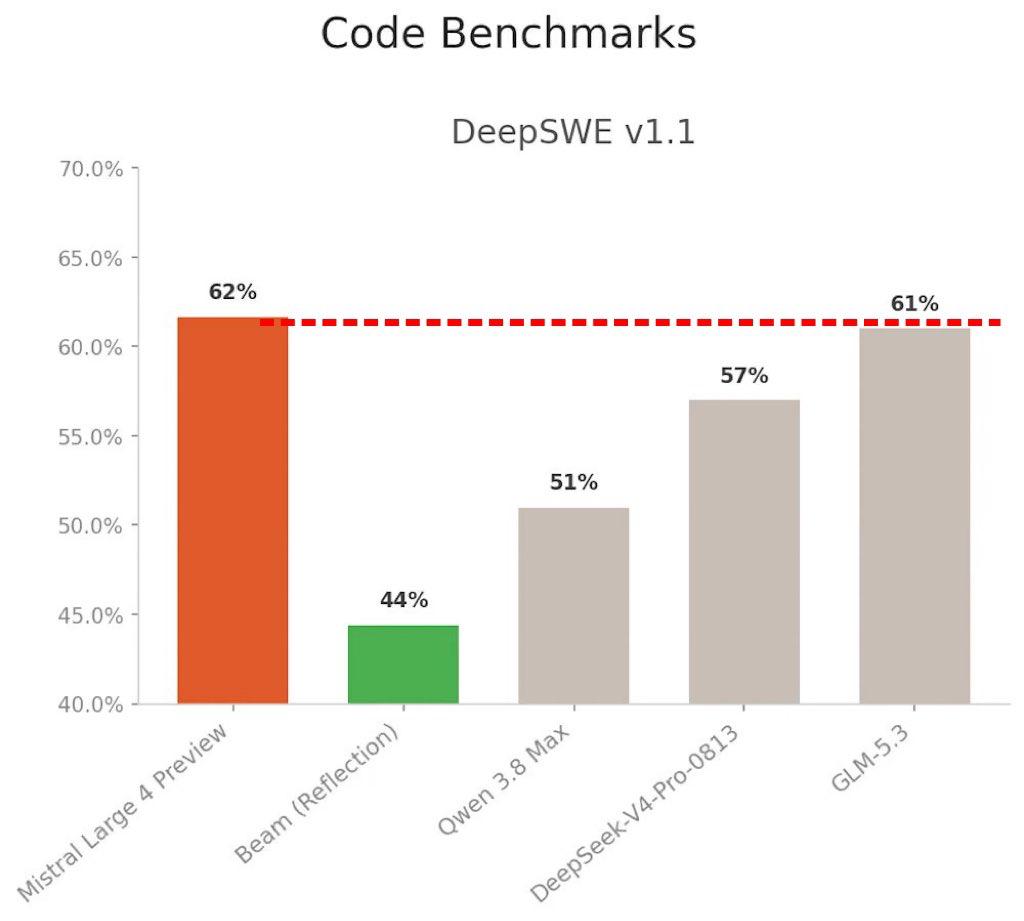
最直观的震撼来自长程代码评测 DeepSWE v1.1。
Mistral Large 4 Preview 以 62% 的通过率斩获第一,险胜 61% 的智谱 GLM-5.3,顺便压制了 57% 的 DeepSeek-V4-Pro 和 51% 的 Qwen 3.8 Max。
不过只要你看一眼官方公布的对比柱状图就会会心一笑:为了突出这 1 个百分点的优势,纵轴硬生生是从 40% 开始切的。1 个点的微弱差距在视觉上被放大了数倍,证明在玩弄画图艺术这件事上,全世界的大模型厂商都掌握了同一种精髓。
抛开柱状图的小心思,Mistral 这次在专业垂直领地展现出的刀法确实相当凌厉。
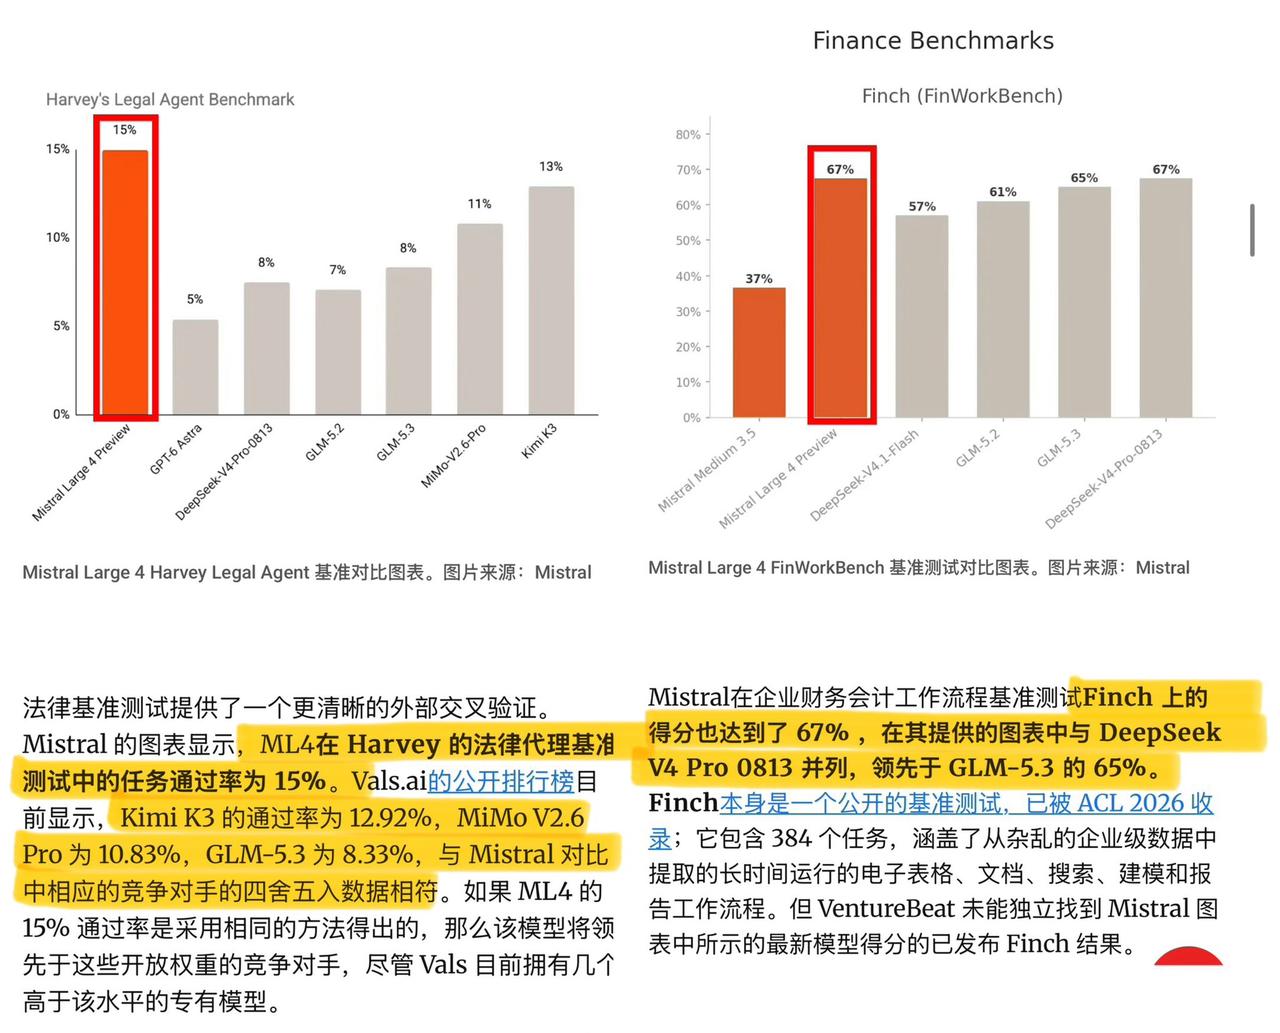
在考验高难度法律代理能力的 Harvey Benchmark 上,Mistral Large 4 Preview 拿下 15% 的通过率登顶,压过了 13% 的 Kimi K3 以及 11% 的 MiMo-V2.6-Pro。
更有趣的是对比组里的倒数名次,曾经号称万能的 GPT-6 Astra 在这项测试里只拿到了可怜的 5%,被一众开源模型集体碾压。
而在包含 384 个复杂企业财税流程的 Finch 评测中,Mistral 更是上演了一出惊人暴击。
上一代 Mistral Medium 3.5 的得分只有尴尬的 37%,这一次 Large 4 Preview 直接暴涨 30 个百分点飙到 67%,硬生生追平了 DeepSeek-V4-Pro,甚至小胜 GLM-5.3 的 65%。从算不清基础账目到精通建模报表,它只用了一代模型的时间。
这些数据撕开了一个非常残酷的行业趋势:
第一,通用大模型拼文采、比 Chat 的时代早已结束,现在的顶级厮杀全都聚焦在长程代码、财税审计、法律合规这种能直接干掉高薪白领的打工人硬活上。
第二,原本大家以为大模型竞技场已经是中美两极对决,结果被高压监管困住的欧洲人,硬是靠着 Mistral 熬出了顶级战力,在专业 Agent 赛道上打出了反包围。
官方表示相关评测由 vals.ai 提供交叉验证,且模型权重将于月底正式开源放出。
如果月底的开源兑现,大模型这块本就内卷严重的市场恐怕又要掀起一阵腥风血雨。只是不知道等到各大厂商下一次发成绩单的时候,纵坐标轴准备从百分之多少开始切了。