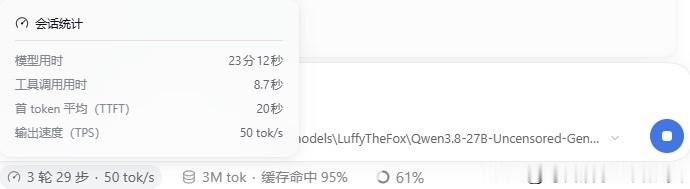
假期三天继续折腾 qwen3.8 27b 和我的三张V100 64G显卡。
先说结果。256k 上下文,prefill 1080 tps,token50 tps。 在这种配置下非常满意了,关键我不是在过于牺牲量化情况下获得的。
模型量化 Q5 k p,kv f16拉满。这很反直觉。我一开始也是被很多人误导,一直为了提速,用 q4 以下的量化模型,甚至尝试了三元量化的垃圾 baosai2,kv 也是 q8/q4,速度一直提不起来,优化也到了硬件上限。直到昨晚看到一款模型和作者的说明,才发现不牺牲质量,只降噪,在特定参数下,质量最好,性能最高,作者是 3090 卡,我是 v100,但亲测可行,这就是垃圾卡但大显存的好处,Q5 f16,看着都爽。
顺便提一下,llama cpp 是用的最新的 master 编译的,性能更好,比官方 5.0 还要新,针对 sm70 编译的。
关于作者的量化方法,去看他的 model card,有很多细微参数,我略微调整了一下。
配置及参数:
27B 脚本结构(sm70-master 构建、-ngl 65 全量 offload、-sm layer -ts 1,2,1 -mg 1 三卡 16:32:16、端口 8086、threads 16、batch 8192/4096、MTP draft)
set LLAMA=C:\llama.cpp\llama-sm70-master\llama-server.exe
set MODEL=D:\models\LuffyTheFox\Qwen3.8-27B-Uncensored-Genesis-MTP-GGUF\Qwen3.8-27B-Uncensored-Genesis-Q5_K_P.gguf
set MMPROJ=D:\models\LuffyTheFox\Qwen3.8-27B-Uncensored-Genesis-MTP-GGUF\mmproj-Qwen3.8-27B-Uncensored-Genesis-BF16.gguf
set NGL=65
set CTX=262144
set KV=f16
set KV_V=f16
set PORT=8086
set THREADS=16
set TEMP=0.9
set TOP_P=0.95
set TOP_K=20
set MIN_P=0.0
set SEED=42
set REPEAT=1.05
set BATCH=4096
set UBATCH=2048