斯坦福:10分钟真机数据,42%到97%
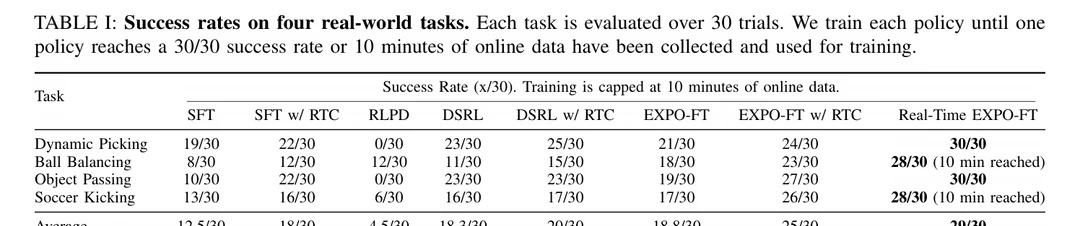
斯坦福这篇(Real-Time EXPO-FT)把 π0.5 的推理延迟当成强化学习里的建模问题处理:VLA 在后台异步采多条候选动作块,一个轻量编辑策略拿最新一帧改一遍,再由 critic 挑一条执行。四个真机动态任务,每个评测 30 次,在线机器人数据卡在 10 分钟,从 12.5/30 做到 29/30;仿真 Kinetix 上它带 4 步延迟还比零延迟的 RLPD 高 15 个点。完整的内容都排在图里了。
人工智能 机器人 具身智能 VLA