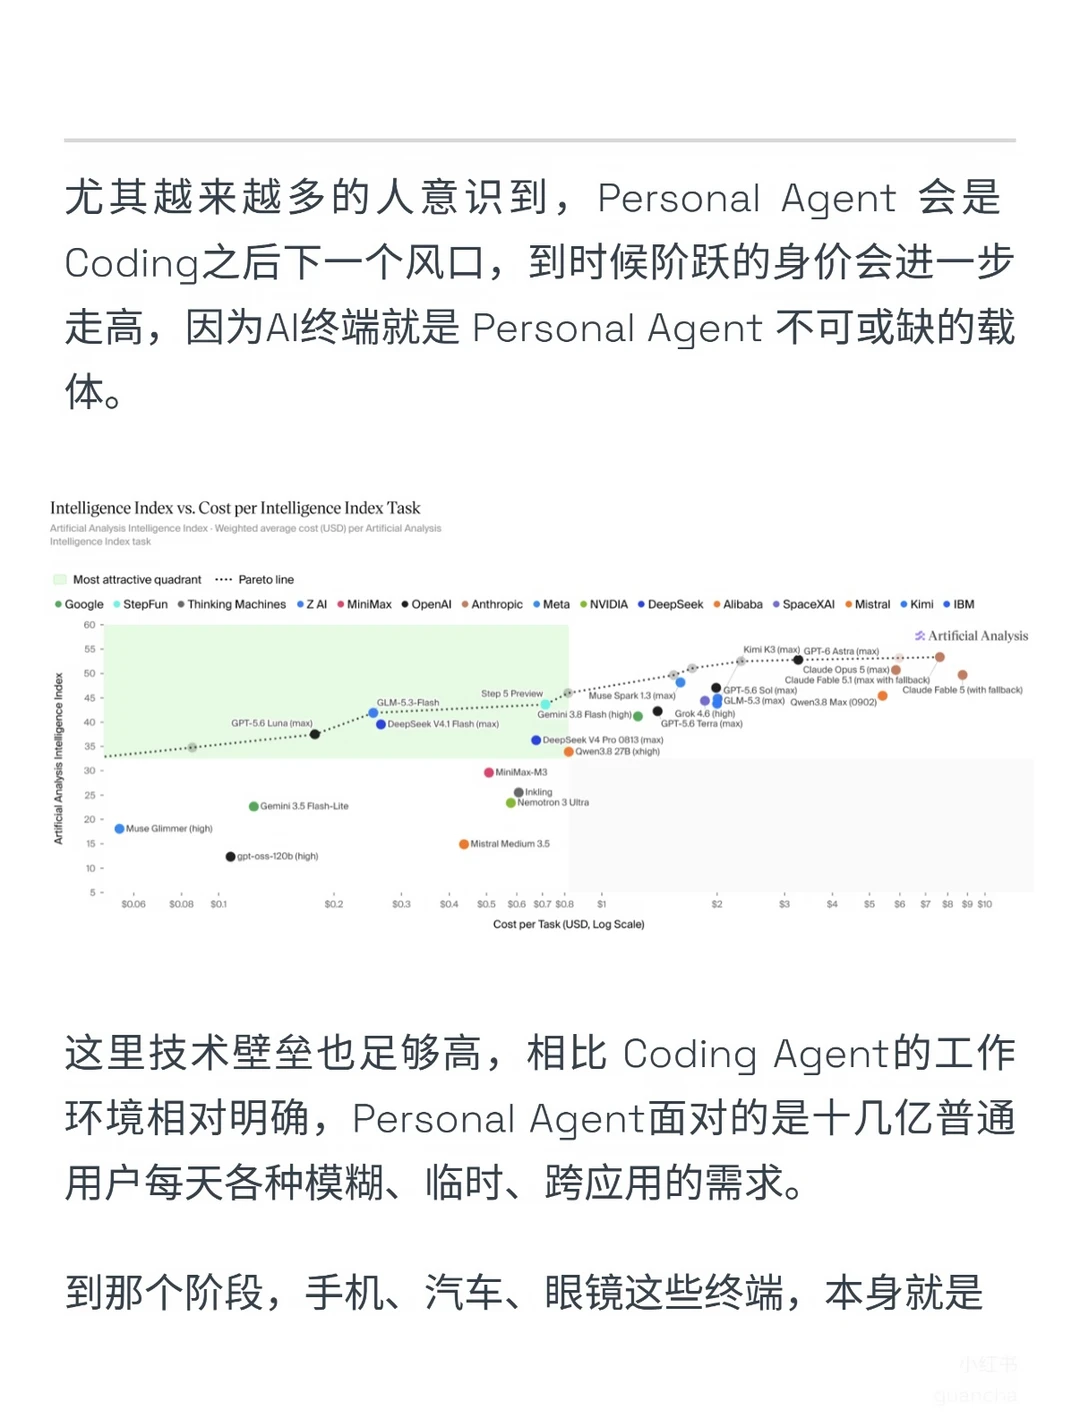
这两天,Artificial Analysis上突然出现了一款Step 5 Preview。
模型厂商写的是StepFun,也就是阶跃星辰。
我第一反应是:阶跃这次终于把新的旗舰基模端上来了。
过去几个月国产大模型更新很密,阿里、智谱、Kimi几家轮番刷榜,很多人问阶跃在干嘛呢?
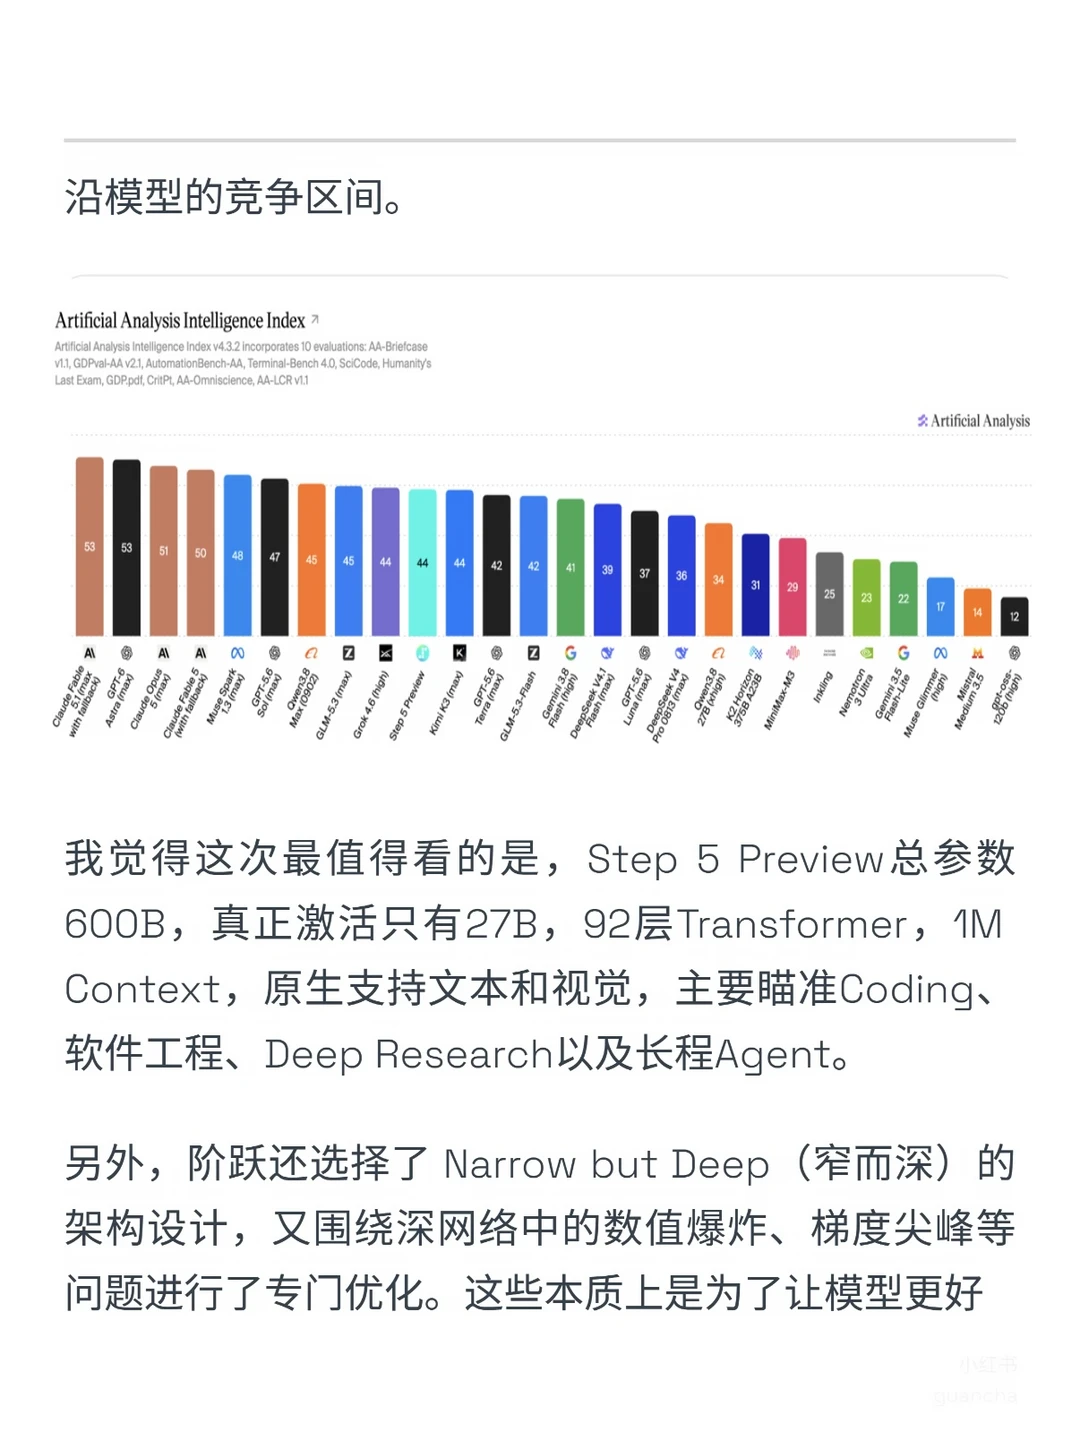
结果Step 5 Preview一出来,直接在Artificial Analysis Intelligence Index拿到44分,进入全球前沿模型的竞争区间。
我觉得这次最值得看的是,Step 5 Preview总参数600B,真正激活只有27B,92层Transformer,1M Context,原生支持文本和视觉,主要瞄准Coding、软件工程、Deep Research以及长程Agent。
另外,阶跃还选择了 Narrow but Deep(窄而深)的架构设计,又围绕深网络中的数值爆炸、梯度尖峰等问题进行了专门优化。这些本质上是为了让模型更好地处理复杂 Agent 任务,把算力尽量花到真正需要的地方。
看这个配置会发现,阶跃这次没有继续追“参数越大越好”。
它更像是在回答Agent时代一个越来越现实的问题:
模型能不能在一个复杂任务里一直聪明下去,同时别贵得离谱。
这种东西听着没Benchmark刺激,但其实更接近现在生产级Agent真正遇到的问题。
因为Agent和聊天机器人完全是两种工作负载。
问一个问题,模型算几十秒就结束了。
但一个Deep Research或者软件工程任务,可能要连续跑很久,中间搜索几十次、调用工具、读新资料、改方案,前面的信息还不能忘。
Agent时代真正难的,已经不是某一瞬间有多聪明,而是能不能聪明很久。
阶跃还专门拿金融做了一轮压力测试。
这个场景挺适合验模型。
公司研究不是读完一份财报就结束了,还得搜最新信息、核来源、理解行业、建预测模型、做估值,任何一步出了问题,后面的结论都可能跟着跑偏。
所以他们自己做了Live Search、Corporate Valuation、Deep Research三套评测,又跑了外部的FrontierFinance。
按照阶跃给出的结果,Step 5 Preview在四项测试里的表现都接近Claude Opus 5。
我觉得这里真正想证明的,也不是“我们又赢了谁”。
(更多内容见上文)
#阶跃星辰 #StepFun #Step5Preview #阶跃大模型场景 #Agent #AICoding