Qwen3.8 27B 又进化:16GB装进192k上下文
榨干设备howto
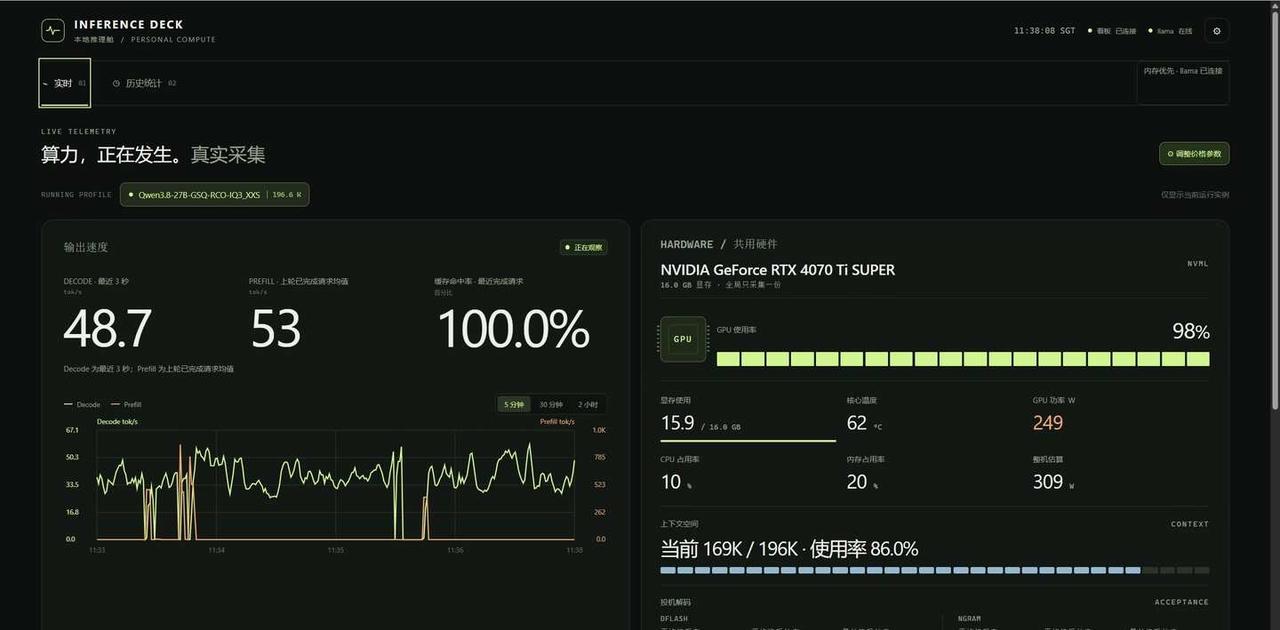
稳定配置
Qwen3.8-27B
GSQ-RCO IQ3_XXS
约 3.0 bpw
Context:196,608
KV:Q4 / Q4
DFlash2:Q2_K
Speculative:n_max 4
ngram-mod:开启
GPU:4070 Ti Super 16GB
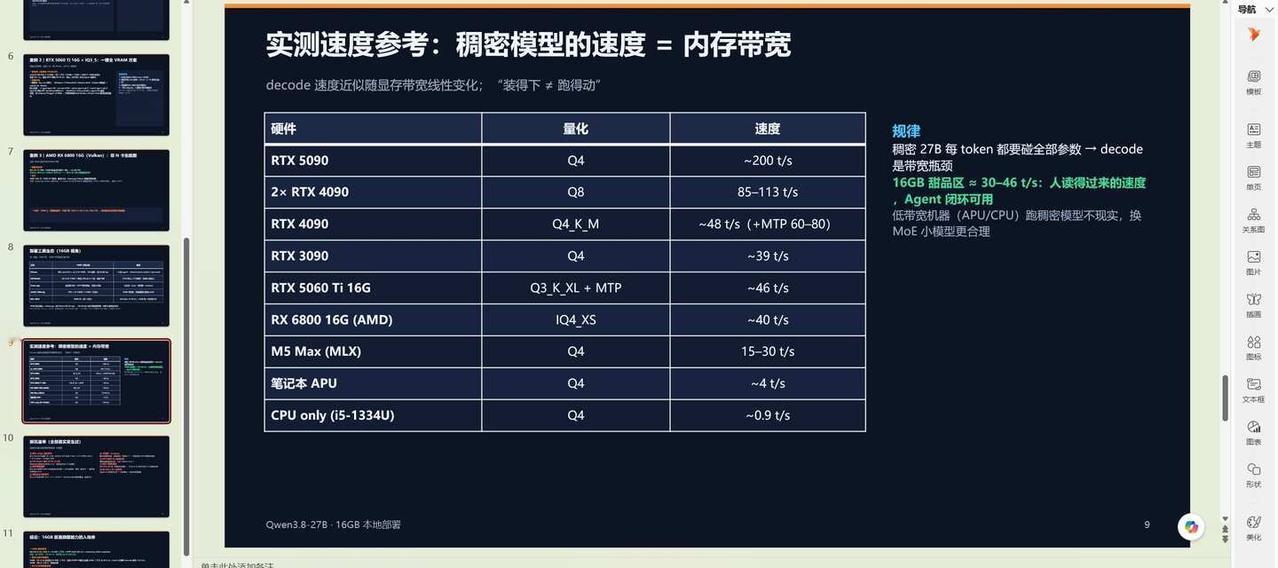
近极限长上下文生成速度大约:37~40 tok/s
中等上下文长时间生成,大概还能维持:56~66 tok/s
Prompt prefill 最快可以到:1500 tok/s+,满上下文也800tok/s左右。
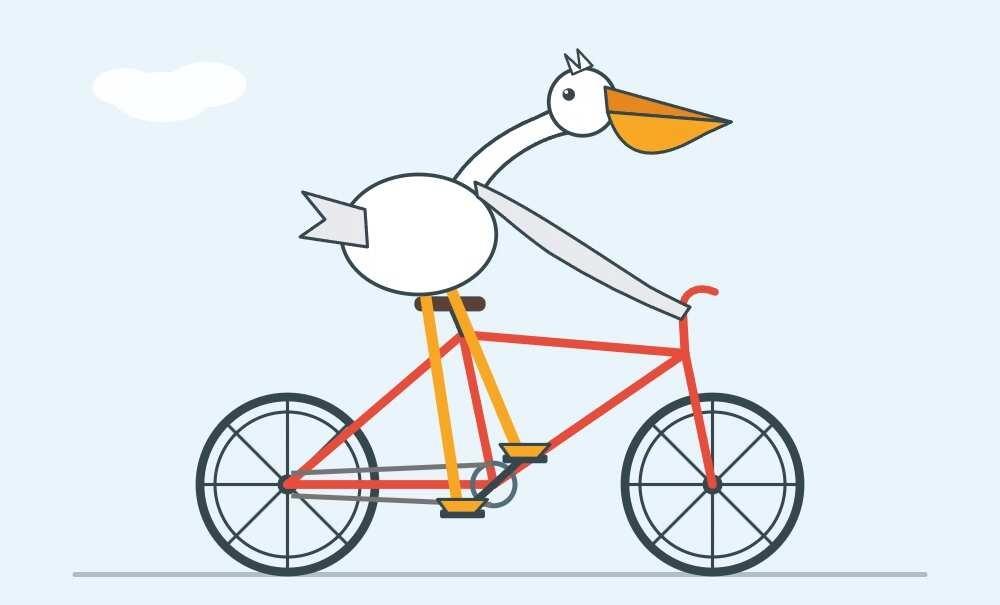
One shot 鹈鹕自行车还不错。
在Chatgpt的 Chat(Astra)指导下写项目级的代码也是可以的,爽点在于可以连夜狂蹬。
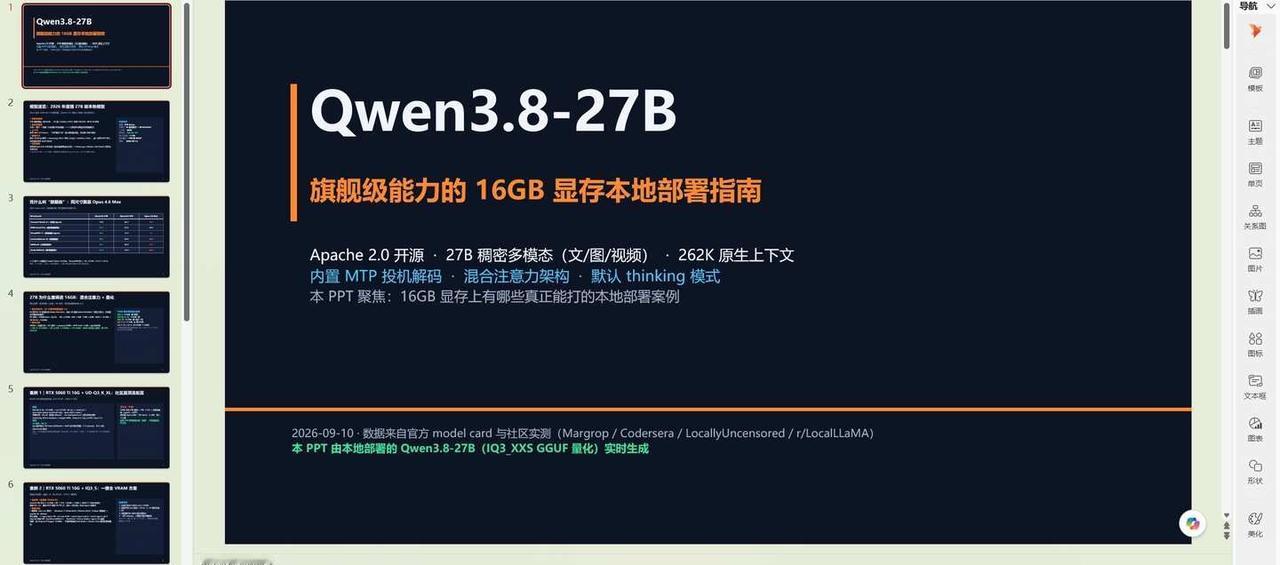
用Opencode一句话提示词做网络搜索+做PPT也挺好,估计Agent任务也没啥问题,估计就是世界知识不够需要重度依赖网络搜索吧。
另外如果有API 模型指导,那thinking可以开Medium或者Low,不然拜动辄十几K长度的thinking加持下,每M输入对应的输出会高的非常离谱。
应评论区多次要求,我把模型和草稿以后的启动参数放在这里,供大家参考:
-c 196608 -ngl 999 -np 1 -b 1024 -ub 256 -fa on \
--cache-type-k q4_0 --cache-type-v q4_0 \
--spec-type draft-dflash,ngram-mod \
--spec-draft-n-max 4 \
--spec-draft-type-k q4_0 --spec-draft-type-v q4_0 \
--spec-draft-ngl all --spec-draft-device CUDA0 \
--spec-ngram-mod-n-match 24 \
--spec-ngram-mod-n-min 48 \
--spec-ngram-mod-n-max 64 \
--reasoning-budget 10240 \
--reasoning-budget-message 'Stop reasoning now. Emit the next tool call or final answer.' \
本地部署 qwen llm