用 GPT-6 做长任务,想给 Codex 省点 token,可以试试新的实验上下文模式。
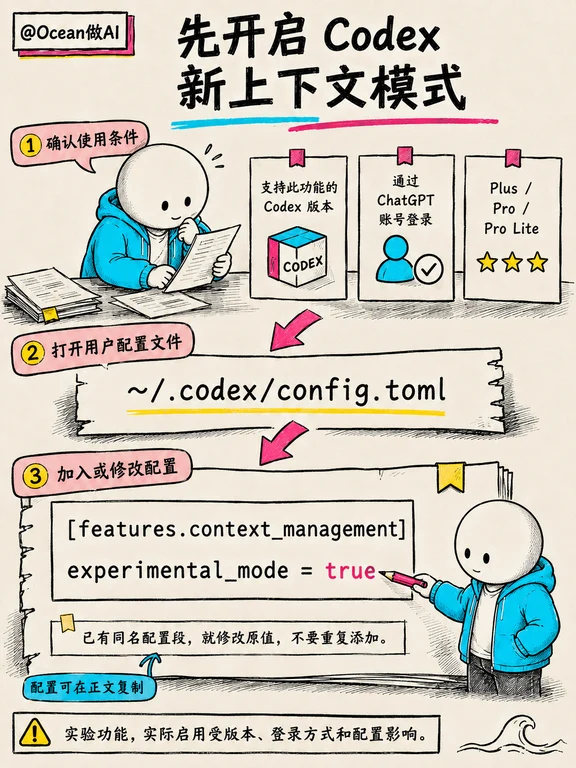
把这段发给 Codex:
帮我开启 Codex 的实验上下文模式。先检查当前版本和登录方式是否支持,再读取用户级 config.toml,合并以下配置:
[features.context_management]
experimental_mode = true
已有同名配置就修改原值,保留其他设置。改完回读,告诉我是否需要重启;配置写入成功和实际生效要分开说明。
官方目前列出的条件:Plus、Pro 或 Pro Lite,通过 ChatGPT 账号登录。
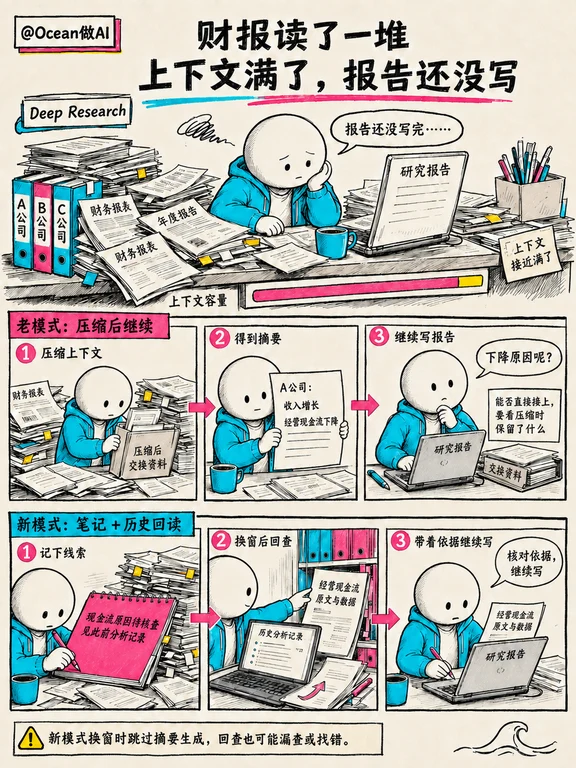
拿 Deep Research 读财报举例。
AI 比较几家公司的收入、利润和现金流,材料越读越多,报告没写完,窗口先满了。
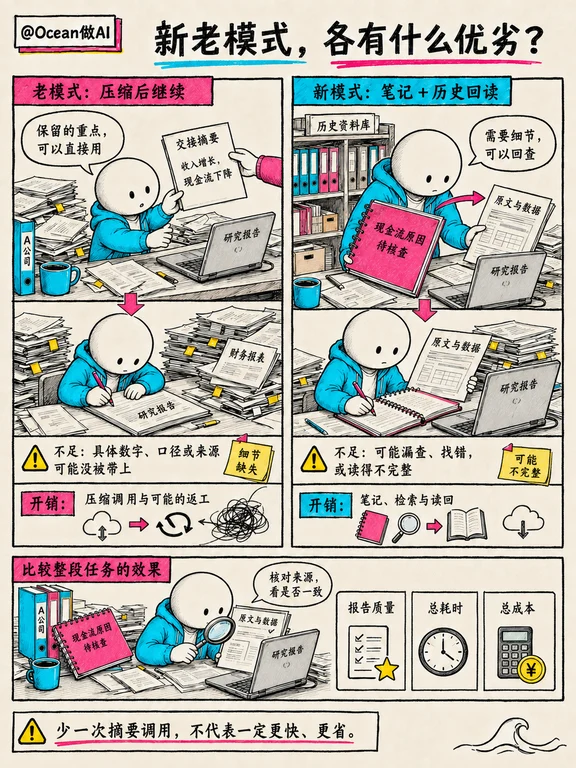
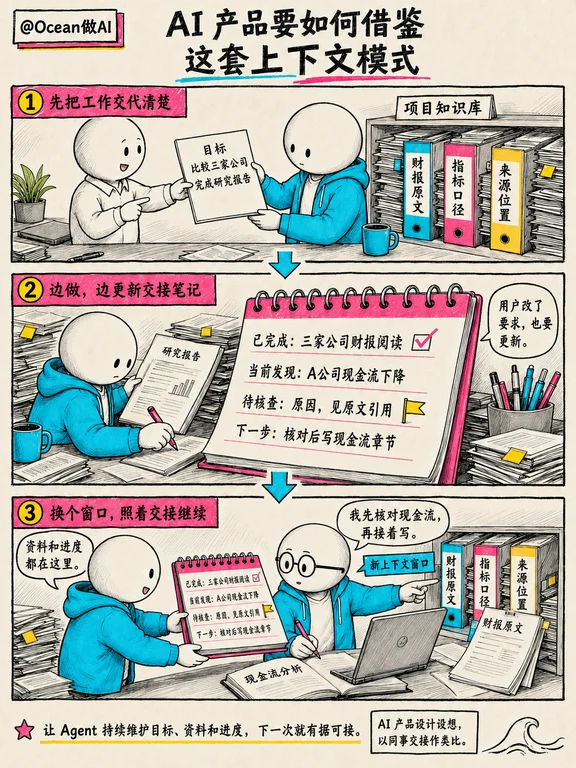
原有 compact 会把上下文压缩成更小的表示,再继续。交接材料可能留下“A 公司收入增长,经营现金流下降”。后面要核对下降原因、金额和报告期,保留了就接着用,没保留就得补查。
新模式让 AI 边工作边维护笔记,记录发现、未决问题和资料线索。换窗后,按线索回读历史,再接着做。
它跳过了换窗时的摘要生成,也留了细节回查入口。但仍可能漏查、找错,笔记和检索也花 token。我还没做完整对照,省多少不能先报数。
做 AI 产品,我更想借鉴这种交接。
今天做一半,明天继续。假设相关缓存已过期,再处理整段长历史,未命中的输入就享受不到缓存读取优惠;调用模型压缩这段历史,也要付处理成本。
自己的产品可以给 Agent 一本持续更新的项目记事本:目标和约束是什么,资料在哪里,做到了哪步,哪些判断还没证实,下一步查什么。
第二天准备一个新窗口,先读交接记录,再取当前需要的资料,就有机会减少整段历史的重复输入。这是产品借鉴,Codex 没有承诺隔天自动开新对话。
我觉得,AI 产品的上下文设计,会越来越依赖 Agent 自动维护结构化工作记录。像同事交接一样,既能更新进度,也能识别过期内容,换窗口、换 Agent,工作才接得下去。
#Codex #Agent #AI产品经理 #人工智能