一篇标题党论文,让微软成 AI 圈反面教材
微软 Applied Sciences Group 的一篇论文,最近因为标题在 AI 圈引发争议。
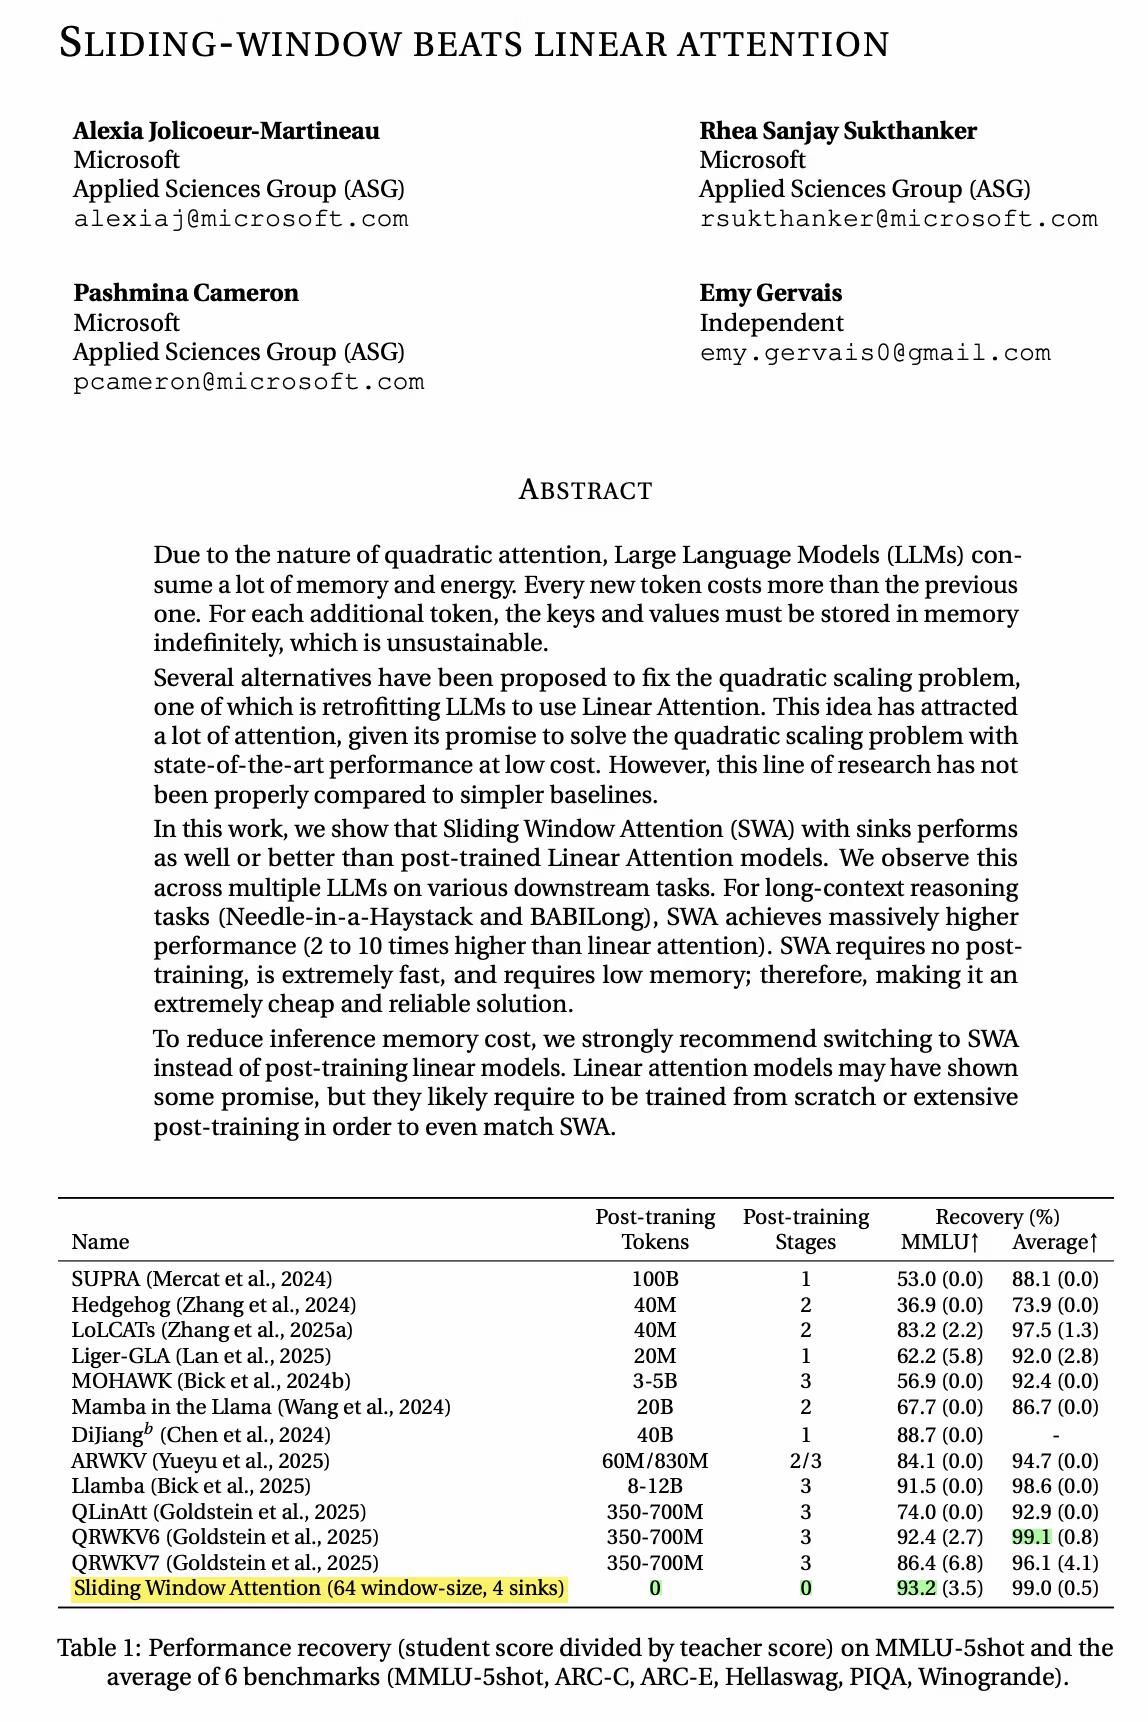
论文叫《Sliding-window beats linear attention(滑动窗口注意力打败线性注意力)》。
乍看之下,它像是在宣布一个很绝对的结论:滑动窗口注意力,全面赢过线性注意力。
但论文实际比较的并不是两种架构从头训练后的正面对决。
它研究的是把一个已经预训练好的标准 Transformer,几乎零成本地改成“滑动窗口注意力 + Attention Sinks”,与那些需要在后训练阶段进行改造、把模型 retrofit 成线性注意力的方案相比,谁在长上下文任务上更合适。
结果是很有价值的,前者在一些任务上更快、更省显存,效果也可能高出 2 到 10 倍。
问题在于这个标题上,省掉了最关键的限定词:in post-training。
这不是“滑动窗口注意力全面打败线性注意力”,而更接近于:对于已预训练模型的后训练改造,简单改 mask 的滑动窗口方案,可能优于把模型重新改造成线性注意力。
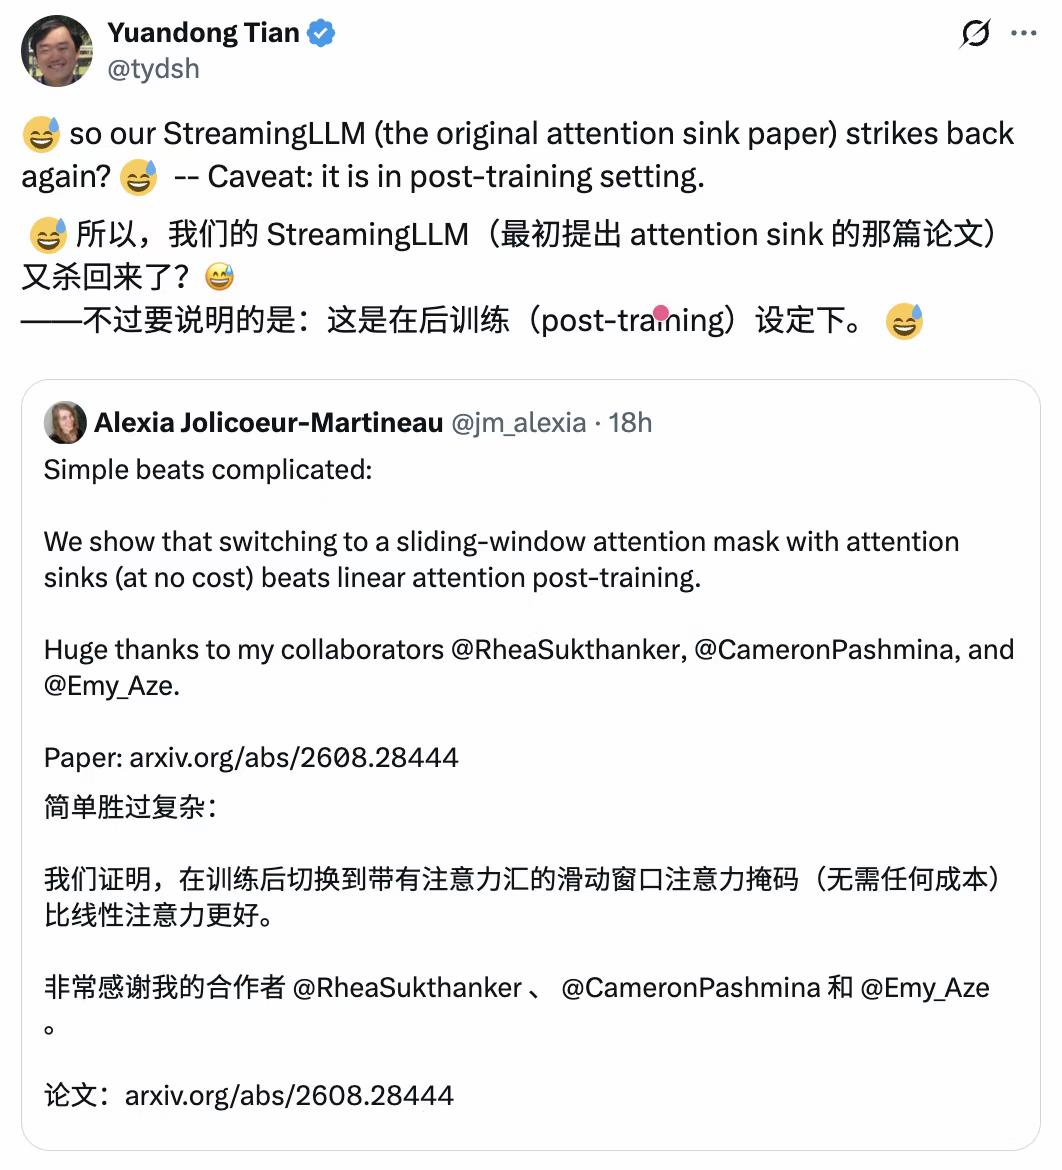
挺有意思的是来自田渊栋的转评,作为 2023 年论文《Efficient Streaming Language Models with Attention Sinks》的合著者,StreamingLLM 和 Attention Sinks 正是他与团队共同提出并推广的技术路线。
看到新论文后,他转评道:“所以,我们的 StreamingLLM 又杀回来了?——不过要说明,这是在 post-training 设定下。”
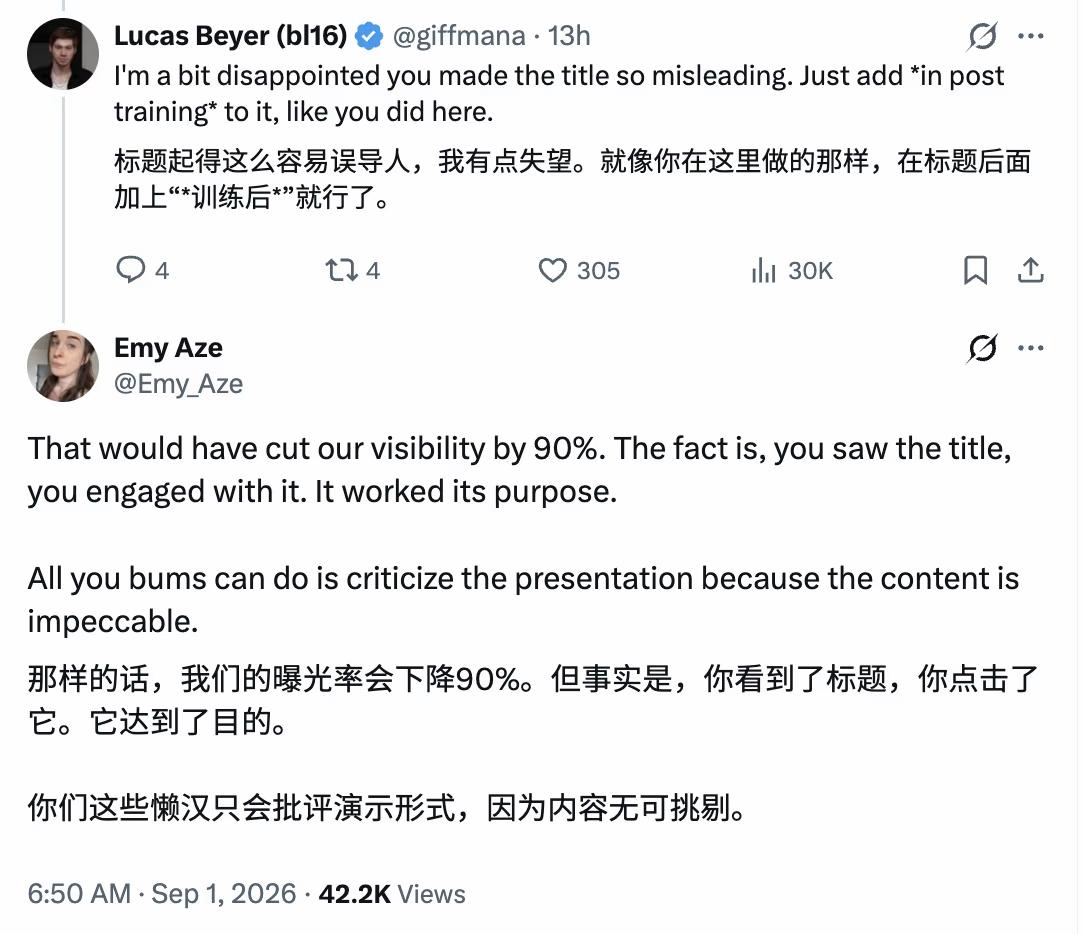
所以包括 Lucas Beyer 在内的研究者指出,这样的标题会让社区误读实验范围,至少应该把限定条件写上。
更搞笑的事合著者 Emy Aze 没有否认这是有意为之。甚至承认是故意为之:如果加上“in post-training”,曝光会少 90%;但你们看到了标题、参与了讨论,所以它达到了目的。
于是,争议不再只是论文结论,而是研究共同体的底线。
一篇可能有参考价值的 baseline 对比,是否可以为了传播,把最重要的实验边界藏进正文?
论文可以追求传播,但学术标题首先该交代边界。否则,一篇原本值得讨论的 baseline 对比,也会因一句刻意省略的标题,变成 AI 圈的反面教材。
AI 人工智能 大模型 Transformer Attention